

Python asyncio中怎么初始化多个异步队列
深入讲解在Python asyncio中规范初始化多个异步队列的方法与最佳实践,涵盖字典推导、列表推导、类封装、事件循环绑定时机及完整并发管道示例。
在 Python asyncio 中初始化多个异步队列,标准做法是在已启动的事件循环内部(通常在 async def main() 或异步应用的生命周期钩子中),通过字典推导式或列表推导式批量实例化 asyncio.Queue,并显式指定 maxsize 参数限制缓冲容量以提供背压支持。
一、为什么需要初始化多个异步队列?
在并发网络请求、日志处理、流式数据解析或高并发爬虫等典型场景中,单一的 asyncio.Queue 往往无法满足复杂的流水线协作需求。初始化多个异步队列通常服务于以下三种系统架构:
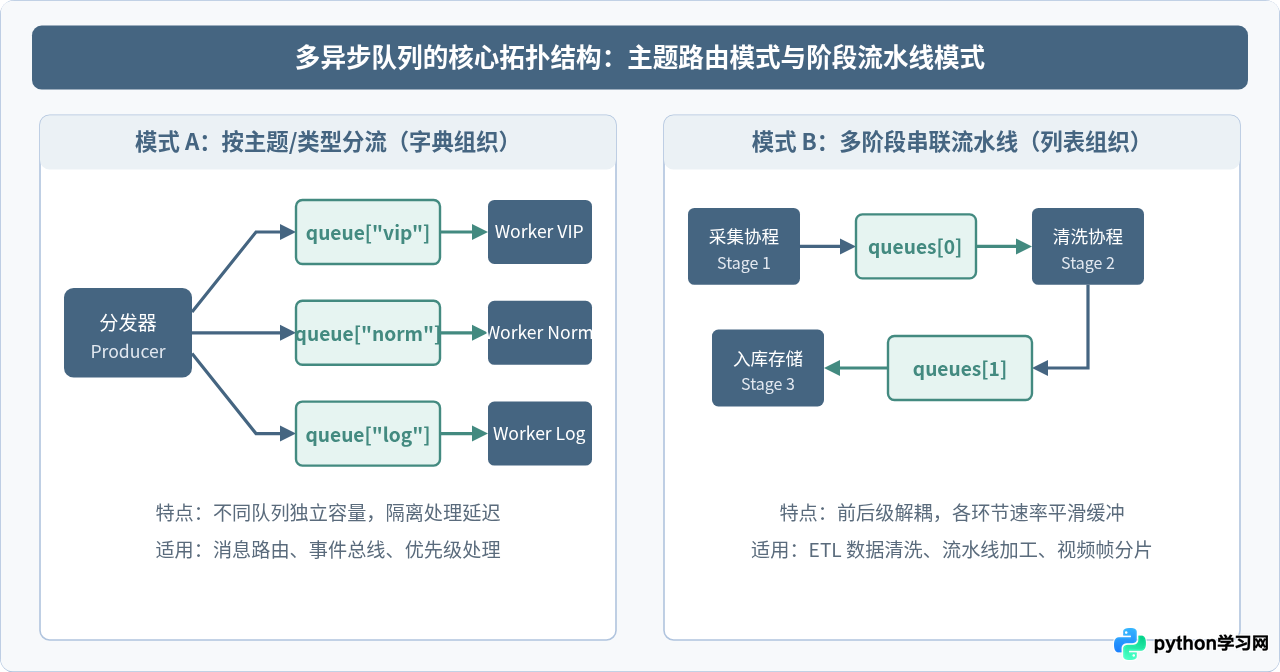
- 通道分流(Topic / Channel Routing):系统按消息主题或数据等级(例如:高优先任务、普通任务、审计日志)将请求分流到不同的专有队列中,由不同并发规模的消费者各自独立消费。
- 多阶段流水线(Staged Pipeline):将整体业务拆分为“数据抓取”、“数据清洗”、“持久化入库”等多个串联阶段,各阶段之间通过独立的队列衔接,使得上下游协程互不阻塞。
- 工作节点池负载均衡(Worker Isolation):为特定工作组或第三方受限接口分别配置独立队列,防止某个下游慢请求阻塞全局其他通道。
二、初始化多个异步队列的三种常用代码写法
组织多个队列的常见数据结构有三种:字典(推导式)、列表(推导式)以及强类型类封装。读者应根据队列是“按名称查找”还是“按阶段顺序流转”来选择合适的初始化方式。
1. 字典推导式:基于主题名或类型批量创建
当队列代表不同频道、业务主题或优先级时,使用字典存储最为直观。可以通过键名快速检索对应队列并推送数据:
import asyncio

async def init_topic_queues(topics: list[str], max_size: int = 100) -> dict[str, asyncio.Queue]:
    # 使用字典推导式为每个主题初始化独立的异步队列
    return {topic: asyncio.Queue(maxsize=max_size) for topic in topics}

async def main():
    channels = ["telemetry", "alerts", "orders"]
    # 在运行中的事件循环内初始化
    queues = await init_topic_queues(channels, max_size=50)

    # 存入与取出示例
    await queues["alerts"].put({"level": "warning", "msg": "CPU load high"})
    alert_item = await queues["alerts"].get()
    print("获取到警报:", alert_item)

if __name__ == "__main__":
    asyncio.run(main())
2. 列表推导式:基于工序或分片数量批量创建
如果业务属于多阶段流水线,或者需要按照分片 ID 均匀分配给固定数量的工作者(Worker),使用列表索引最为紧凑:
import asyncio

async def main():
    num_stages = 3
    # 批量初始化3个阶段的连续队列,各阶段可独立设置容量
    pipeline_queues = [asyncio.Queue(maxsize=200) for _ in range(num_stages)]

    # queues[0] -> Stage 1, queues[1] -> Stage 2, queues[2] -> Stage 3
    await pipeline_queues[0].put("raw_record_01")
    print(f"初始化了 {len(pipeline_queues)} 个队列,首阶段待处理项: {pipeline_queues[0].qsize()}")

asyncio.run(main())
3. 自定义容器封装:具备明确生命周期的结构化管理
在中大型应用中,推荐将多个队列打包封装在一个数据类或服务管理器中,提供统一的启动、分发和关闭方法,避免全局变量污染:
import asyncio
from dataclasses import dataclass

@dataclass
class ServiceQueues:
    high_priority: asyncio.Queue
    normal_priority: asyncio.Queue
    audit_log: asyncio.Queue

    @classmethod
    def create(cls, capacity: int = 100) -> "ServiceQueues":
        # 工厂方法:在协程中一次性创建所属成员队列
        return cls(
            high_priority=asyncio.Queue(maxsize=capacity),
            normal_priority=asyncio.Queue(maxsize=capacity * 2),
            audit_log=asyncio.Queue(maxsize=capacity * 5),
        )

async def main():
    queues = ServiceQueues.create(capacity=50)
    await queues.high_priority.put("URGENT_TASK")
    print("高优先队列当前大小:", queues.high_priority.qsize())

asyncio.run(main())
三、初始化与编排多队列的四步标准化流程
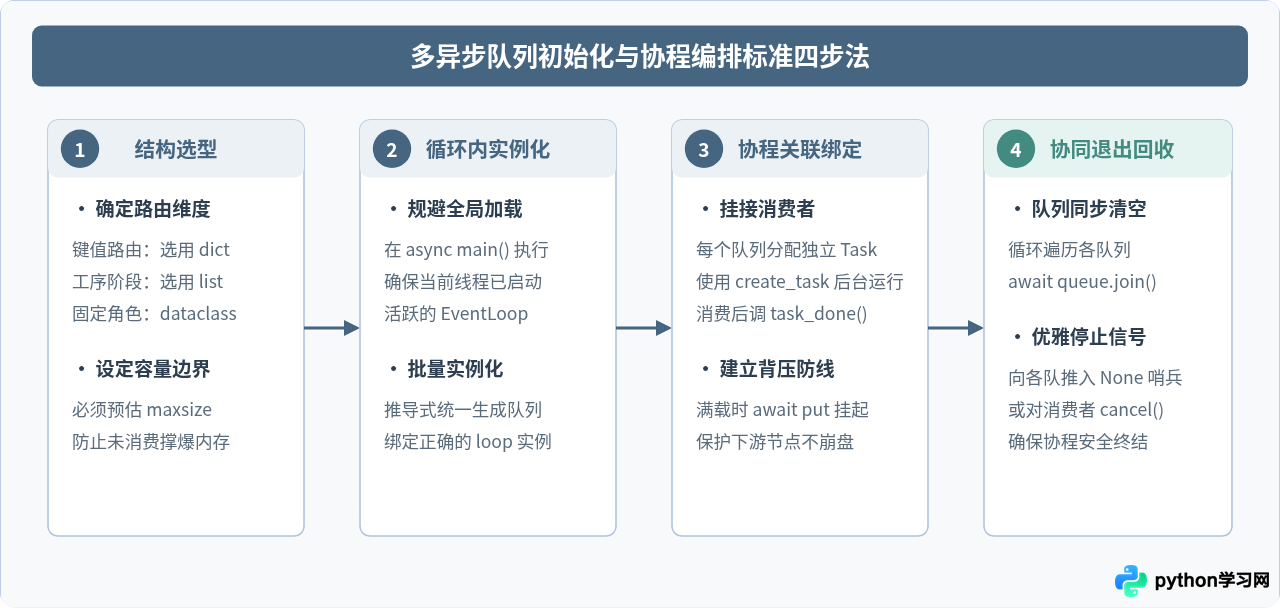
初始化多个异步队列不仅仅是调用几次构造函数,还需要配合协程任务生命周期、背压限制和安全退出机制。下图展示了从定义容器到完成安全回收的标准流程:
四、关键避坑点:事件循环绑定时机与生命周期
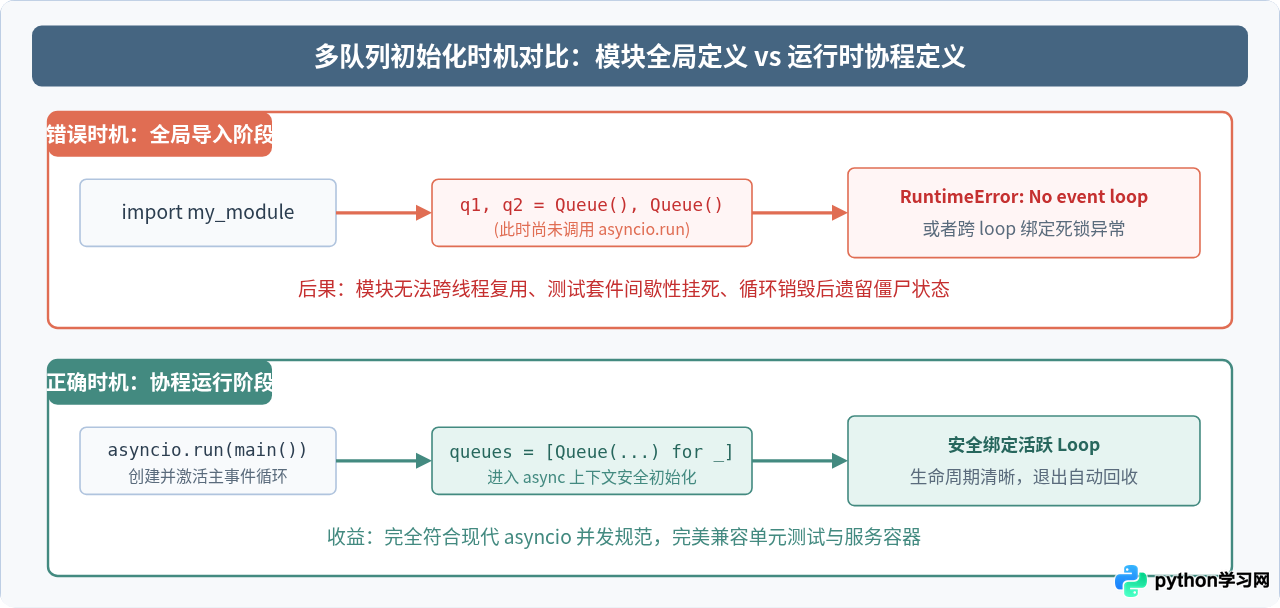
很多初学者容易习惯性地在 Python 脚本顶层写下全局变量:
# 错误示例:不要在模块全局变量中直接初始化队列!
import asyncio

queue_a = asyncio.Queue()  # 危险!
queue_b = asyncio.Queue()  # 危险!

async def main():
    await queue_a.put(1)
在 Python 3.10 之前的版本中,如果直接在全局作用域调用 asyncio.Queue(),Python 会尝试调用 asyncio.get_event_loop() 来获取循环。若此时事件循环尚未创建,会立即抛出:
RuntimeError: There is no current event loop in thread 'MainThread'.而在 Python 3.10 及更新版本中,虽然 asyncio.Queue 的 loop 参数被正式移除,并在底层延迟绑定(首次调用 _get_loop() 时绑定当前运行的循环),但如果你的代码被测试框架、多线程服务或以不同入口重复调用 asyncio.run(),顶层常驻的 Queue 对象依然会保留上一个已经关闭的旧 loop 引用,从而引发无法预测的死锁或崩溃。
五、完整实战:多队列消息路由与优雅退出示例
下面是一个工业级、可直接执行的完整案例。演示了一个分发器如何根据消息类型,将数据投递至多个并行的专有队列,且各类别的消费者协程独立处理,并在全部完成后安全退出:
import asyncio
from typing import NamedTuple

class Message(NamedTuple):
    channel: str
    payload: str

# 消费者协程:针对单一特定队列进行处理
async def consumer(name: str, queue: asyncio.Queue):
    print(f"[消费者-{name}] 启动就绪...")
    while True:
        item: Message | None = await queue.get()
        # 约定用 None 作为终止信号(Sentinel)
        if item is None:
            queue.task_done()
            print(f"[消费者-{name}] 接收到停机信号,平稳退出。")
            break

        try:
            # 模拟业务异步耗时
            await asyncio.sleep(0.05)
            print(f"[消费者-{name}] 处理完成 -> 通道: {item.channel}, 内容: {item.payload}")
        finally:
            # 必须调用 task_done 保证 join() 能够正常返回
            queue.task_done()

# 生产者/分发器协程:将不同消息分配至不同队列
async def dispatcher(queues: dict[str, asyncio.Queue], messages: list[Message]):
    for msg in messages:
        target_queue = queues.get(msg.channel)
        if target_queue:
            # 当队列满时,put 会在此安全等待(触发背压保护)
            await target_queue.put(msg)
            print(f"-> [分发器] 已投递消息至 [{msg.channel}] 队列")
        else:
            print(f"! [分发器] 未知通道: {msg.channel},丢弃消息")

async def main():
    channel_names = ["order", "payment", "notification"]

    # 步骤 1 & 2:在运行中的事件循环中,使用字典推导批量初始化队列
    # 每个队列设置独立的 maxsize
    queues: dict[str, asyncio.Queue] = {
        name: asyncio.Queue(maxsize=10) for name in channel_names
    }

    # 步骤 3:为各个队列启动对应的后台消费任务
    consumer_tasks = []
    for name, q in queues.items():
        task = asyncio.create_task(consumer(name, q))
        consumer_tasks.append(task)

    # 准备测试消息数据集
    test_data = [
        Message(channel="order", payload="订单编号 #1001"),
        Message(channel="payment", payload="支付回调 $99.00"),
        Message(channel="notification", payload="短信验证码通知"),
        Message(channel="order", payload="订单编号 #1002"),
        Message(channel="payment", payload="支付退款请求"),
    ]

    # 分发数据
    await dispatcher(queues, test_data)

    # 步骤 4:优雅关闭流程
    # 4.1 等待所有队列中的已有数据被全部处理完成
    print("\n--- 正在等待所有队列任务完成 ---")
    await asyncio.gather(*(q.join() for q in queues.values()))

    # 4.2 向每个队列投递 None 终止哨兵,通知消费者退出循环
    for q in queues.values():
        await q.put(None)

    # 4.3 等待所有消费任务干净结束
    await asyncio.gather(*consumer_tasks)
    print("--- 所有异步队列及工作协程已成功关闭 ---")

if __name__ == "__main__":
    asyncio.run(main())
六、关键最佳实践与选型总结
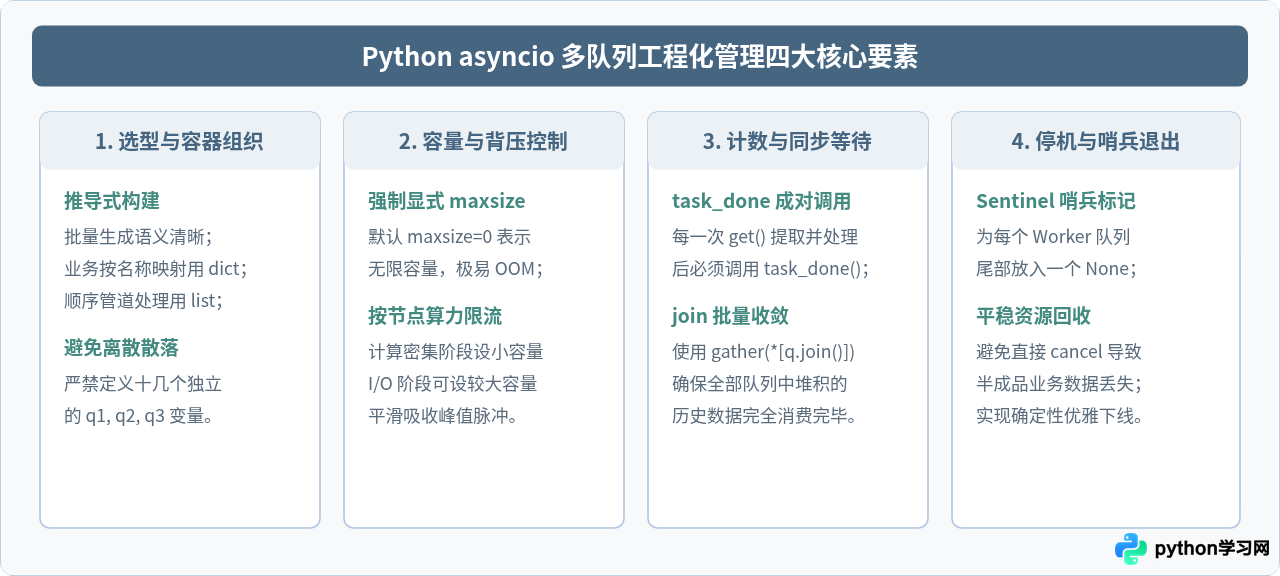
为了让系统在面对大量并发流量时依然稳定可靠,管理多个异步队列时建议严格遵循以下四项原则:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









