Python爬虫数据保存至本地文件的简易实现
本文介绍使用Python编写简易爬虫并将抓取的数据保存至本地文件的方法。通过urllib获取网页内容,利用正则表达式提取图片链接,最后将图片保存至指定本地目录。文章基于Python 3.5环境,重点讲解了文件存储的实现细节及正则匹配的注意事项,适合初学者参考。
2026-10-13
5

本文介绍使用Python编写简易爬虫并将抓取的数据保存至本地文件的方法。通过urllib获取网页内容,利用正则表达式提取图片链接,最后将图片保存至指定本地目录。文章基于Python 3.5环境,重点讲解了文件存储的实现细节及正则匹配的注意事项,适合初学者参考。
本文详细介绍Python爬虫框架Scrapy的基础使用,涵盖环境安装、项目创建及目录结构解析。通过一个具体的题库抓取案例,演示如何编写Spider、定义Items、配置Pipeline以及处理数据库存储,帮助开发者快速掌握Scrapy的核心流程与代码实现。
本文详解Python爬虫中URL管理器的实现方法,重点解析如何利用collections模块中的deque双向队列高效维护待抓取与已抓取URL集合。通过示例代码展示如何判断URL存在性、执行去重逻辑及防止页面跳转死循环,为构建稳定爬虫系统提供核心组件参考。
本文详细解析使用Docker部署Python爬虫项目的完整步骤。内容涵盖Docker环境安装、基础镜像拉取、Python运行环境编译、依赖库处理、Dockerfile编写规范、镜像构建命令及容器启动参数配置,帮助开发者实现爬虫项目的标准化与自动化部署。
本文详解如何在Python Scrapy框架中实现数据的异步MySQL存储。通过引入twisted.enterprise.adbapi创建数据库连接池,结合自定义Pipeline与from_settings方法,将爬虫抓取与数据库写入解耦。文章包含settings配置、Item定义、Pipeline实现及错误处理机制,确保高并发爬虫场景下的数据完整性与写入效率。
本文详细介绍如何使用Python编写一个集网页爬虫与SQL注入检测于一体的插件。通过构建多线程爬虫管理URL,利用布尔盲注Payload对比页面响应差异来检测注入点,并结合正则表达式识别数据库类型。文章提供完整的代码结构、依赖库安装及核心逻辑解析,适用于安全研究人员进行自动化漏洞扫描开发。
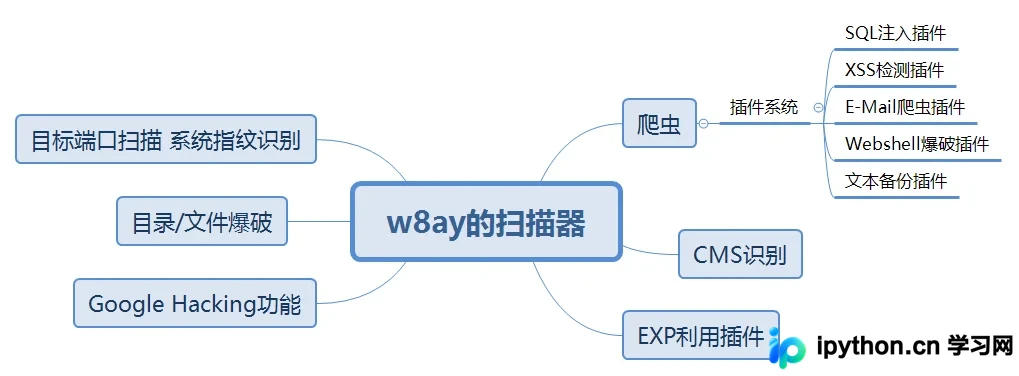
本文详细解析利用Python爬虫技能实现经济收益的两种主要路径。针对在校大学生,建议从少量数据抓取入手,掌握基础库、HTML解析及存储技术,避免承接高风险监控或大规模项目。对于在职IT人员,凭借丰富的工程经验与流程熟悉度,可挑战大规模抓取、监控及移动端模拟登录等高收益任务。文章提供了针对性的技术建议与项目选择策略,帮助不同阶段的技术人员合理评估难度与收益。
本文详解Python爬虫中BeautifulSoup的异常处理机制,涵盖HTTPError捕获404/500错误、空网页判断及AttributeError处理缺失标签。通过完整代码示例,展示如何编写健壮的爬虫程序,避免程序崩溃,提升代码健壮性。
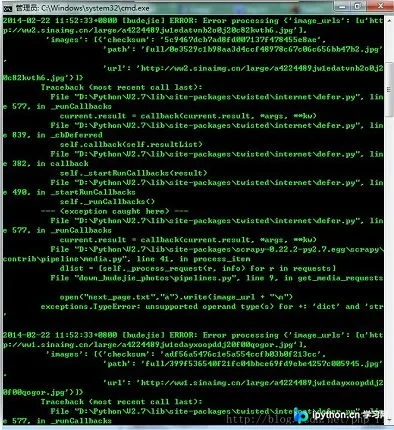
本文介绍如何在Windows环境下使用Scrapy框架时,将控制台打印的运行及调试信息保存至文本文件。通过指定LOG_FILE参数,解决CMD窗口信息滚动导致无法查看完整日志的问题,便于后续排查爬虫运行中的错误或调试细节。
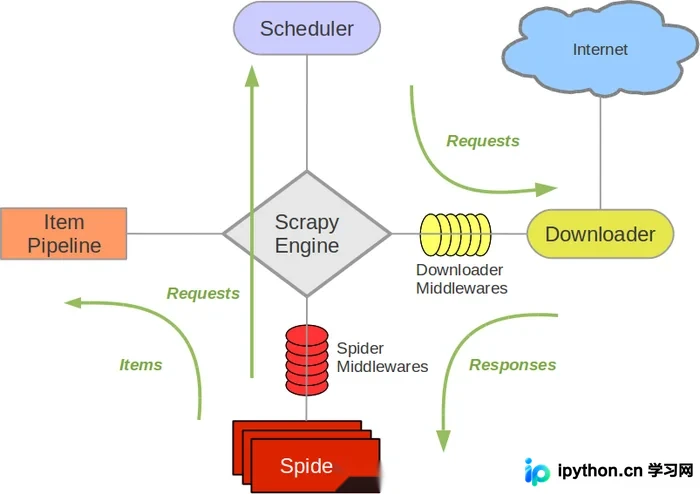
本文深入解析Scrapy框架的核心组件,包括引擎、调度器、下载器、Spider及管道等,并详细阐述数据在系统中的流动机制与处理流程,帮助开发者理解Scrapy的工作逻辑。
本文详细解析Python中urllib标准库与第三方库urllib3的区别。urllib包含request、parse、error和robotparser四个模块,适用于基础网络请求。urllib3功能更强大,支持连接池、线程安全、代理及SSL验证。文章通过代码示例对比两者在GET/POST请求、Cookie处理、代理设置、文件上传及超时处理上的具体用法,帮助开发者根据需求选择合适的库。
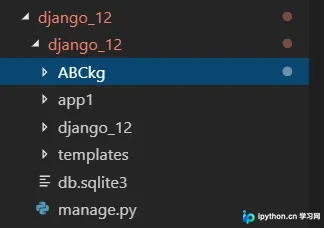
本文详细讲解如何在Django项目中创建并运行Scrapy爬虫,实现数据抓取后直接存入Django数据库。通过配置settings.py、编写爬虫逻辑、利用scrapy-djangoitem将Item映射为Django模型,并在Pipeline中调用save()方法,最终在Admin后台查看结果。