Python Scrapy框架结构详解:从组件到数据流
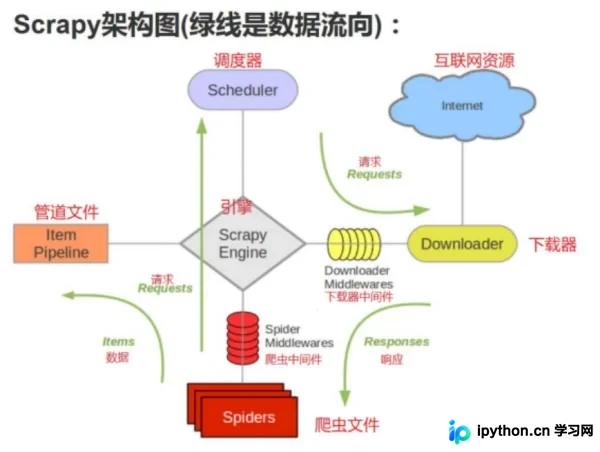
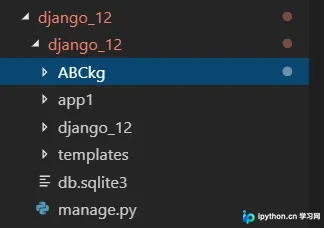
本文深入解析Scrapy爬虫框架的核心结构,详细阐述引擎、调度器、下载器、蜘蛛及管道等关键组件的功能与交互机制。通过梳理项目目录结构与数据流动路径,帮助开发者理解Scrapy为何被视为完整框架而非简单库,并掌握其高效处理网络请求与数据提取的工作原理。
2026-10-15
5

本文深入解析Scrapy爬虫框架的核心结构,详细阐述引擎、调度器、下载器、蜘蛛及管道等关键组件的功能与交互机制。通过梳理项目目录结构与数据流动路径,帮助开发者理解Scrapy为何被视为完整框架而非简单库,并掌握其高效处理网络请求与数据提取的工作原理。
本文详细讲解如何在Django项目中创建并运行Scrapy爬虫,实现数据抓取后直接存入Django数据库。通过配置settings.py、编写爬虫逻辑、利用scrapy-djangoitem将Item映射为Django模型,并在Pipeline中调用save()方法,最终在Admin后台查看结果。
本文详解Python爬虫中URL下载器的实现原理与用法。介绍如何从内置urllib迁移至功能强大的Requests库,通过HtmlDownloader类封装下载逻辑。重点讲解User-Agent伪装、状态码判断及编码处理等关键步骤,帮助开发者构建高效稳定的数据抓取模块。
本文详解Python Scrapy框架中项目数据的持久化处理方案。针对抓取数据需后期分析的需求,重点介绍如何将默认的文件存储切换至MySQL数据库。通过修改settings.py配置文件,启用SavetoMySQLPipeline并配置数据库连接参数,实现高效的数据存储与管理,避免文件散乱带来的检索难题。
本文介绍如何在Python中使用urllib模块的urlretrieve函数直接下载远程图片。通过示例演示了如何指定本地保存路径、利用回调函数显示下载进度,以及处理POST数据。代码示例展示了抓取网页图片并保存至本地的完整流程,包含进度监控和文件管理逻辑。
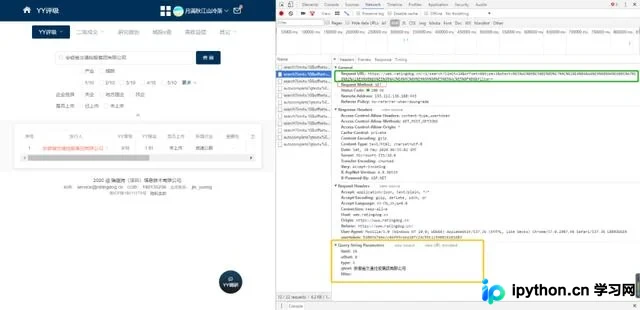
本文介绍使用Python编写爬虫批量获取YY评级分数的方法。通过解析Ajax GET请求URL规律,提取企业名称变量构建请求。重点讲解如何携带登录Cookie维持会话状态,并利用正则表达式从JSON响应中提取评级数据。最终实现将安徽省100多条发债企业数据保存至本地,适用于大规模企业评级信息查询场景。
本文详细解析Scrapy框架中Spider的四种核心爬取模式。通过具体代码示例,演示如何抓取单页数据、基于预设列表生成多页链接、识别并跟随“下一页”按钮,以及进入子链接提取深层内容。涵盖start_urls配置、parse回调处理及Request对象的使用,帮助开发者掌握不同场景下的爬虫构建技巧。
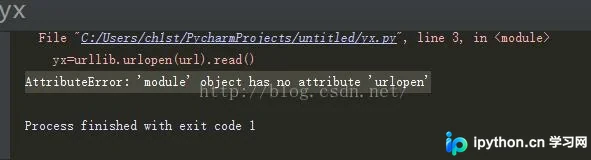
本文针对Python 3版本中urllib库无法直接使用urlopen导致的AttributeError错误提供解决方案。由于Python 3对urllib模块进行了重构,原urllib2等功能已并入urllib.request子模块。文章详细说明了正确的导入方式及代码示例,帮助开发者快速修复爬虫脚本中的模块调用问题。
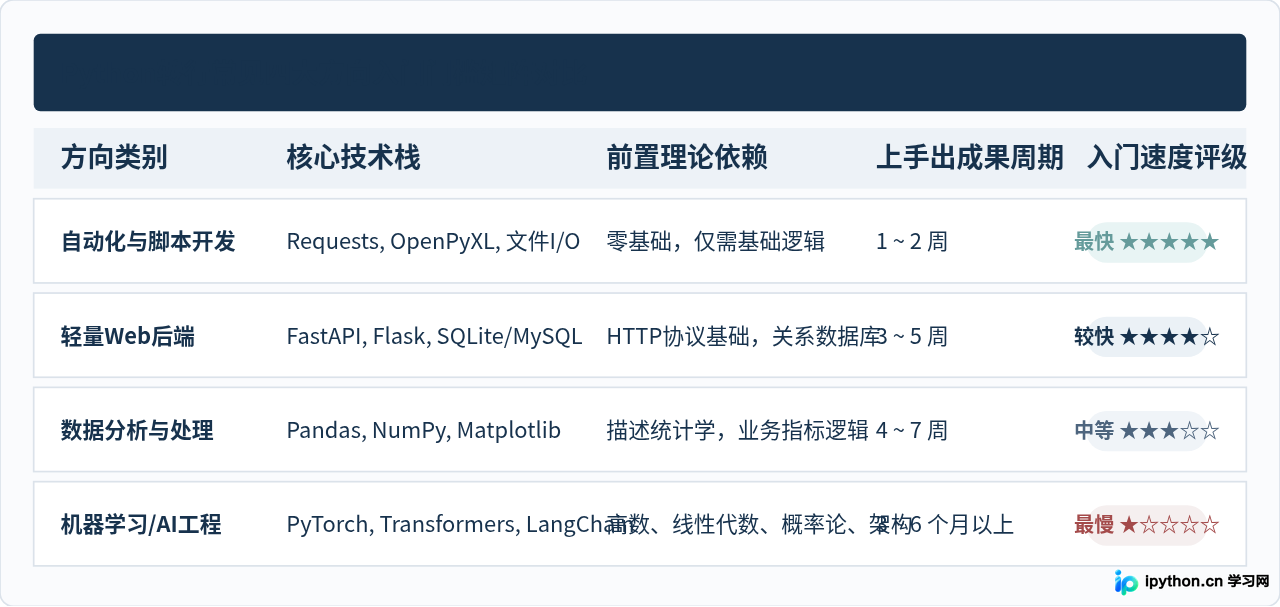
针对零基础转行Python开发群体,客观对比自动化办公、网络爬虫、Web后端与数据分析等主流方向的入门门槛、学习周期与上手路径,给出切实可行的转型建议。
本文介绍如何在 Scrapy-Redis 框架下实现 POST 请求的数据采集。通过重写 make_request_from_data 方法,将默认的 GET 请求转换为 POST 请求,并配置 Redis 调度器与去重过滤器。文章提供了 settings.py 配置、Spider 代码及 Redis 数据写入示例,帮助开发者解决分布式爬虫中 POST 请求的处理问题。
本文介绍了一种在Python爬虫开发中批量管理后台进程的方法。通过nohup命令在后台运行脚本并将进程ID(PID)追加至文件,随后利用Python读取该文件并执行kill命令,实现一次性终止大量挂起的爬虫任务。文章同时指出了进程复用可能导致误杀的风险,提供了实用的批量进程控制思路。
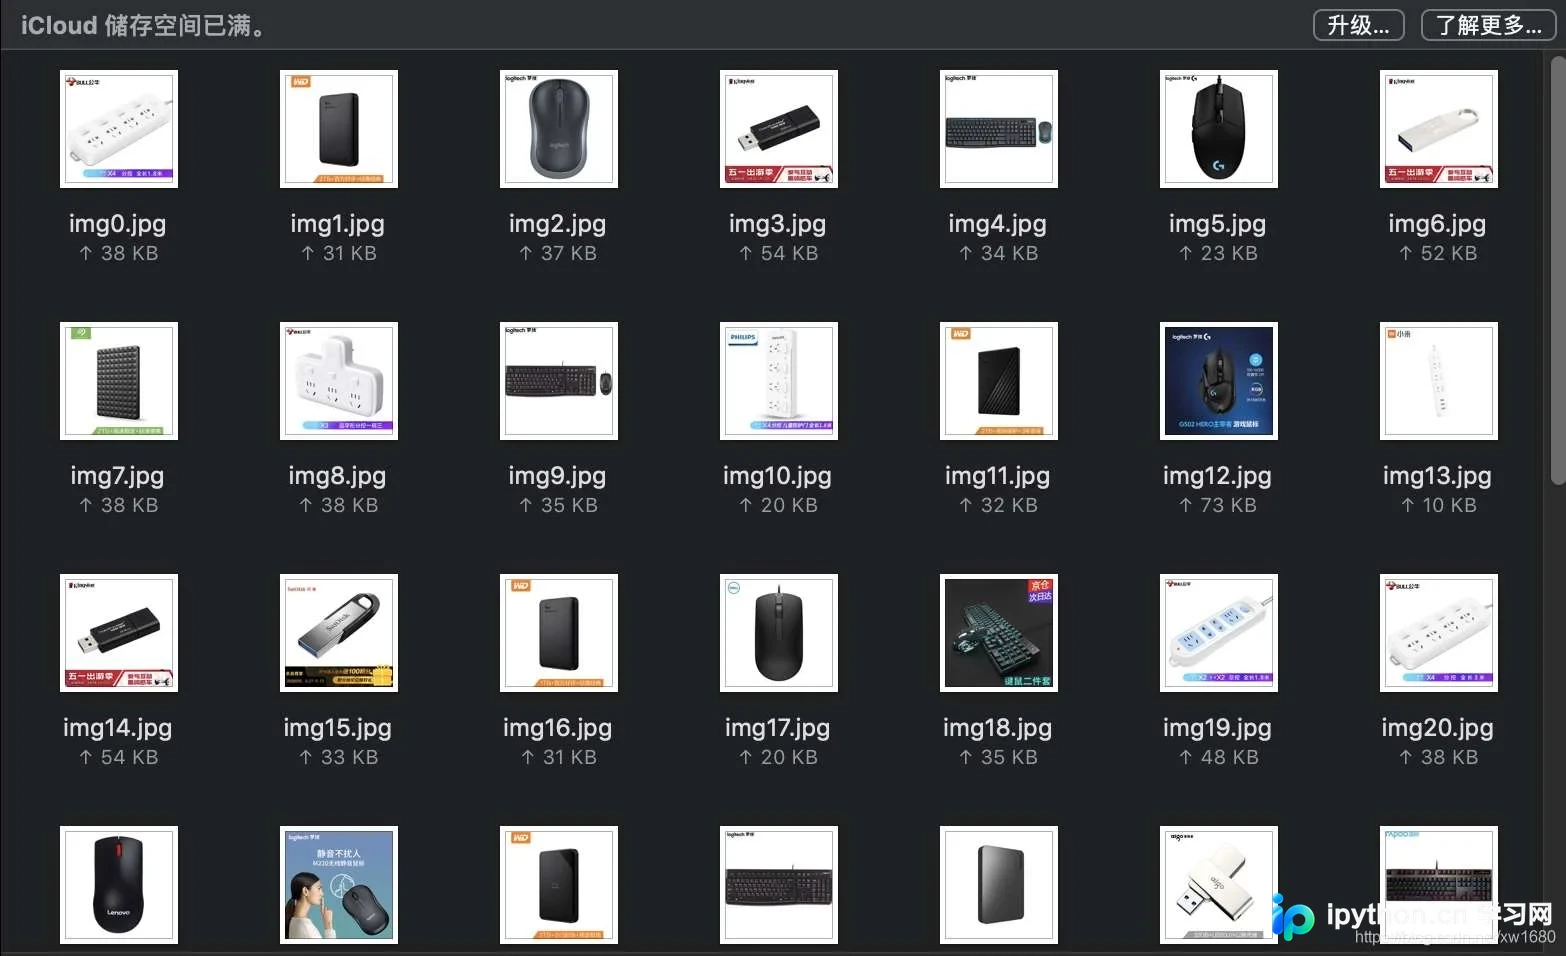
本文详细介绍如何利用Python 3编写图片爬虫,从京东网站批量下载编程类图书封面。通过解析URL分页规律,结合正则表达式对HTML源码进行两次过滤,精准提取商品图片链接,并使用urllib库实现本地存储。文中包含完整代码示例及异常处理逻辑,适用于学习网络爬虫基础与数据抓取技术。