

Python爬虫 urllib2 基础用法与Request对象详解
本文详解Python 2中urllib2模块的核心用法,涵盖urlopen基础请求、Request对象构造及HTTP报头设置。通过实例演示如何获取网页源码、添加User-Agent伪装浏览器身份,并处理POST数据与自定义Header,帮助开发者掌握基本的网页抓取技巧。
2026-10-13
6

本文详解Python 2中urllib2模块的核心用法,涵盖urlopen基础请求、Request对象构造及HTTP报头设置。通过实例演示如何获取网页源码、添加User-Agent伪装浏览器身份,并处理POST数据与自定义Header,帮助开发者掌握基本的网页抓取技巧。
本文详解如何使用Python Scrapy框架爬取豆瓣电影Top250数据,并通过自定义Pipeline将结果持久化至MongoDB数据库。内容涵盖items定义、Spider编写、Pipeline配置及Settings设置,提供完整代码示例与测试步骤,帮助开发者掌握Web爬虫与数据库存储的结合应用。
本文详细演示如何使用Scrapy框架创建爬虫项目,定义Items数据结构,编写Spider解析网页HTML并提取职位信息,最后通过Pipeline将数据持久化存储到MongoDB数据库中。涵盖从项目初始化、代码编写到数据落地的完整流程,适合初学者快速掌握Scrapy核心用法。
本文深入解析Python内置HTMLParser模块的工作原理,详细列举handle_starttag等核心回调函数。通过一个完整的贴吧图片抓取实例,演示如何继承HTMLParser并重写方法以提取GIF和JPG链接,实现自动下载功能,为Python爬虫开发提供实用参考。
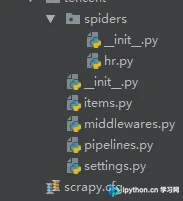
本文详细讲解如何在Python环境中安装Scrapy爬虫框架,并介绍如何利用PyCharm完成项目的初始化与Spider创建。内容涵盖使用国内豆瓣源解决安装慢的问题、验证安装版本、通过命令行创建项目结构以及在IDE中生成Spider模板的完整操作流程,帮助开发者快速上手Scrapy开发。
本文深入解析 Python requests 库中的超时处理机制,区分连接超时与读取超时的定义及默认行为。通过代码示例演示如何分别设置两种超时时间,并介绍利用 HTTPAdapter 配置最大重试次数(max_retries)的方法,帮助开发者避免爬虫程序因网络波动而永久挂起或频繁报错。
本文介绍在Python中为数字字符串左侧补零的两种实用方法。第一种通过设定足够大的基数进行加法运算后截取指定子串;第二种通过计算当前字符串长度与预期长度的差值,动态生成前导零。这两种方法均可有效解决URL中日期格式需补零的问题,适用于新闻爬虫等场景。
本文分析Python多线程爬虫中因多个线程同时读写全局变量导致的文件名覆盖问题。通过引入锁机制保护全局变量操作,确保每个线程获取唯一的文件编号,从而解决文件被重复覆盖的bug,保障多线程环境下的数据完整性。
本文详细介绍如何使用Scrapy框架将爬取数据导出为Excel格式。通过定义Item实体类、配置CsvItemExporter以及注册Pipeline,实现数据的结构化存储。文章涵盖环境要求、核心代码实现及爬虫运行步骤,帮助开发者快速掌握Scrapy数据导出功能。
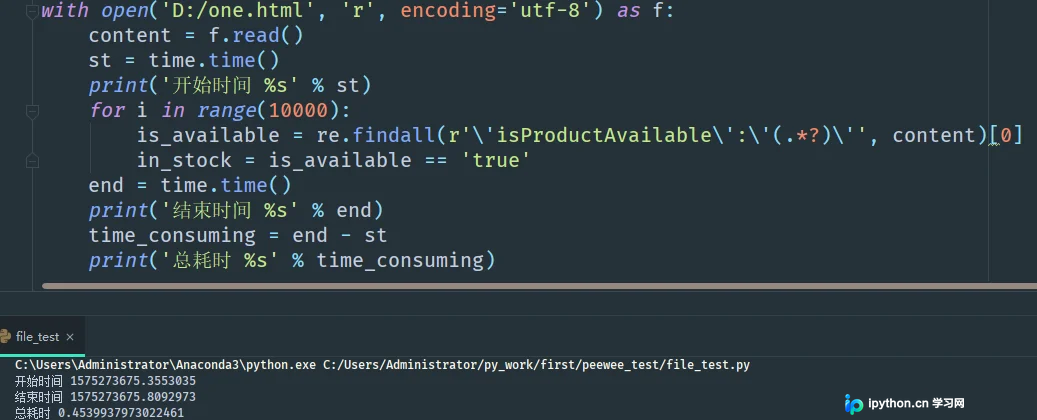
本文探讨 Python 中 re.compile 的必要性。作者通过实际案例指出,在数据量较小(如上万条)的场景下,直接使用 re.findall 或 re.search 的性能损耗可忽略不计,过度优化反而增加代码复杂度。只有面对百万级以上数据时,预编译正则对象才具有显著性能优势。文章强调应根据业务量级合理选择策略,而非盲目追求代码规范。
本文深入解析 Scrapy 框架中的两类核心中间件:下载器中间件(Downloader Middleware)与 Spider 中间件。详细说明了中间件的注册顺序、执行流程及关键方法(process_request、process_response、process_exception)的行为差异。提供了自定义 User-Agent 轮换、代理 IP 切换及基于状态码的重试中间件代码示例,并介绍了 Spider 中间件对 Item 和 Request 的处理逻辑,帮助开发者构建更稳健的爬虫系统。
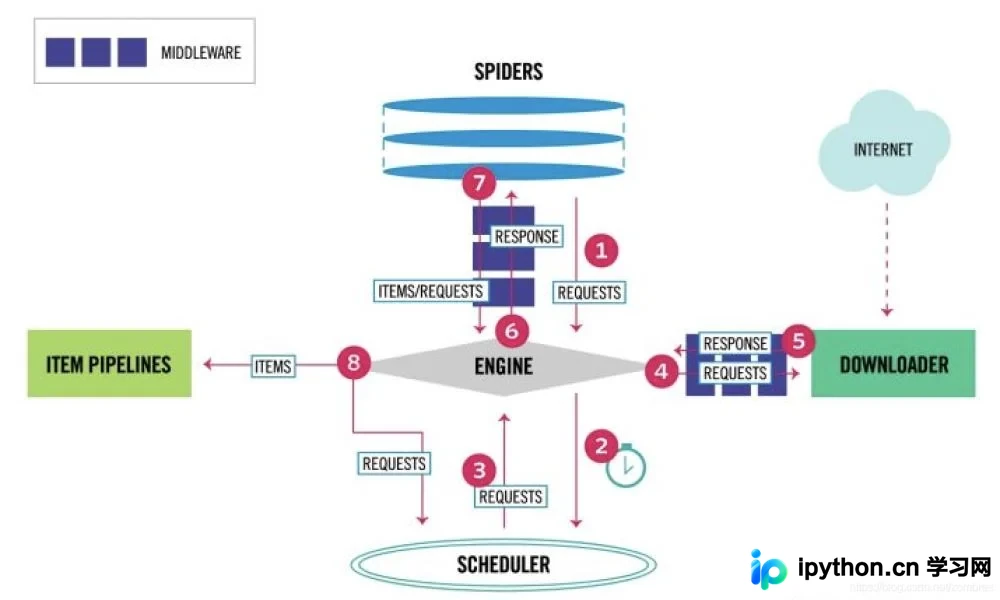
本文详解Scrapy框架中下载中间件的编写方法。涵盖process_request、process_response及process_exception三大核心函数的实现逻辑,演示如何通过中间件进行UA伪装、响应数据篡改(结合Selenium处理动态加载)以及代理IP设置,并说明在settings.py中启用中间件的具体配置步骤。