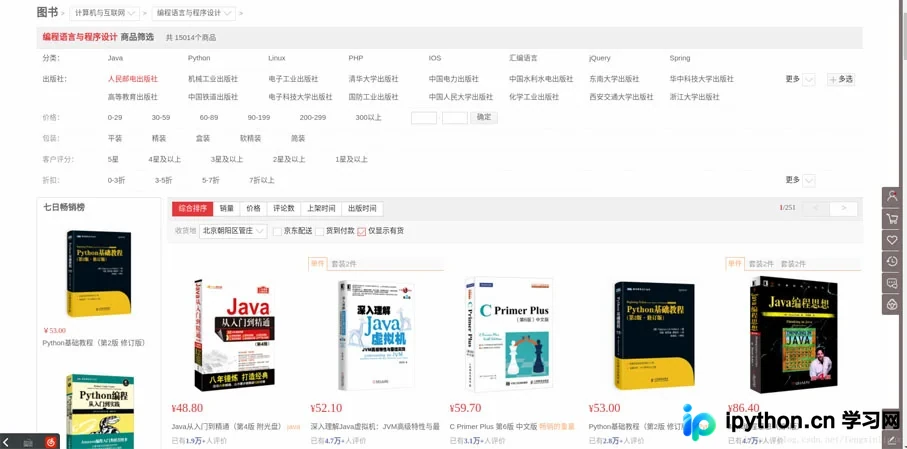
Python 3实战:使用正则表达式与urllib爬取京东图书图片
本文详细介绍如何利用Python 3编写图片爬虫,从京东网站批量下载编程类图书封面。通过解析URL分页规律,结合正则表达式对HTML源码进行两次过滤,精准提取商品图片链接,并使用urllib库实现本地存储。文中包含完整代码示例及异常处理逻辑,适用于学习网络爬虫基础与数据抓取技术。
2026-10-13
2

本文详细介绍如何利用Python 3编写图片爬虫,从京东网站批量下载编程类图书封面。通过解析URL分页规律,结合正则表达式对HTML源码进行两次过滤,精准提取商品图片链接,并使用urllib库实现本地存储。文中包含完整代码示例及异常处理逻辑,适用于学习网络爬虫基础与数据抓取技术。
本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的爬取难题。通过配置Spider与下载中间件,利用浏览器对象执行页面滚动并获取渲染后的HTML源码,成功抓取网易新闻多个版块的动态内容。文章提供了完整的代码实现、配置步骤及注意事项,帮助开发者高效处理复杂动态网页。
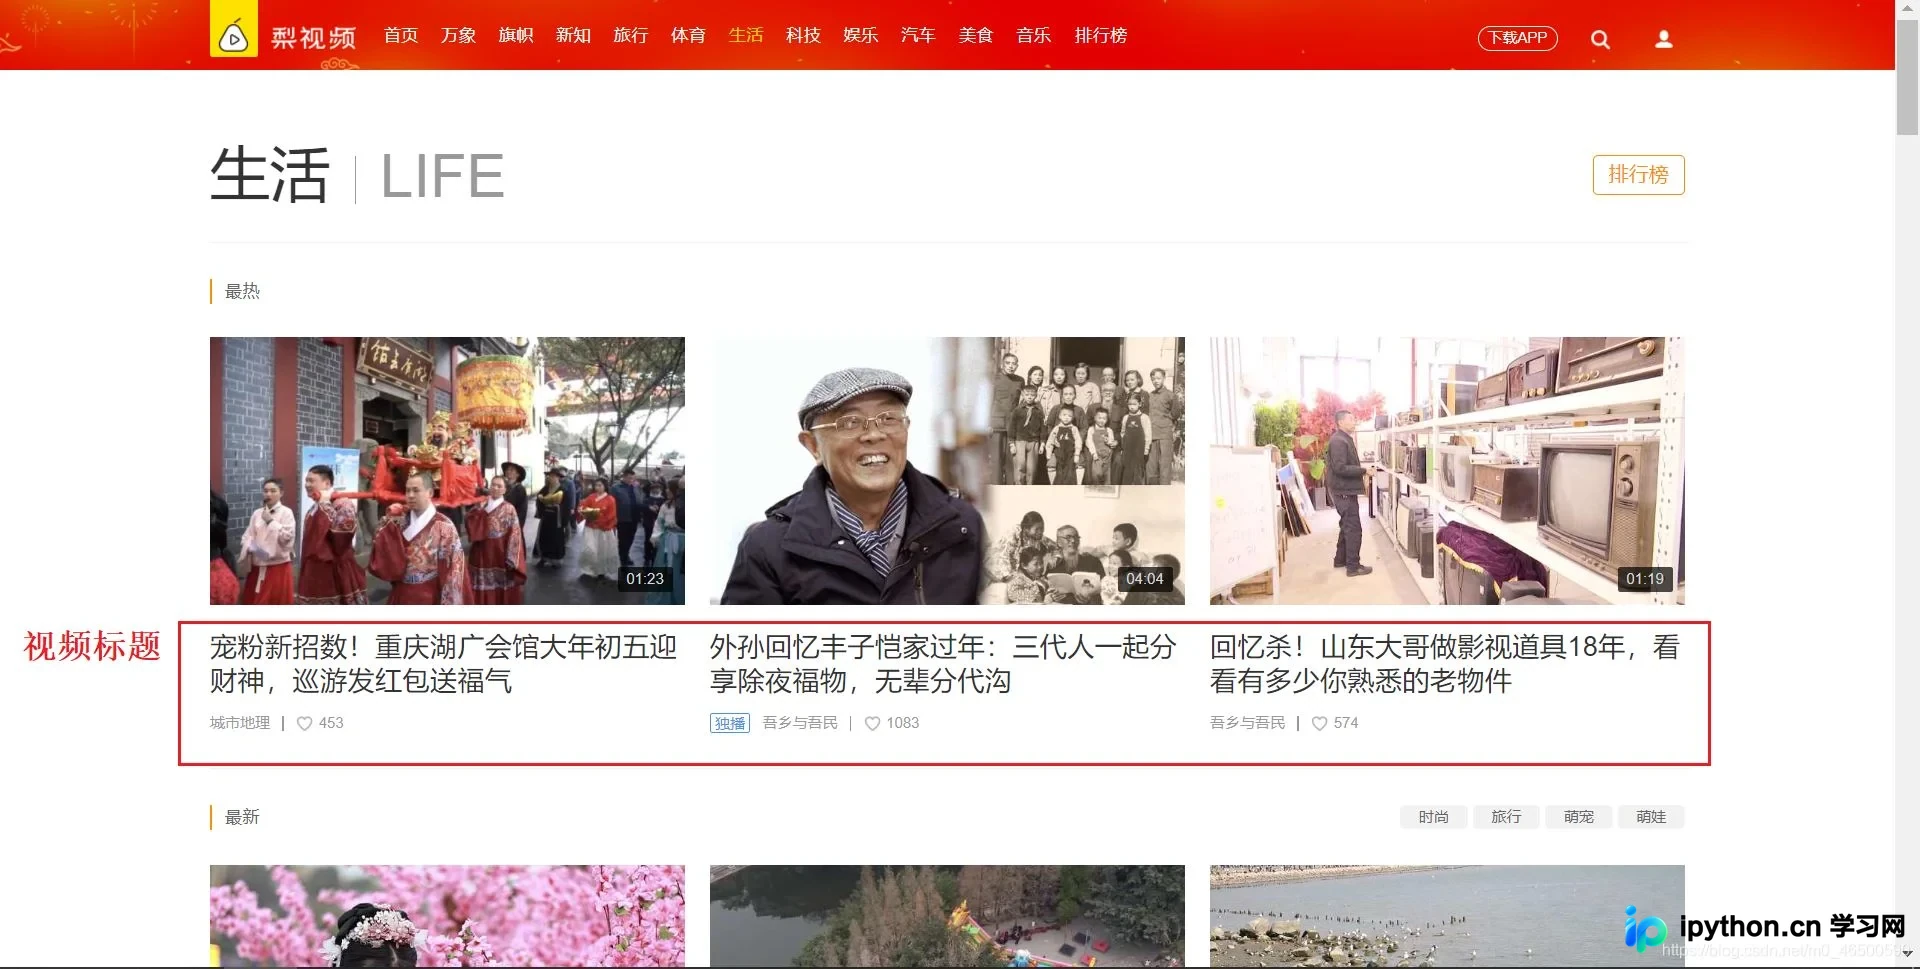
本文基于Scrapy框架解析梨视频网站的数据抓取流程。针对视频标题与描述分属不同页面的特点,通过自定义parse方法与meta参数传递Item对象,实现跨页面数据解析。结合items定义字段与pipeline管道类,完成数据的清洗、持久化存储及多管道优先级处理,提供完整的代码示例与配置说明。