Python 爬虫实战:自动抓取彼岸桌面高清壁纸
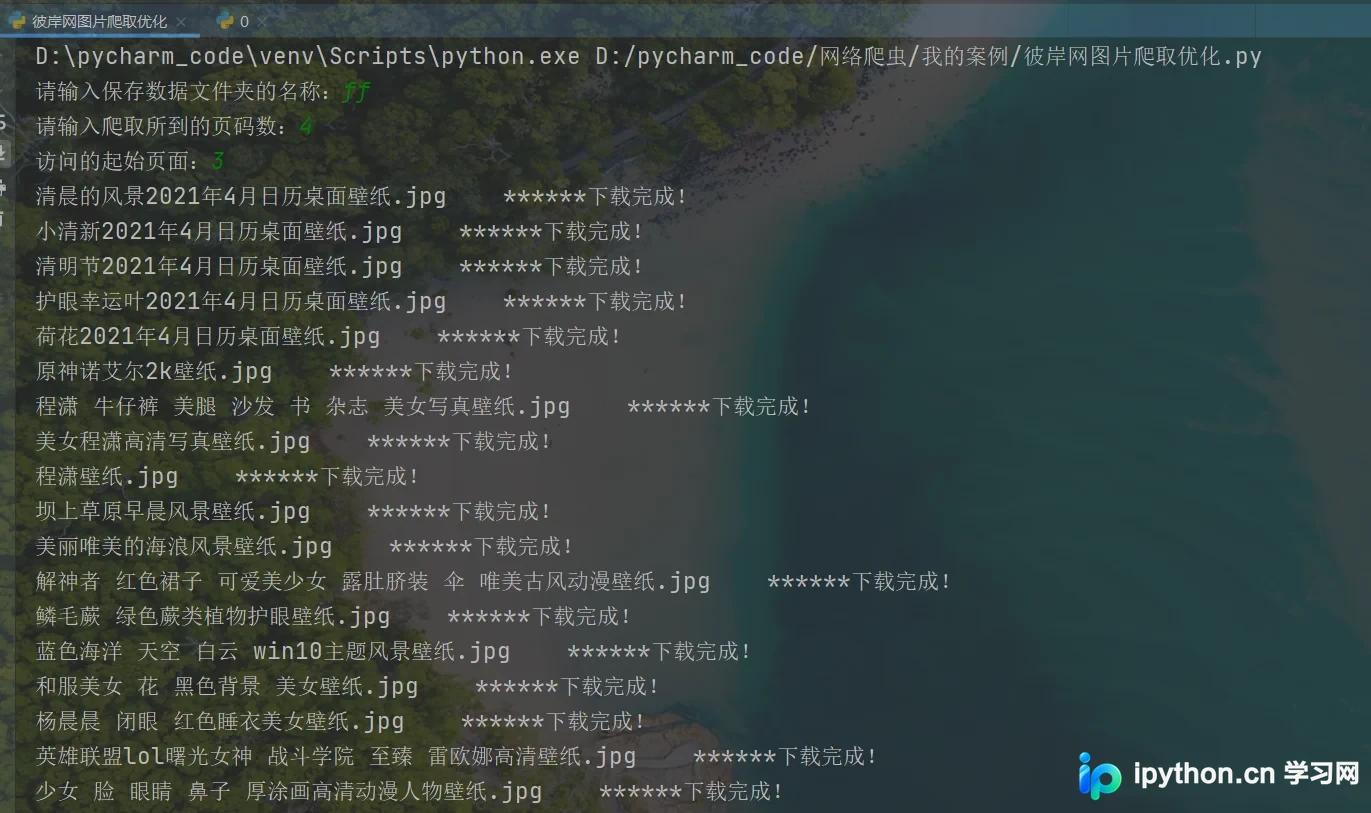
本文以彼岸桌面网站为例,详细演示如何使用 Python 编写爬虫程序批量下载高清无损壁纸。内容涵盖环境配置、HTML 解析、文件夹创建及图片保存等核心步骤,并附带完整可运行代码与结果展示,适合初学者学习网络数据采集基础。
2026-10-14
5

本文以彼岸桌面网站为例,详细演示如何使用 Python 编写爬虫程序批量下载高清无损壁纸。内容涵盖环境配置、HTML 解析、文件夹创建及图片保存等核心步骤,并附带完整可运行代码与结果展示,适合初学者学习网络数据采集基础。
本文介绍使用Python进行Web站点邮箱扫描的完整流程。通过解析URL、利用requests获取网页内容,并结合正则表达式提取邮箱地址。脚本支持递归遍历超链接,实现批量收集目标站点的邮箱信息,为后续的安全测试或钓鱼攻击提供数据基础。
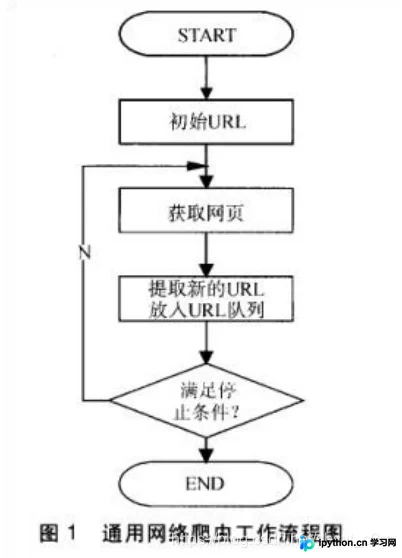
本文深入解析Python网络爬虫的两大核心类型:通用爬虫与聚焦爬虫。详细阐述通用爬虫在搜索引擎中的工作流程,包括种子URL选取、页面抓取、数据存储及预处理(分词、索引构建)等关键步骤,并探讨Robots协议的作用与局限性。同时,介绍聚焦爬虫如何通过主题筛选算法实现精准数据采集,对比两者在覆盖率、资源消耗及应用场景上的差异,并简述常见的反爬虫手段如IP限制与数据投毒,为开发者提供全面的技术参考。
本文详解 PHP 中利用 $_SERVER['HTTP_REFERER'] 获取用户访问来源,并通过底层 Socket 连接手动构造 HTTP Header 来伪造 Referer 的具体操作。同时解析了抓取网页时出现乱码的原因及 file_get_contents 自动处理 gzip 压缩的机制,提供实用的代码实例与排错参考。
本文详细介绍如何利用Python获取百度首页热榜关键词,并通过构造特定URL参数生成对应的搜索链接。同时,文章扩展讲解了使用requests和lxml库抓取百度搜索结果标题、摘要及链接的完整代码实现,涵盖请求头设置、参数解析及数据提取技巧,帮助开发者掌握基础的网络数据采集方法。
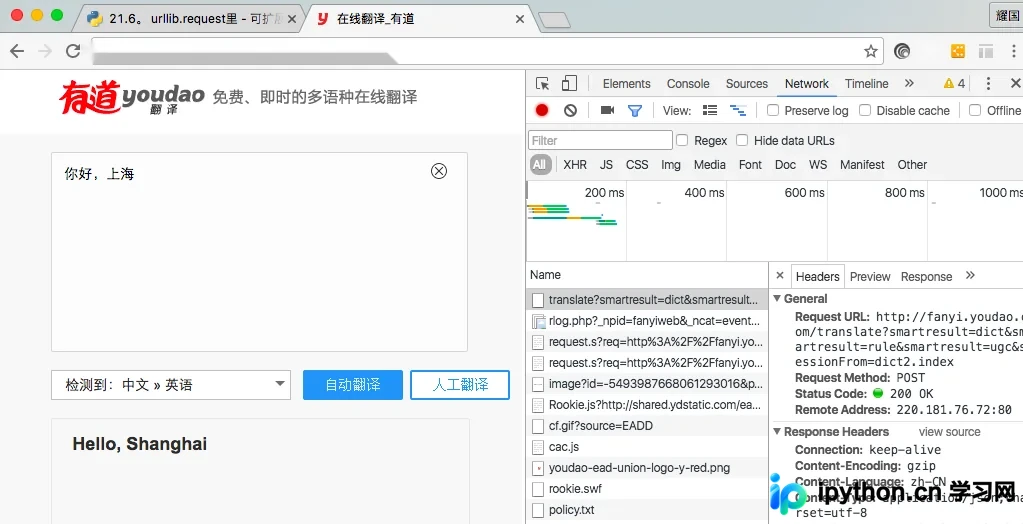
本文详解Python网络爬虫基础,重点讲解urllib模块的用法,包括获取网页源码、解析响应对象及实现有道翻译接口调用。针对服务器反爬机制,介绍了User-Agent伪装、访问延迟及代理IP设置等规避风险的方法,最后通过煎蛋网案例演示如何批量下载网络图片。
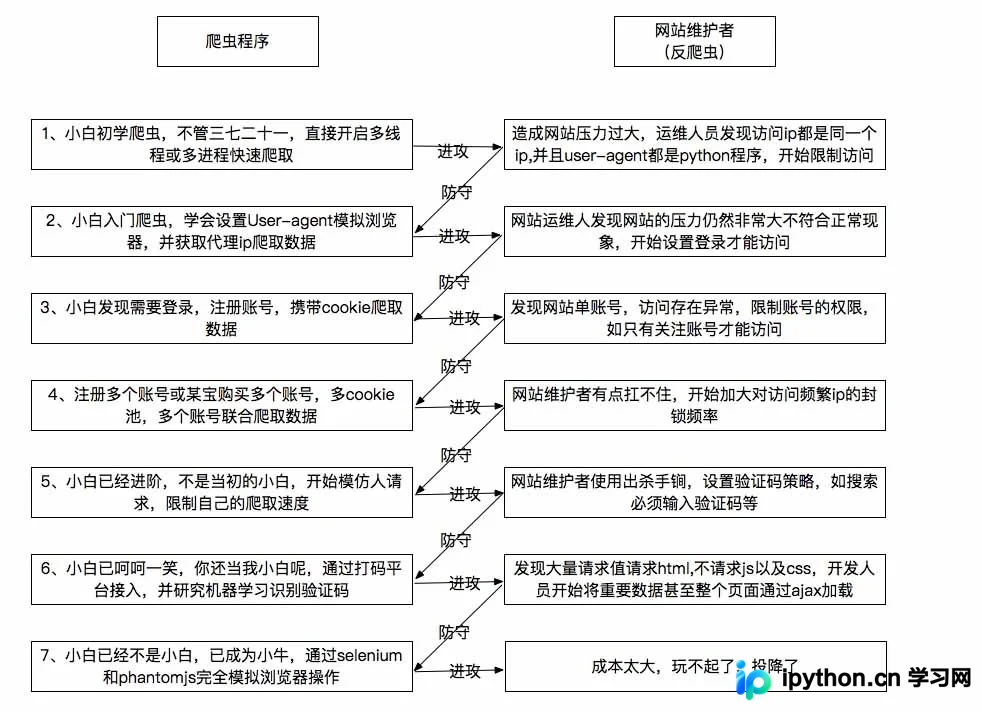
本文深入解析Python爬虫与反爬虫的对抗机制,涵盖自动获取数据原理、常见反爬策略如IP封禁的成本与误伤风险,以及数据保护与商业竞争背景下的防御目的。通过梳理实战中的攻防策略,帮助开发者理解如何在获取数据与防止滥用之间取得平衡,适用于Python及相关技术栈的开发者参考。
本文详细介绍如何利用Python构建一个自动化的网站通知监控系统。通过urllib和BeautifulSoup抓取网页内容,结合sqlite3建立本地数据库以存储历史通知。系统模拟SMTP服务器(如QQ邮箱)实现邮件发送功能,并通过Windows任务计划程序设定定时执行脚本,从而实现对目标网站最新通知的实时监测与自动邮件提醒。
本文系统讲解Python网络爬虫的核心技术与Requests库的实战应用。内容涵盖Requests库的安装配置、核心方法解析(get/post等)、Response对象属性及异常处理机制。深入剖析HTTP协议、URL结构及PATCH与PUT的区别,并结合京东、亚马逊商品爬取、搜索引擎关键词提交、图片存储及IP查询等具体案例,展示网络爬虫的实际操作流程与注意事项。
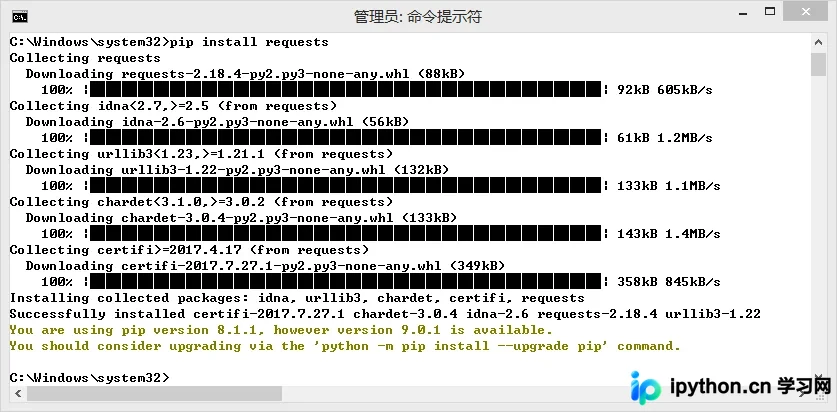
本文系统总结Python网络爬虫中常用的四种数据提取工具:正则表达式、BeautifulSoup、Lxml及CSS选择器。通过对比分析各模块的安装方式、解析原理、代码构造难度及运行性能,指出Lxml因C语言底层实现而在速度与健壮性上占优,而BeautifulSoup适合轻量级场景。文章提供各选择器的典型用法示例,帮助开发者根据实际需求选择最合适的数据抓取方案。
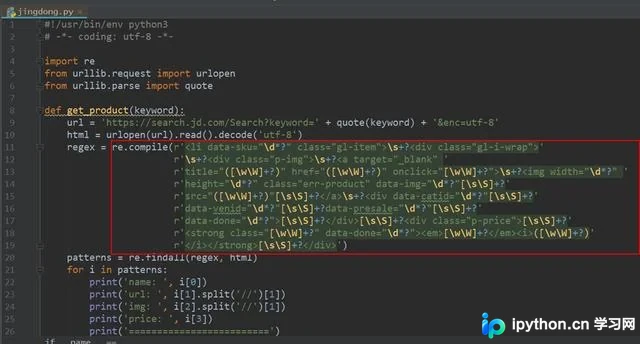
本文介绍如何使用Python的Queue模块结合多线程实现高效的多线程爬虫。通过实例化多个队列分别处理URL、HTML响应和解析内容,利用Queue.task_done()和Queue.join()机制确保线程有序执行与资源释放,实现并发抓取糗事百科数据。
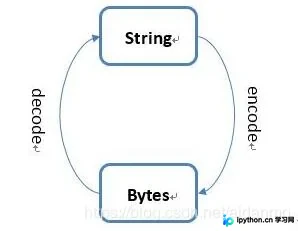
本文深入解析Python3中字符串与字节流的区分机制,详细演示如何使用encode和decode方法处理\xe6\x97\xa0\xe6\xb3\x95格式的乱码。通过raw_unicode_escape编码及str()构造函数,提供将字节串转换为可读汉字的实用代码示例,并涵盖从网络抓取网页时处理中文乱码的实际应用技巧。