

Python实现百度热榜链接生成与搜索结果抓取详解

本文详细介绍如何利用Python获取百度首页热榜关键词,并通过构造特定URL参数生成对应的搜索链接。同时,文章扩展讲解了使用requests和lxml库抓取百度搜索结果标题、摘要及链接的完整代码实现,涵盖请求头设置、参数解析及数据提取技巧,帮助开发者掌握基础的网络数据采集方法。
获取百度热榜链接的方法
首先需要确定目标网址,即百度首页地址。
https://www.baidu.com/我们的核心目标是获取百度首页展示的热榜关键词,并基于这些关键词生成对应的百度搜索链接。
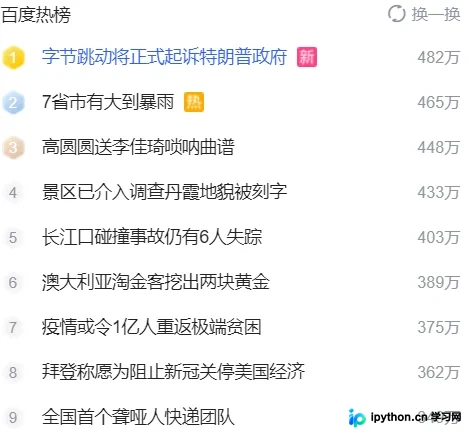
通过观察百度首页的结构可以发现,热榜数据通常以JSON格式嵌入在页面源码中。
从相关截图分析可知,我们只需提取出热榜中的关键字,随后将其嵌入到百度搜索的标准URL模板中即可完成链接构建。
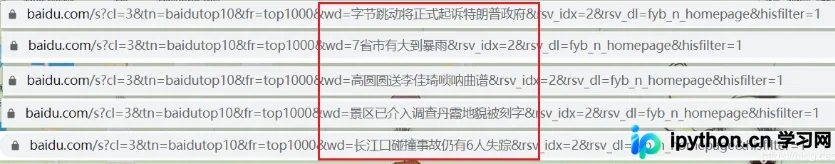
以下是获取百度热榜并生成搜索链接的完整Python代码示例。
import requests
import pprint
import re
import urllib.parse

url = 'https://www.baidu.com/'

headers = {
    'Host': 'www.baidu.com',
    'Referer': 'https://www.baidu.com/',
    'User-Agent': 你的User-Agent,
    'Cookie': 你的Cookie
}

response = requests.get(url, headers=headers).content.decode('utf-8')
# 获取关键字
pat = '"pure_title": "(.*?)"'
keyword = re.findall(pat, response, re.S)
print(len(keyword))

for hot_word in keyword:
    # 汉字不符合url标准,所以这里需要进行url编码
    i = urllib.parse.quote(hot_word, encoding='utf-8', errors='replace')
    # url构建
    link = f'https://www.baidu.com/s?cl=3&tn=baidutop10&fr=top1000&wd={i}&rsv_idx=2&rsv_dl=fyb_n_homepage&hisfilter=1'
    print(link)
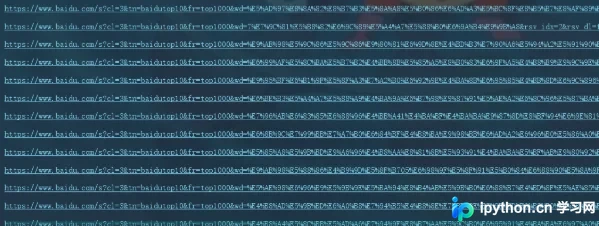
运行上述代码后,输出的结果链接通常包含较多冗余参数,导致URL字符串较长。
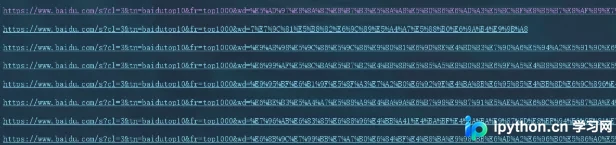
实际上,URL中关键字之后的部分参数(如cl、tn、fr等)并非必需,去除这些参数可以显著缩短链接长度,使其更加简洁。
Python爬取百度搜索结果实战
除了获取热榜链接,我们还可以进一步利用Python爬取百度搜索结果页面的具体内容。
本节将介绍如何使用Python爬取简单的百度搜索结果数据。
具体操作为抓取百度搜索结果中的标题、摘要和链接信息。
为了更准确地定位需要提取的信息节点,建议借助Chrome浏览器的XPath Helper插件来辅助查找元素的XPath路径。
在发起搜索请求前,需了解百度搜索请求的关键参数:lm参数用于限制结果的时间范围,默认值为0,通常设置为1表示最近一天;rn参数定义每页显示的结果数量。
默认情况下,每页显示10条搜索结果,这由rn参数控制。
pn参数用于指定当前查询的页码,从0开始计数。
from lxml import etree
import re
import requests
import string
import json
headers = {
  "User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36"
}
response = requests.get('https://www.baidu.com/s?wd=腾讯视频优惠&lm=1',headers=headers)
r = response.text
html = etree.HTML(r,etree.HTMLParser())
r1 = html.xpath('//h3')
r2 = html.xpath('//*[@class="c-abstract"]')
r3 = html.xpath('//a[@class="c-showurl"]')
for i in range(10) :
  r11 = r1[i].xpath('string(.)')
  r22 = r2[i].xpath('string(.)')
  r33 = r3[i].xpath('string(.)')
  # with open('test.txt', 'a', encoding='utf-8') as f:
  #   f.write(json.dumps(r11,ensure_ascii=False) + '\n')
  #   f.write(json.dumps(r22, ensure_ascii=False) + '\n')
  #   f.write(json.dumps(r33, ensure_ascii=False) + '\n')
  print(r11,end='\n')
  print(r22,end='\n')
  print(r33)
  print()
至此,关于使用Python获取百度热榜链接及爬取搜索结果的介绍已完成,更多相关技术内容可参考本站其他文章或继续浏览后续章节,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









