Python函数基础:内置库、第三方库安装与自定义函数详解
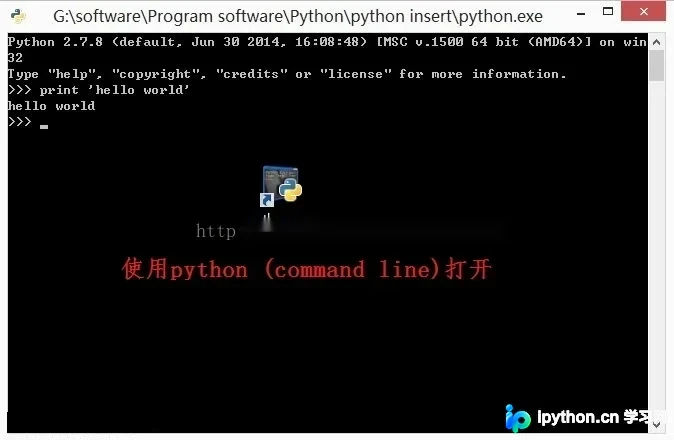
本文系统讲解Python函数的基础知识,涵盖内置函数库(字符串、数学、网络、OS)的使用方法,详细演示httplib2第三方库在Windows下的安装步骤及网页爬虫示例,并深入解析自定义函数的定义、返回值处理及参数预设规则,帮助初学者掌握Python编程核心技能。
2026-10-13
6

本文系统讲解Python函数的基础知识,涵盖内置函数库(字符串、数学、网络、OS)的使用方法,详细演示httplib2第三方库在Windows下的安装步骤及网页爬虫示例,并深入解析自定义函数的定义、返回值处理及参数预设规则,帮助初学者掌握Python编程核心技能。
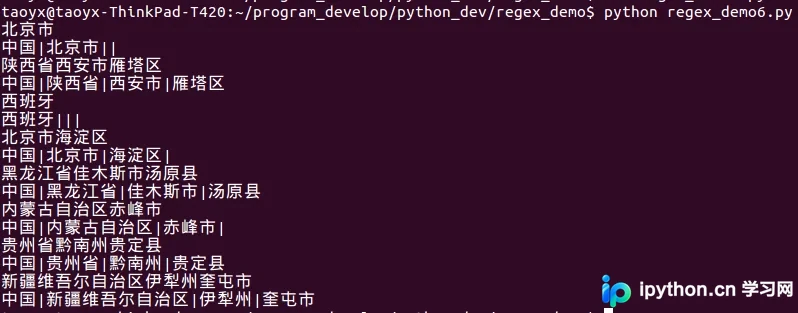
本文详细介绍如何在Python中使用中文正则表达式匹配指定中文字符串。针对GBK与UTF-8编码差异,推荐统一使用UTF-8编码以确保匹配准确性。通过两个实际案例:从纯真数据库解析省市县信息,以及从IP138网站提取ISP数据,展示了懒惰匹配和Unicode处理的关键技巧。
本文详细讲解在Python中如何为数据添加标签、根据条件判断标签值以及从HTML结构中获取特定标签内容。通过Pandas的merge与apply方法实现复杂逻辑打标,并结合lxml库利用XPath表达式精准提取网页元素属性,适用于数据分析和网络爬虫场景。
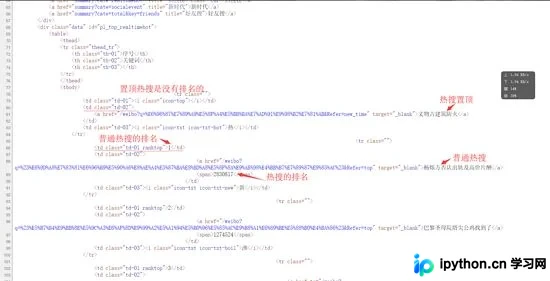
本文介绍使用Python的Requests和Lxml库抓取微博热搜数据的方法。通过解析HTML源码,利用XPath定位热搜标题、排名及阅读量节点,并处理置顶微博的特殊逻辑,最终格式化输出结果。
本文详细介绍如何利用Python调用微信Web接口实现自动登录并获取好友列表。通过解析登录二维码、模拟HTTP请求及处理XML数据,完整展示了从获取UUID到提取联系人信息的流程。代码包含必要的依赖库及核心逻辑,供开发者参考实现自动化操作。
本文介绍使用Python语言抓取双色球历史开奖信息的方法。通过urllib2和BeautifulSoup解析网页,获取截至2016年5月15日的1940期数据。代码包含获取总页数、提取开奖号码及日期等逻辑,旨在为后续的技术分析和预测提供数据基础。
本文详解Python网络爬虫中常见的乱码问题,涵盖中文、日文等多语言编码处理。通过解析HTTP Header、Meta标签及Document定义确定源编码,并介绍使用chardet库自动检测编码的方法。结合Python 2.7实例,演示如何正确进行字符串解码与编码转换,确保数据准确存储。
本文探讨学习Python爬虫的实际应用价值,涵盖大数据分析与机器学习的数据源获取。解析网络爬虫工作原理,对比浏览器与爬虫的数据交互差异,并深入分析Python作为爬虫首选语言的技术优势,包括其丰富的标准库、胶水语言特性及高效的执行机制。
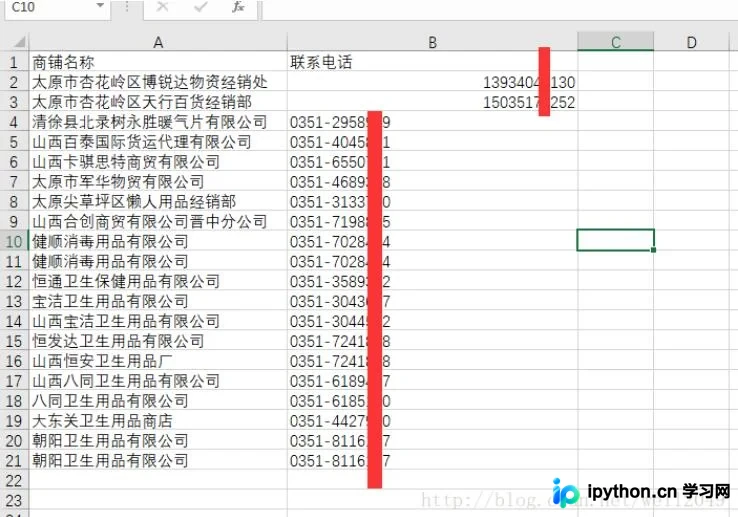
本文介绍如何使用 Python 爬取 114 黄页的商家联系电话及名称。通过 requests 获取页面源码,利用 BeautifulSoup 解析 HTML 结构,提取特定 div 下的列表数据。代码包含翻页逻辑、请求头设置及 CSV 文件写入,适合初学者学习基础爬虫开发。
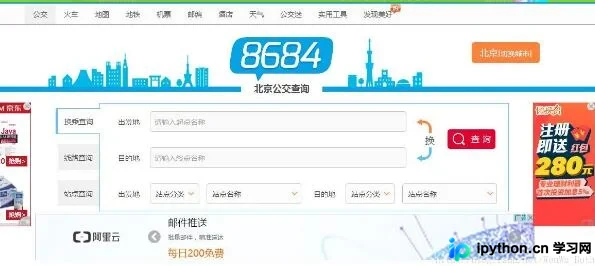
本文介绍如何使用Python爬虫批量抓取城市公交网络站点数据。通过requests获取页面,利用BeautifulSoup解析HTML结构,提取公交线路链接、站点信息及运营详情。代码包含完整的请求、解析与数据保存逻辑,适用于学习网络爬虫基础及数据抓取实战。
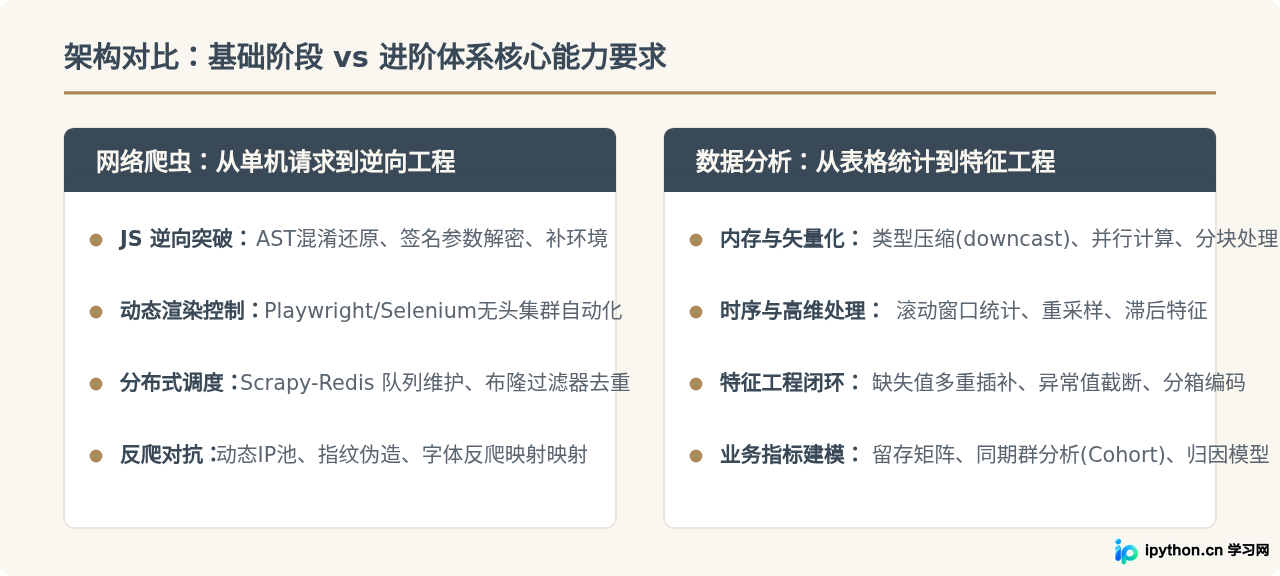
针对Python进阶学习者,提供高质量数据分析与网络爬虫百度网盘课程与配套资源的筛选标准、核心内容构成、实操获取与验证方法,帮助读者避开失效与低质资料。
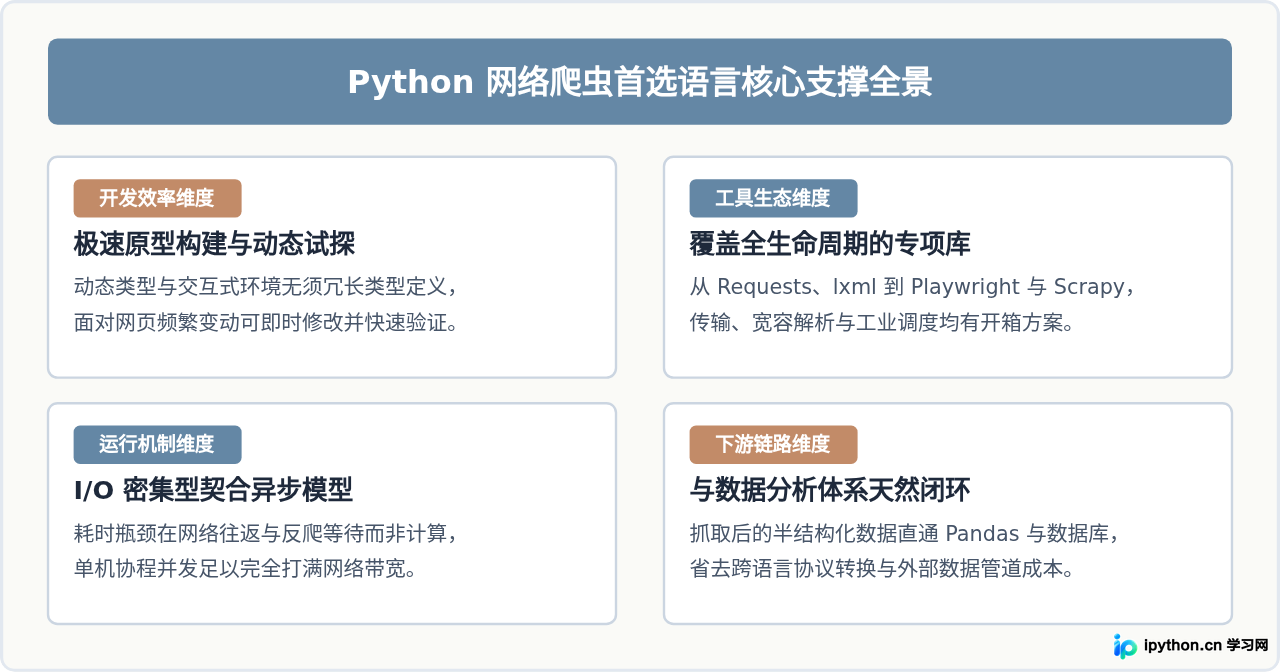
深入解析为什么Python成为网络爬虫开发的首选语言,从原型开发敏捷度、全流程专项工具生态、I/O密集型任务特性及下游数据协同等维度展开系统剖析,并提供技术选型指南。