

Python网络爬虫与信息提取实战:Requests库详解

本文系统讲解Python网络爬虫的核心技术与Requests库的实战应用。内容涵盖Requests库的安装配置、核心方法解析(get/post等)、Response对象属性及异常处理机制。深入剖析HTTP协议、URL结构及PATCH与PUT的区别,并结合京东、亚马逊商品爬取、搜索引擎关键词提交、图片存储及IP查询等具体案例,展示网络爬虫的实际操作流程与注意事项。
Python网络爬虫课程体系与理念
本课程体系结构清晰,旨在全面掌握网络爬虫与信息提取技术。
核心模块一:Requests框架,用于自动爬取HTML页面及自动提交网络请求。
核心模块二:Robots.txt,解析网络爬虫排除标准,明确抓取权限。
核心模块三:BeautifulSoup框架,用于高效解析HTML页面结构。
核心模块四:Re框架,利用正则表达式提取页面关键信息。
核心模块五:Scrapy框架,深入介绍网络爬虫原理及专业级爬虫框架。
核心理念:The Website is the API,即网站本身即是应用程序接口。
Python开发环境(IDE)选择指南
Python语言常用的IDE工具概览。
文本工具类IDE介绍。
常见文本工具类IDE包括:IDLE、Notepad++、Sublime Text、Vim & Emacs、Atom、Komodo Edit。
集成开发环境(IDE)介绍。
常见集成工具IDE包括:PyCharm、Wing、PyDev & Eclipse、Visual Studio、Anaconda & Spyder、Canopy。
IDLE是Python自带的默认入门级编写工具,支持交互式和文件式两种模式,适用于较短程序的编写。
Sublime Text是专为程序员开发的第三方专用编程工具,提供多种编程风格,旨在提升编程体验。
Wing由Wingware公司提供,属于收费IDE,具备丰富的调试功能、版本控制及同步功能,适合多人协作开发大型程序。
Visual Studio由微软公司维护,可通过配置PTVS编写Python,主要面向Windows环境,调试功能丰富。
Eclipse是一款开源IDE,可通过配置PyDev编写Python,但配置过程较为复杂,要求开发者具备一定的开发经验。
PyCharm分为社区版和专业版,社区版免费,具有简单、集成度高的特点,适用于编写较复杂的工程项目。
适用于科学计算与数据分析的IDE介绍。
Canopy由Enthought公司维护,属于收费工具,支持近500个第三方库,适合科学计算领域的应用开发。
Anaconda是开源免费的工具,支持近800个第三方库,广泛应用于数据科学领域。
Requests库入门与核心方法
Requests库入门指南。
Requests的安装步骤。
Requests库是目前公认的爬取网页效果最好的Python第三方库,具有简单、简洁的特点。
官方网站地址:http://www.python-requests.org
在"C:\Windows\System32"中找到"cmd.exe",使用管理员身份运行,在命令行中输入:“pip install requests”进行安装。
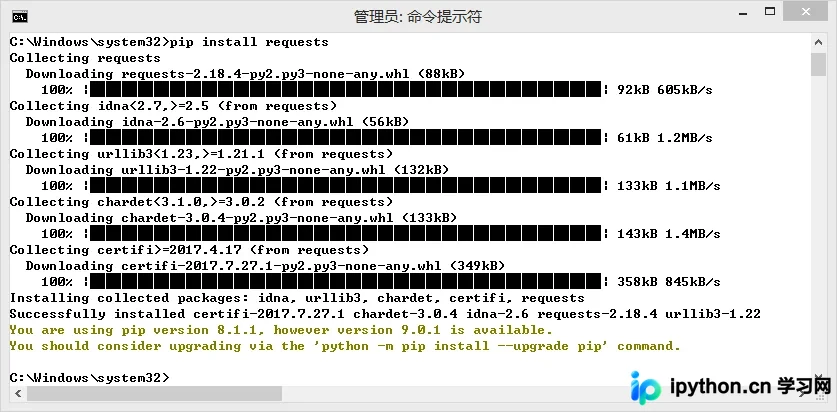
使用ID测试Requests库的基本操作。
>>> import requests
>>> r = requests.get("http://www.baidu.com")#抓取百度页面
>>> r.status_code
>>> r.encoding = 'utf-8'
>>> r.text
Requests库的7个主要方法解析。
| 方法 | 说明 |
| requests.request() | 构造一个请求,支撑以下各方法的基础方法 |
| requests.get() | 获取HTML网页的主要方法,对应于HTTP的GET |
| requests.head() | 获取HTML网页头信息的方法,对应于HTTP的HEAD |
| requests.post() | 向HTML网页提交POST请求的方法,对应于HTTP的POST |
| requests.put() | 向HTML网页提交PUT请求的方法,对应于HTTP的PUT |
| requests.patch() | 向HTML网页提交局部修改请求,对应于HTTP的PATCH |
| requests.delete() | 向HTML页面提交删除请求,对应于HTTP的DELET |
详细信息参考 Requests库 API文档:http://www.python-requests.org/en/master/api/
get()方法详解。
代码示例:r = requests.get(url)
get()方法用于构造一个向服务器请求资源的Request对象,并返回一个包含服务器资源的Response对象。
函数签名:requests.get(url, params=None, **kwargs)
url:拟获取页面的url链接。
params:url中的额外参数,字典或字节流格式,为可选参数。
**kwargs:包含12个控制访问的参数。
Response对象属性与异常处理
Requests库的2个重要对象解析。
Request对象。
Response对象:包含爬虫返回的内容。
Response对象的属性详解。
r.status_code:HTTP请求的返回状态,200表示连接成功,404表示失败。
r.text:HTTP响应内容的字符串形式,即url对应的页面内容。
r.encoding:从HTTP header中猜测的相应内容编码方式。
r.apparent_encoding:从内容中分析出的相应内容编码方式(作为备选编码方式)。
r.content:HTTP响应内容的二进制形式。
r.encoding:如果header中不存在charset,则认为编码为ISO-8859-1。
r.apparent_encoding:根据网页内容分析出的编码方式,可以看作是r.encoding的备选方案。
Response的编码处理机制。
r.encoding:从HTTP header中猜测的响应内容的编码方式;如果header中不存在charset,则认为编码为ISO-8859-1,r.text根据r.encoding显示网页内容。
r.apparent_encoding:根据网页内容分析出的编码方式,可以看作r.encoding的备选方案。
爬取网页的通用代码框架示例。
Requests库的异常处理机制。
| 异常 | 说明 |
| requests.ConnectionError | 网络连接错误异常,如DNS查询失败拒绝连接等 |
| requests.HTTPError | HTTP错误异常 |
| requests.URLRequired | URL缺失异常 |
| requests.ToolManyRedirects | 超过最大重定向次数,产生重定向异常 |
| requests.ConnectTimeout | 连接远程服务器超时异常 |
| requests.Timeout | 请求URL超时,尝试超时异常 |
Response的异常类型。
r.raise_for_status():如果不是200,产生异常requests.HTTPError。
在方法内部判断r.status_code是否等于200,不需要增加额外的if语句,该语句便于利用try-except进行异常处理。
import requests

def getHTMLText(url):
  try:
    r = requests.get(url, timeout=30)
    r.raise_for_status() # 如果状态不是200,引发HTTPError异常
    r.encoding = r.apparent_encoding
    return r.text
  except:
    return "产生异常"

if __name__ == "__main__":
  url = "http://www.baidu.com"
  print(getHTMLText(url))
通用代码框架可以使网页爬取变得更有效、更稳定、可靠。
HTTP协议与URL结构解析
HTTP协议基础。
HTTP,Hypertext Transfer Protocol,超文本传输协议。
HTTP是一个基于“请求与响应”模式的、无状态的应用层协议。
HTTP协议采用URL作为定位网络资源的标识。
URL格式:http://host[:port][path]
host:合法的Internet主机域名或IP地址;port:端口号,缺省端口号为80;path:请求资源的路径。
HTTP URL的理解与解析。
URL是通过HTTP协议存取资源的Internet路径,一个URL对应一个数据资源。
HTTP协议对资源的操作方式。
| 方法 | 说明 |
| GET | 请求获取URL位置的资源 |
| HEAD | 请求获取URL位置资源的响应消息报告,即获得该资源的头部信息 |
| POST | 请求向URL位置的资源后附加新的数据 |
| PUT | 请求向URL位置存储一个资源,覆盖原URL位置资源 |
| PATCH | 请求局部更新URL位置的资源,即改变该处资源的部分内容 |
| DELETE | 请求删除URL位置存储的资源 |
理解PATCH和PUT的区别。
假设URL位置有一组数据UserInfo,包括UserID、UserName等20个字段。
需求:用户修改了UserName,其他字段保持不变。
采用PATCH,仅向URL提交UserName的局部更新请求。
采用PUT,必须将所有20个字段一并提交到URL,未提交字段将被删除。
PATCH的主要好处:节省网络带宽。
Requests库高级参数与控制
Requests库主要方法解析。
函数签名:requests.request(method, url, **kwargs)
method:请求方式,对应get/put/post等7种方法。
示例:r = requests.request('OPTIONS', url, **kwargs)
url:拟获取页面的url链接。
**kwargs:控制访问的参数,共13个,均为可选项。
params:字典或字节序列,作为参数增加到url中。
kv = {'key1':'value1', 'key2':'value2'}
r = requests.request('GET', 'http://python123.io/ws',params=kv)
print(r.url)
'''
http://python123.io/ws?key1=value1&key2=value2
'''
data:字典、字节序列或文件对象,作为Request的内容。
json:JSON格式的数据,作为Request的内容。
headers:字典,用于HTTP定制头。
hd = {'user-agent':'Chrome/10'}

r = requests.request('POST','http://www.yanlei.shop',headers=hd)
cookies:字典或CookieJar,表示Request中的cookie。
auth:元组,支持HTTP认证功能。
files:字典类型,用于传输文件。
fs = {'file':open('data.xls', 'rb')}

r = requests.request('POST','http://python123.io/ws',files=fs)
timeout:设定超时时间,单位为秒。
proxies:字典类型,设定访问代理服务器,可以增加登录认证。
allow_redirects:True/False,默认为True,控制重定向开关。
stream:True/False,默认为True,控制获取内容是否立即下载。
verify:True/False,默认为True,控制是否认证SSL证书。
cert:本地SSL证书路径。
#方法及参数
requests.get(url, params=None, **kwargs)
requests.head(url, **kwargs)
requests.post(url, data=None, json=None, **kwargs)
requests.put(url, data=None, **kwargs)
requests.patch(url, data=None, **kwargs)
requests.delete(url, **kwargs)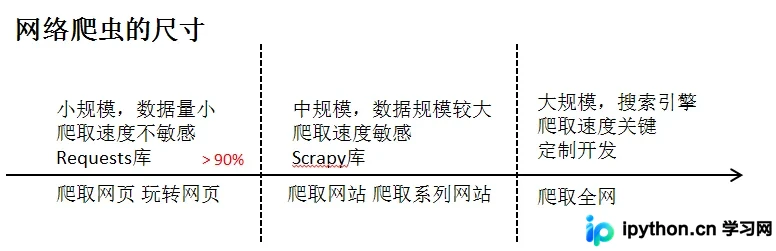
网络爬虫的风险与限制
网络爬虫引发的问题分析。
性能骚扰问题。
受限于编写水平和目的,网络爬虫可能会为web服务器带来巨大的资源开销。
法律风险问题。
服务器上的数据有产权归属,网络爬虫获取数据后牟利将带来法律风险。
隐私泄露问题。
网络爬虫可能具备突破简单访问控制的能力,获得被保护数据从而泄露个人隐私。
网络爬虫的限制措施。
来源审查机制。
通过判断User-Agent进行限制,检查来访HTTP协议头的User-Agent域,值响应浏览器或友好爬虫的访问。
发布公告机制:Robots协议。
告知所有爬虫网站的爬取策略,要求爬虫遵守相关规定。
Robots协议与爬取规范
Robots协议详解。
Robots Exclusion Standard,即网络爬虫排除标准。
作用:网站告知网络爬虫哪些页面可以抓取,哪些不可以。
形式:在网站根目录下的robots.txt文件。
案例:京东的Robots协议示例。
访问地址:http://www.jd.com/robots.txt
# 注释:*代表所有,/代表根目录
User-agent: *
Disallow: /?*
Disallow: /pop/*.html
Disallow: /pinpai/*.html?*
User-agent: EtaoSpider
Disallow: /
User-agent: HuihuiSpider
Disallow: /
User-agent: GwdangSpider
Disallow: /
User-agent: WochachaSpider
Disallow: /
Robots协议的使用规范。
网络爬虫应自动或人工识别robots.txt,再进行内容爬取。
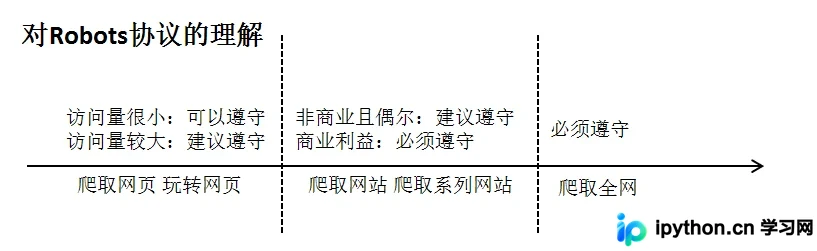
约束性:Robots协议是建议但非约束性,网络爬虫可以不遵守,但存在法律风险。
Requests库网络爬虫实战案例
Requests库网络爬虫实战案例。
案例一:京东商品爬取。
import requests
url = "https://item.jd.com/5145492.html"
try:
 r = requests.get(url)
 r.raise_for_status()
 r.encoding = r.apparent_encoding
 print(r.text[:1000])
except:
 print("爬取失败")
案例二:亚马逊商品爬取。
# 直接爬取亚马逊商品是会被拒绝访问,所以需要添加'user-agent'字段
import requests
url = "https://www.amazon.cn/gp/product/B01M8L5Z3Y"
try:
 kv = {'user-agent':'Mozilla/5.0'} # 使用代理访问
 r = requests.get(url, headers = kv)
 r.raise_for_status()
 r.encoding = r.apparent_encoding
 print(t.text[1000:2000])
except:
 print("爬取失败")
案例三:百度/360搜索关键词提交。
搜索引擎关键词提交接口说明。
百度的关键词接口示例。
接口地址:http://www.baidu.com/s?wd=keyword
360的关键词接口示例。
接口地址:http://www.so.com/s?q=keyword
# 百度
import requests
keyword = "Python"
try:
 kv = {'wd':keyword}
 r = requests.get("http://www.baidu.com/s",params=kv)
 print(r.request.url)
 r.raise_for_status()
 print(len(r.text))
except:
 print("爬取失败")
# 360
import requests
keyword = "Python"
try:
 kv = {'q':keyword}
 r = requests.get("http://www.so.com/s",params=kv)
 print(r.request.url)
 r.raise_for_status()
 print(len(r.text))
except:
 print("爬取失败")
案例四:网络图片的爬取和存储。
网络图片链接的格式说明。
示例链接:http://www.example.com/picture.jpg
国家地理网站示例。
网站地址:http://www.nationalgeographic.com.cn/
选择一张图片链接进行演示。
图片链接:http://image.nationalgeographic.com.cn/2017/0704/20170704030835566.jpg
图片爬取全代码
import requests
import os
url = "http://image.nationalgeographic.com.cn/2017/0704/20170704030835566.jpg"
root = "D://pics//"
path = root + url.split('/')[-1]
try:
 if not os.path.exists(root):
  os.mkdir(root)
 if not os.path.exists(path):
  r = requests.get(url)
  with open(path,'wb') as f:
   f.write(r.content)
   f.close()
   print("文件保存成功")
 else:
  print("文件已存在")
except:
 print("爬取失败")
案例五:IP地址归属地的自动查询。
www.ip138.com IP查询服务。
查询接口1:http://ip138.com/ips138.asp?ip=ipaddress
查询接口2:http://m.ip138.com/ip.asp?ip=ipaddress
import requests
url = "http://m.ip138.com/ip.asp?ip="
ip = "220.204.80.112"
try:
 r = requests.get(url + ip)
 r.raise_for_status()
 r.encoding = r.apparent_encoding
 print(r.text[1900:])
except:
 print("爬取失败")
# 使用IDLE
>>> import requests
>>> url ="http://m.ip138.com/ip.asp?ip="
>>> ip = "220.204.80.112"
>>> r = requests.get(url + ip)
>>> r.status_code
>>> r.text
以上这篇Python网络爬虫与信息提取(实例讲解)就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









