

Python3处理乱码与\xe6\x97\xa0\xe6\xb3\x95字符编码转换详解

本文深入解析Python3中字符串与字节流的区分机制,详细演示如何使用encode和decode方法处理\xe6\x97\xa0\xe6\xb3\x95格式的乱码。通过raw_unicode_escape编码及str()构造函数,提供将字节串转换为可读汉字的实用代码示例,并涵盖从网络抓取网页时处理中文乱码的实际应用技巧。
Python3字符编码查看与转换基础
首先,我们需要查看字符的编码情况:
import chardet
response = chardet.detect(b'\xe5\xbd\x93\xe5\x89\x8d\xe7\x9b\xae\xe5\xbd\x95\xe4\xb8\x8b\xe6\x89\x80\xe6\x9c\x89\xe6\x96\x87\xe4\xbb\xb6\xe5\x90\x8d\xe6\xb1\x87\xe6\x80\xbb\xe5\x88\x97\xe8\xa1\xa8')
print(response)

{'encoding': 'utf-8', 'confidence': 0.99, 'language': ''}
接下来演示如何将乱码字符进行转换:
response = b'\xe5\xbd\x93\xe5\x89\x8d\xe7\x9b\xae\xe5\xbd\x95\xe4\xb8\x8b\xe6\x89\x80\xe6\x9c\x89\xe6\x96\x87\xe4\xbb\xb6\xe5\x90\x8d\xe6\xb1\x87\xe6\x80\xbb\xe5\x88\x97\xe8\xa1\xa8'
print(response.decode('utf8'))
# def decode_char(*args):
#   response = args[0]
#   print(response.decode('utf8'))
#
# c = b'\a8\xe5\x90\xa7\xef\xbc\x81'
#
# decode_char(c)
补充知识:在Python3环境中,如何将形如'\xe5\xae\x9d\xe9\xb8\xa1\xe5\xb8\x82'的编码字符串转换为汉字输出?
在编程实践中,我们常遇到此类困扰。经过查阅大量资料与尝试,整理出以下解决思路,在此与大家分享。
Python3相较于Python2的一项核心改进是严格区分字符串(文本)与二进制数据流。在Python3中,文本始终为Unicode编码,由str类型表示;而二进制数据则由bytes类型表示。Python3禁止隐式混合字节型与字符型,不支持直接拼接字符串与字节流(Python2中会自动转换),也不支持在字节流中搜索字符串或将字符串传入仅接受字节流的函数。
str类型与bytes类型之间的相互转换方法如下:
字符串类str提供了一个encode()方法,用于将字符串编码为字节流。
bytes类则提供了一个decode()方法,用于将字节流解码为字符串。
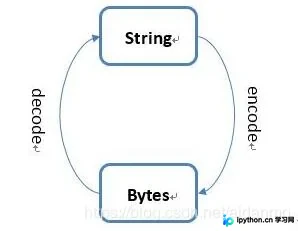
字符串与字节流的encode与decode机制
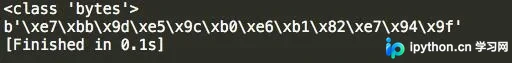
以下是encode编码过程的示例:
s = '绝地求生'
ss = s.encode()
print(type(ss))
print(ss)
运行结果如下:
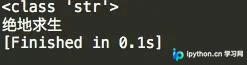
以下是decode解码过程的示例:
s = b'\xe7\xbb\x9d\xe5\x9c\xb0\xe6\xb1\x82\xe7\x94\x9f'
ss = s.decode()
print(type(ss))
print(ss)
运行结果如下:
\xe6\x97\xa0\xe6\xb3\x95格式乱码转换实战
了解了基本的转化流程后,回到本文主题:如何将'\xe7\xbb\x9d\xe5\x9c\xb0\xe6\xb1\x82\xe7\x94\x9f'这种格式转换为汉字输出?
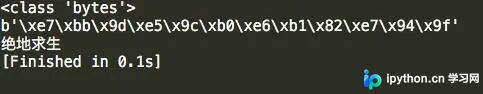
核心问题在于将bytes类型的内容以汉字形式展示,但该部分内容当前为字符串类型。因此,需先将该str转换为bytes类型,再通过decode解码为str输出。此处需使用encode('raw_unicode_escape')方法。此外,也可直接使用decode('raw_unicode_escape')方法,输出内容为bytes形式的字符串。
s = '\xe7\xbb\x9d\xe5\x9c\xb0\xe6\xb1\x82\xe7\x94\x9f'
ss = s.encode('raw_unicode_escape')
print(type(ss))
print(ss)

sss = ss.decode()
print(sss)
运行结果:
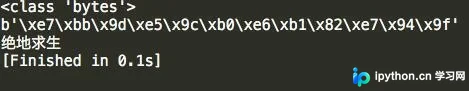
补充方法:若直接定义bytes类型的变量,可直接使用str(s, 'utf8')的方式输出汉字。
s = b'\xe7\xbb\x9d\xe5\x9c\xb0\xe6\xb1\x82\xe7\x94\x9f'

print(type(s))
print(s)

ss = str(s, 'utf8')
print(ss)
运行结果:
网络抓取网页中的中文乱码处理
第二种方法同样适用于输出从网络直接抓取的网页中包含的中文字符。
我们使用以下代码抓取www.baidu.com的网页内容:
import urllib.request
response = urllib.request.urlopen('http://www.baidu.com')
html = response.read()
print(html)
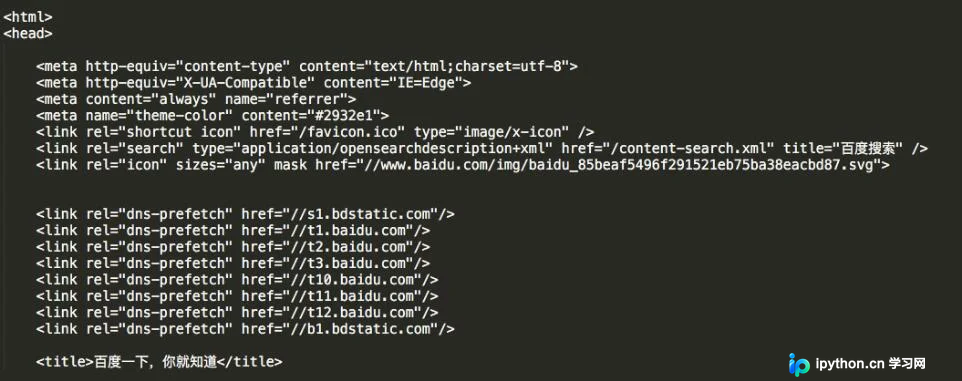
显示结果中,中文部分可能以\xe7\x99\xbe\xe5\xba\xa6\xe4\xb8\x80等形式呈现,此时可使用方法二进行转换。
import urllib.request
response = urllib.request.urlopen('http://www.baidu.com')
html =str(response.read(),'utf-8')
print(html)
最终结果如下:
以上即为Python3处理乱码及\xe6\x97\xa0\xe6\xb3\x95字符编码转换的完整方案,希望能为各位提供参考,欢迎支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









