

Python爬虫与反爬虫技术解析:策略、成本与实战博弈

发布时间:2026-10-14| 3人浏览过
本文深入解析Python爬虫与反爬虫的对抗机制,涵盖自动获取数据原理、常见反爬策略如IP封禁的成本与误伤风险,以及数据保护与商业竞争背景下的防御目的。通过梳理实战中的攻防策略,帮助开发者理解如何在获取数据与防止滥用之间取得平衡,适用于Python及相关技术栈的开发者参考。
爬虫与反爬虫的博弈概述
在数据采集领域,爬虫程序与反爬机制之间存在着持续的博弈:一方致力于高效获取网站数据,另一方则运用技术手段阻断这种获取行为。这场关于数据控制权的较量,最终胜负往往取决于技术迭代的速度与策略的适应性。
核心概念重述
为了更有效地应对这一挑战,我们需要重新审视爬虫相关的基础概念及其演变。
- 爬虫本质上是一种自动化程序,其核心功能是自动从互联网上抓取和获取网站公开或非公开的数据内容。
- 反爬虫则是网站方采取的一系列技术措施,旨在识别并阻止自动化程序对数据的非法或过度抓取,以保护服务器资源和数据资产。
- 误伤是反爬虫策略中常见的问题,即系统错误地将普通正常用户识别为爬虫并加以限制。这种情况在IP封禁策略中尤为突出,例如学校、小区或企业网络往往共享同一个公共出口IP。若因个别IP的恶意行为而封锁整个IP段,将导致大量正常用户无法访问网站。因此,单纯的IP封禁并非最佳策略,通常采用限制特定IP在一段时间内的访问频率或权限更为合理。
- 实施反爬虫措施需要投入相应的人力与计算资源,包括服务器负载、算法维护及监控系统的运营成本。
- 拦截效果与误伤率之间往往存在权衡关系。一般来说,拦截率越高,意味着判定标准越严格,从而可能导致正常用户被误判为爬虫的概率增加。
反爬虫策略的成本与风险
理解反爬虫的根本目的,有助于制定更合理的攻防策略。
- 初级开发者编写的爬虫往往缺乏对目标服务器压力的考量,策略简单粗暴,甚至可能因高频请求导致目标网站服务瘫痪。
- 数据保护是反爬虫的重要动机之一。对于许多企业而言,核心数据是其竞争优势所在,防止竞争对手或未经授权者通过爬虫获取这些数据至关重要。
- 商业竞争也是驱动反爬虫策略的重要因素。以电商平台为例,若竞争对手通过程序大规模爬取商品信息与价格数据,并据此制定针对性的营销策略,将对原平台造成巨大的商业冲击。因此,防止数据被恶意爬取成为维护市场竞争秩序的关键。
对抗策略与实战分析
随着技术的进步,爬虫与反爬虫之间的对抗不断升级,双方都在寻求更高效的解决方案。
面对“上有政策,下有对策”的现状,业界总结并整理了一系列常见的爬虫与反爬虫对抗策略,供开发者参考与实践。
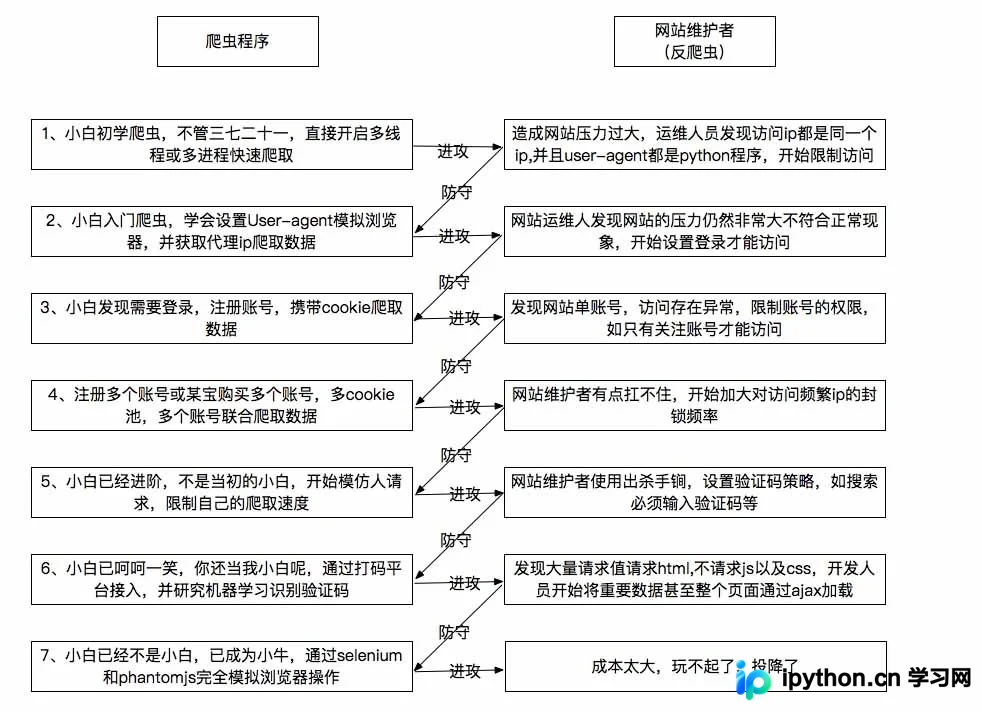
以上内容详细阐述了Python爬虫与反爬虫的核心技术与策略,更多关于Python爬虫与反爬虫的深入资料,建议关注本站发布的其他相关文章以获取持续更新。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









