在Scrapy中集成PhantomJS实现异步AJAX爬取
本文介绍如何在Scrapy中集成PhantomJS以实现异步AJ数据爬取。通过重写Downloader并引入Semaphore控制并发,解决传统同步集成的性能瓶颈。代码展示了如何配置PhantomJSDownloadHandler,利用线程池和队列管理浏览器实例,从而在保持Scrapy高效并发能力的同时,处理需要JavaScript渲染的网页内容。
2026-10-13
6

本文介绍如何在Scrapy中集成PhantomJS以实现异步AJ数据爬取。通过重写Downloader并引入Semaphore控制并发,解决传统同步集成的性能瓶颈。代码展示了如何配置PhantomJSDownloadHandler,利用线程池和队列管理浏览器实例,从而在保持Scrapy高效并发能力的同时,处理需要JavaScript渲染的网页内容。
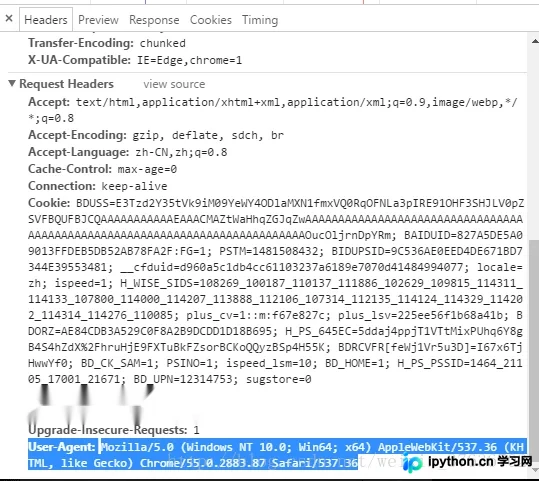
本文详解Python3中利用urllib模块应对网站反爬虫策略的方法。通过构造Request对象并添加包含User-Agent的headers字典,可模拟浏览器访问行为,有效绕过基于请求头鉴别的反爬检测。文中提供了完整的代码示例及API说明,帮助开发者实现更稳定的数据采集。
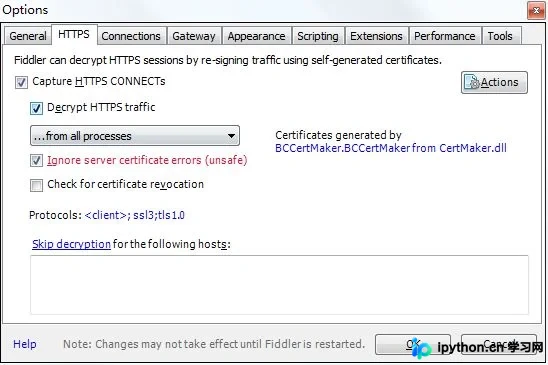
本文详细讲解如何使用Python3配合Fiddler工具抓取手机APP接口数据。内容涵盖Fiddler安装配置、手机代理设置、证书信任及抓包测试,并以王者荣耀盒子APP为例,演示如何解析英雄与装备接口数据,最终提供完整的Python爬取代码供参考。
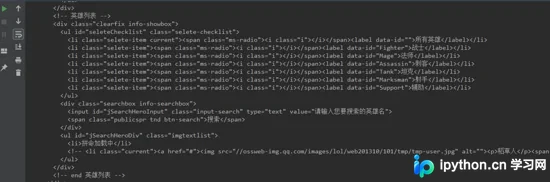
本文详细解析了使用Python3抓取英雄联盟英雄皮肤大图的技术路径。通过分析网页源码中的JavaScript文件,定位英雄列表及皮肤URL拼接规则,利用requests和json模块实现自动化下载。文章提供了完整的Python3.6运行环境配置、依赖模块说明及GitHub源码链接,帮助开发者掌握前端数据提取与后端爬虫结合的实现方法。
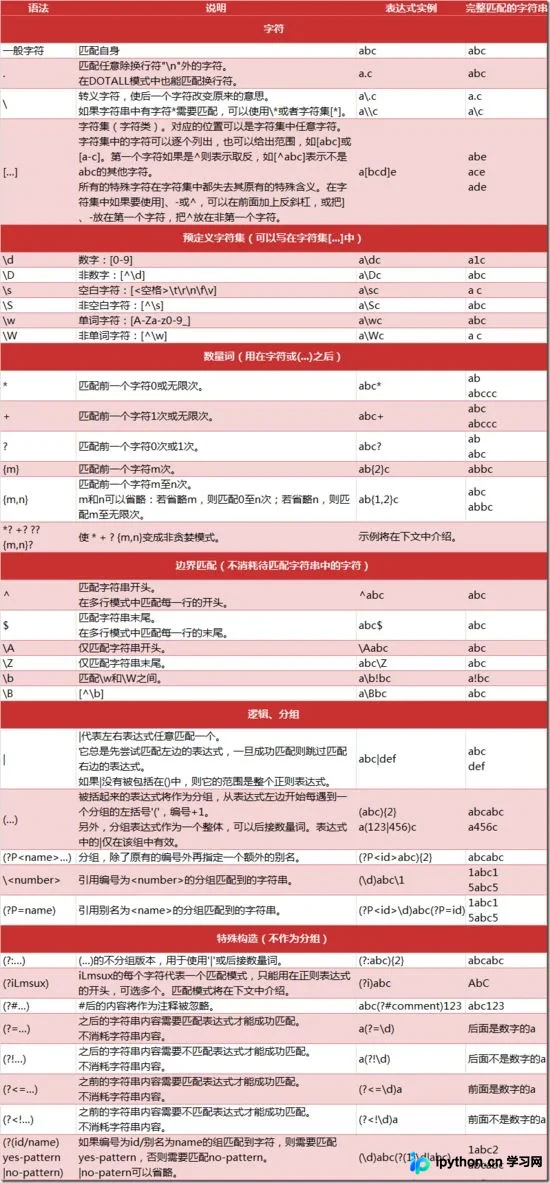
本文详解Python中re模块的核心用法,涵盖match与search的区别、贪婪与非贪婪匹配、分组提取及编译优化。通过HTML解析、字符串替换等实例,演示如何高效利用正则表达式进行数据抓取与处理,助力爬虫开发。
本文分享使用Python爬取微信公众号文章的完整代码示例。通过构建IP代理池、多线程并发抓取页面链接及内容,并存储至MySQL数据库,实现了高效的数据采集方案。代码包含详细的请求处理、异常捕获及线程同步逻辑,供开发者参考学习。
本文介绍如何利用Python分析Ajax请求来抓取今日头条的街拍图集。通过解析返回的JSON数据获取图片列表,并结合多线程与MongoDB存储实现自动化抓取。文章提供了完整的代码示例及关键参数配置说明,帮助开发者掌握动态网页数据抓取技巧。
本文介绍使用Python标准库urllib实现网页图片抓取的完整流程。通过构造请求头、解析HTML获取图片链接并保存至本地文件夹,演示了基础爬虫逻辑。针对目标网站已启用反爬算法导致无法获取有效图片的情况,文章记录了这一现象及尝试调整格式后的结果,仅供Python初学者参考学习。
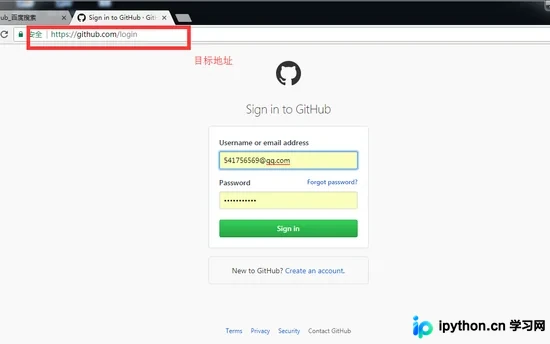
本文详细解析使用Python爬虫登录GitHub的技术流程。通过分析登录页面,提取CSRF Token与初始Cookie,利用Requests库发送GET请求获取必要参数,随后构造POST请求提交用户名和密码完成身份验证。最后演示如何携带登录后的Cookie访问个人详情页,实现自动化信息查看。
本文详细介绍如何使用Python的urllib2库实现网易邮箱的模拟登录。通过配置代理IP、处理CookieJar、构造POST请求及解析响应HTML,完成身份验证并获取登录后的页面内容。代码包含完整的请求头设置与URL跳转处理,适用于Python 2环境下的自动化登录场景。
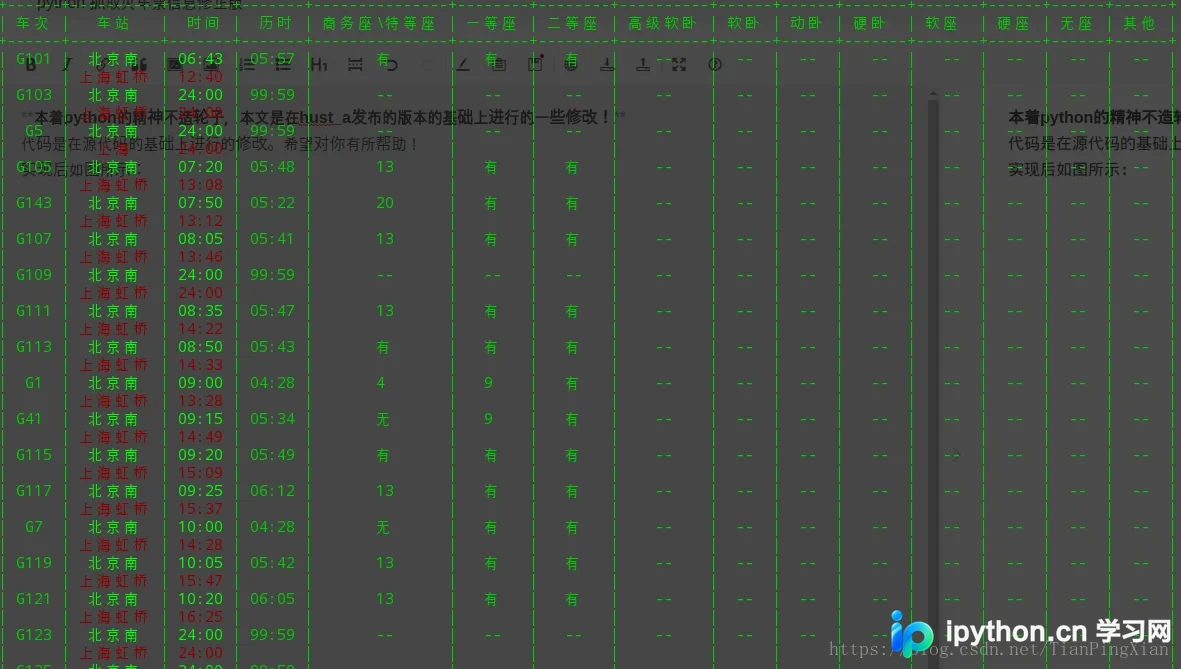
本文介绍基于Python3的12306火车票查询程序实现。通过抓取车站名称JS文件获取车站字典,利用urllib和requests库构建查询URL。代码包含日期格式化、学生票判断及终端彩色输出功能,最终使用PrettyTable展示车次、余票等详细信息,并提供完整源码链接供参考。
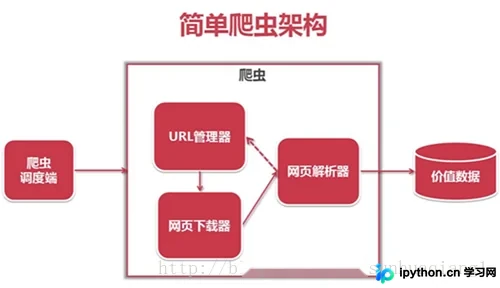
本文深入解析Python爬虫的核心架构,详细阐述URL管理器、HTML下载器及HTML解析器的功能与实现。通过完整代码示例,展示如何构建爬虫调度程序,实现网页数据的抓取、解析与输出。适合希望掌握Python爬虫基础原理与实战开发的开发者参考。