

Python爬虫实战:抓取多页天涯帖子及数据清洗技巧
本文介绍使用Python抓取多页天涯论坛帖子的实战技巧。重点解析BeautifulSoup中find_all与select的选择器差异,演示如何利用zip函数合并作者与内容数据,并构建双层URL结构实现分页抓取,同时探讨多属性筛选的可行性。
2026-10-13
6

本文介绍使用Python抓取多页天涯论坛帖子的实战技巧。重点解析BeautifulSoup中find_all与select的选择器差异,演示如何利用zip函数合并作者与内容数据,并构建双层URL结构实现分页抓取,同时探讨多属性筛选的可行性。
本文详解Python爬虫中GET与POST请求的区别及适用场景,重点解析Cookie在维持会话状态中的作用。通过163邮箱实例,演示如何利用Requests库发送请求,并解决SSL证书过期导致的SSLError问题,提供verify=False的解决方案及完整代码示例。
本文深入解析Python urllib库的高级用法,重点讲解如何利用Request方法构建Headers模拟浏览器进行POST数据提交,并详细剖析通过ProxyHandler定制Opener以配置代理IP解决反爬限制的技巧。内容涵盖参数解析、编码规则及异常处理,助力提升爬虫效率与稳定性。
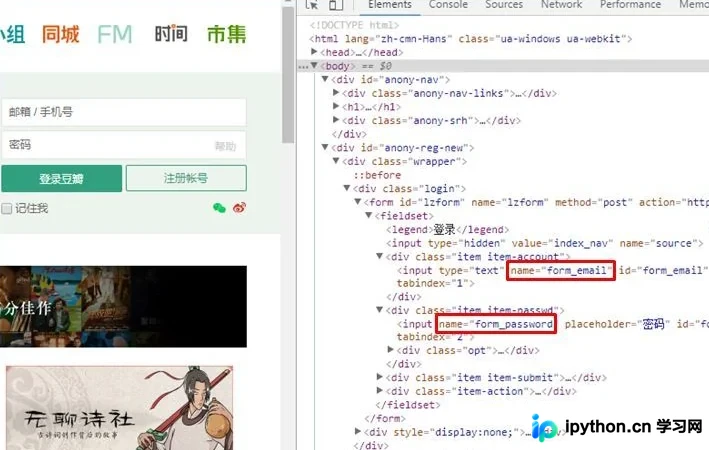
本文详解Scrapy框架应对常见反爬机制的策略。涵盖通过中间件随机User-Agent、处理Referer与Cookies、利用X-Forwarded-For伪装代理,以及配置带认证的代理IP。针对动态加载内容,介绍通过Ajax接口分析或结合Selenium与PhantomJS模拟浏览器渲染的方法,并提供相关代码实现与注意事项。
本文详解使用Python登录CSDN并抓取博客文章列表的完整流程。通过Fiddler分析登录接口,解决参数错误、JS跳转及正则匹配等常见问题,提供可直接运行的代码实例,帮助开发者掌握Web自动登录与数据抓取技巧。
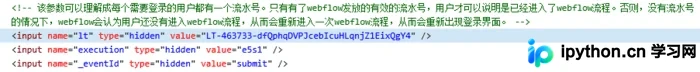
本文详解Python爬虫中如何利用Urllib库保存和复用Cookie实现网站自动登录。通过解析urlopen参数、构造Request对象及设置Headers,结合POST/GET请求示例,展示从抓包分析到代码实现的完整流程,帮助开发者突破登录限制。
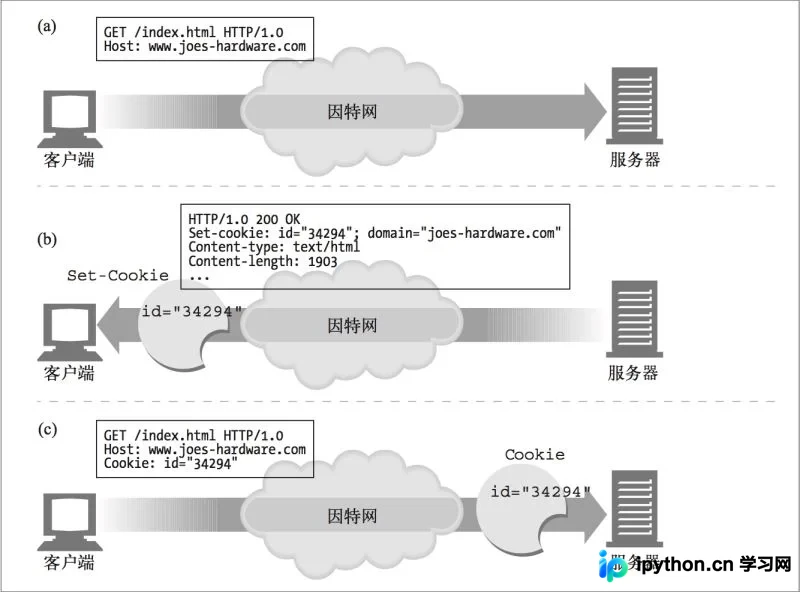
本文深入解析Python爬虫中Cookie与Session的核心机制。详细阐述Cookie作为客户端存储的身份标识,涵盖Version0与Version1的属性差异及过期策略;解析Session如何通过唯一ID减少数据传输并保障服务器性能。对比两者在安全性、存储位置及适用场景上的区别,帮助开发者优化爬虫策略与Web交互逻辑。
本文详细演示了使用Python进行数据抓取与分析的完整流程。通过requests获取页面,利用BeautifulSoup和XPath解析HTML及JS动态数据,并将结果存入MongoDB。文章涵盖分类网址获取、产品详情页抓取、数据清洗入库及异常处理等核心步骤,提供具体代码实现供参考。
本文提供基于Python和Selenium库的淘宝登录及数据爬取代码示例。通过模拟浏览器操作实现账号登录,并演示如何抓取特定网页内容。文中指出该方法可能触发平台风控,建议根据实际需求调整策略,并提到不登录模式在某些场景下可能更为有效。
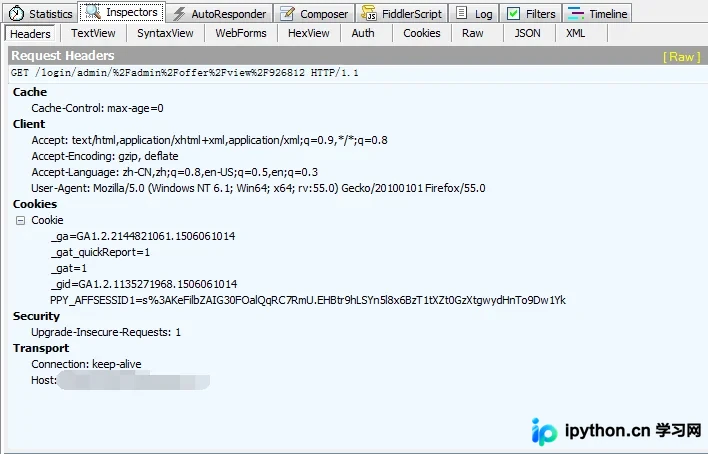
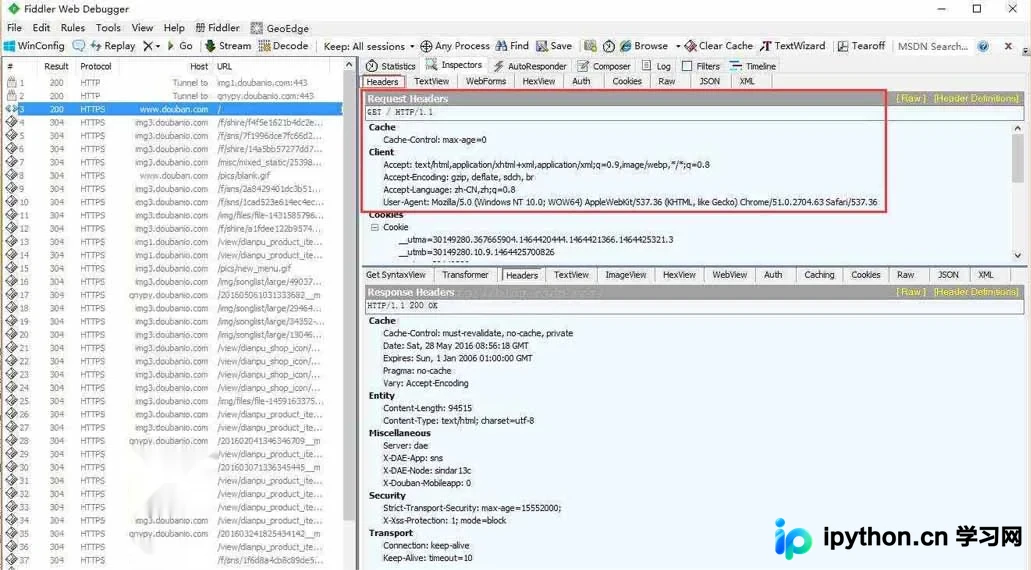
本文详解如何在Python爬虫中伪装浏览器以获取正常响应。通过Fiddler工具抓取豆瓣网站的真实请求头,提取User-Agent等关键信息,并在代码中自定义Request Headers进行模拟。附带完整Python示例代码及运行结果分析,帮助开发者解决反爬限制问题。
本文详解Python中使用requests库爬取网页时常见的中文乱码问题。通过分析网页源码确定编码格式,并演示如何利用decode与encode方法将内容转换为GBK编码,从而正确显示中文内容。
本文详解在Python中使用requests库进行网络请求时如何添加Cookies参数。通过解析浏览器审查元素中的加密Cookie字符串,演示将其转换为字典格式并传递给get方法的过程。涵盖从获取原始Cookie、解析保存至本地文件,到最终在请求中应用Cookies的完整代码示例,帮助解决爬虫中的身份验证与状态保持问题。