

Python3使用urllib和BeautifulSoup实现自动投票功能
本文详细介绍如何利用Python3标准库urllib结合BeautifulSoup解析HTML,实现自动投票功能。通过获取Cookie、解析动态验证码并提交POST请求,完成投票逻辑。代码包含完整的请求头设置与数据封装示例,适用于需要批量处理投票场景的开发参考。
2026-10-13
6

本文详细介绍如何利用Python3标准库urllib结合BeautifulSoup解析HTML,实现自动投票功能。通过获取Cookie、解析动态验证码并提交POST请求,完成投票逻辑。代码包含完整的请求头设置与数据封装示例,适用于需要批量处理投票场景的开发参考。
本文详细对比了Python2与Python3在进行网络爬虫开发时,使用urllib模块发起Get和Post请求的代码差异。重点解析了从urllib2到urllib.request的模块迁移,以及数据编码、请求构造和响应处理的具体实现方式,帮助开发者快速掌握版本升级后的代码适配方法。
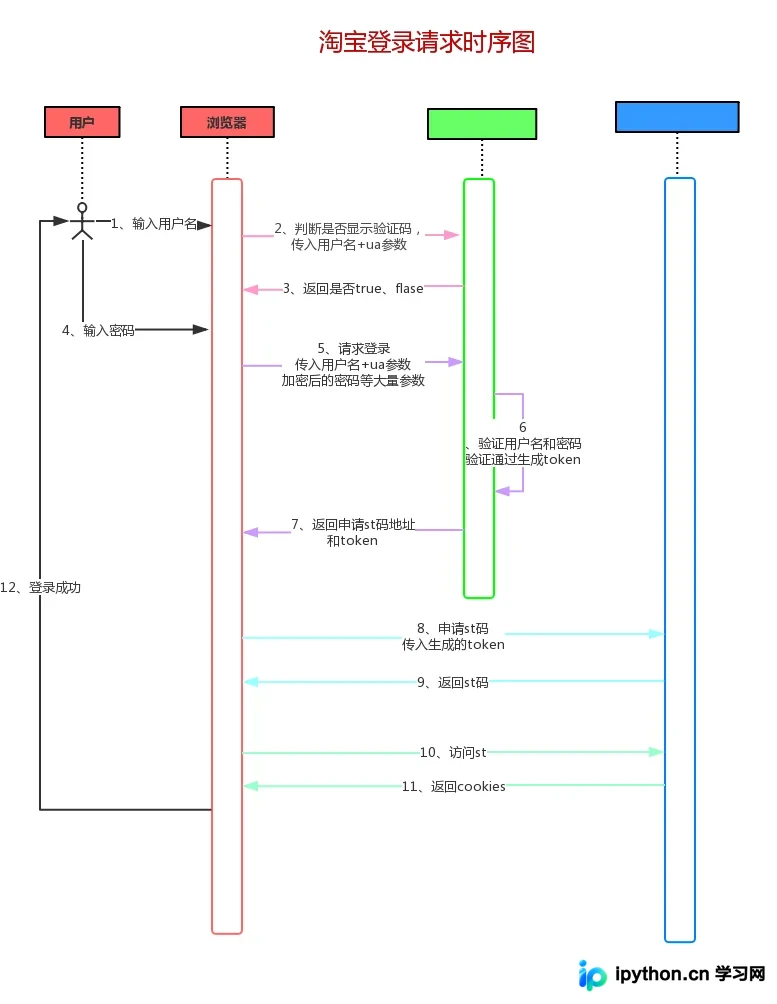
本文详细讲解如何使用Python Requests库模拟登录淘宝,并重点介绍2.0版本新增的Cookie持久化功能。通过序列化与反序列化技术,实现登录状态的文件保存与自动读取,避免每次运行重新登录。文章涵盖四步登录法、代码重构及完整的测试流程,适用于需要长期维持登录状态的爬虫开发场景。
本文探讨Python爬虫中URL包含字典或列表等非字符串参数时的编码问题。通过对比直接urlencode与先进行json序列化再urlencode两种方法,展示Python2环境下生成的URL差异,并建议当直接编码导致访问失败时,采用json序列化方式以确保参数正确解析。
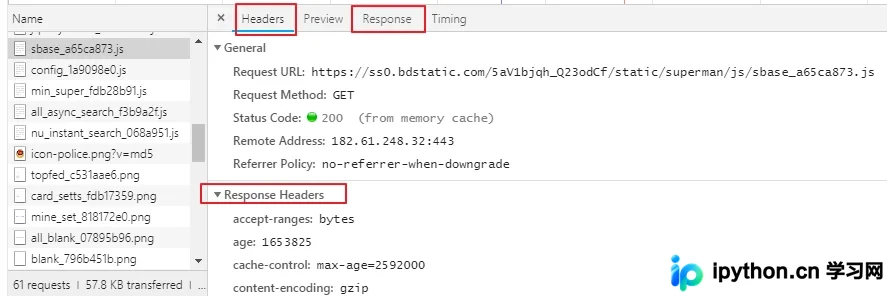
本文详解Python爬虫中User-Agent(UA)的作用及反爬原理。通过对比默认urlopen与自定义Request对象,演示如何获取浏览器UA并封装进headers字典,成功伪装爬虫身份以绕过网站检测。包含搜狗搜索抓包获取UA及完整代码示例,帮助开发者解决基础反爬问题。
本文详解如何使用Python监控各类数字资产钱包余额。针对提供API的区块浏览器(如btc.com、etherscan.io),介绍直接调用接口及单位换算方法;针对无API的浏览器(如chainx.org),演示通过开发者工具抓取XHR请求进行数据解析。结合钉钉机器人实现余额变动实时提醒,涵盖BTC、ETH及ERC20代币的完整监控方案。
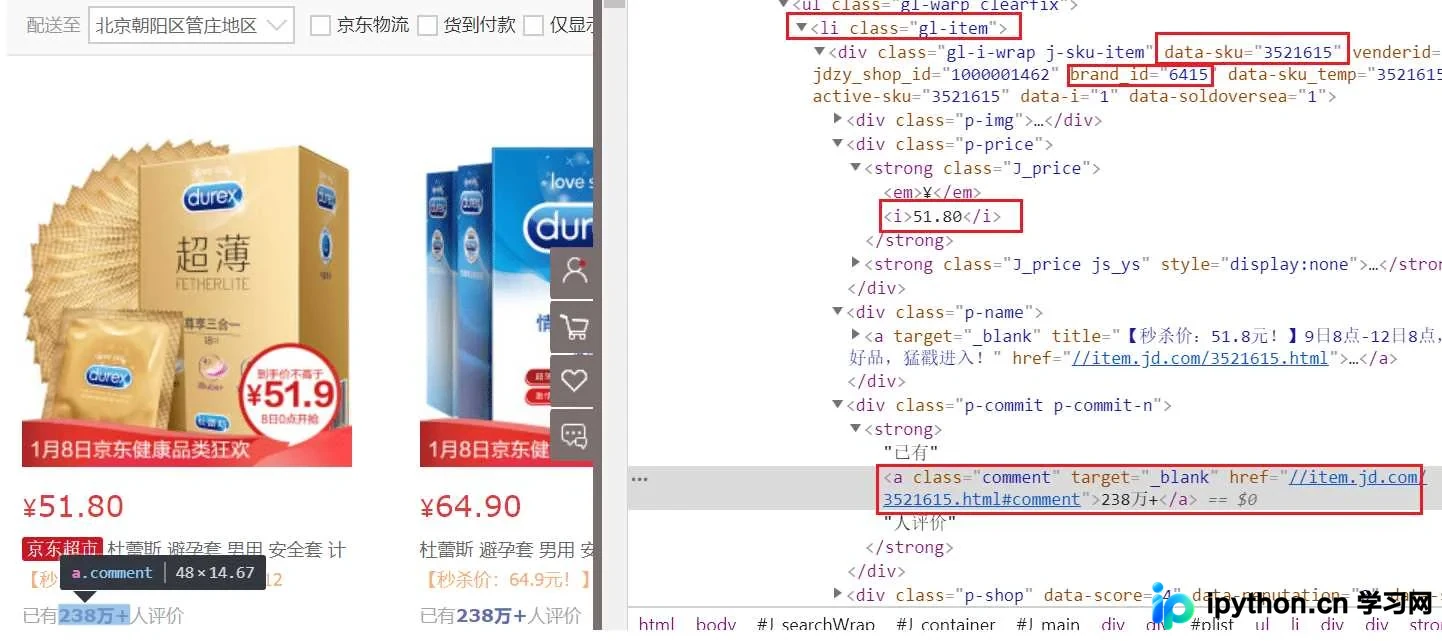
本文详解如何利用Selenium技术抓取京东平台成人用品的产品信息与评论数据,并存入MongoDB数据库。通过对8934款产品及17万条评论的分析,揭示了销量领先的品牌分布、热门产品特征及购物节对销量的显著影响,为电商数据分析提供实战参考。
本文介绍如何使用Python2结合Bs4库解析腾讯社招页面,提取职位名称、类别、人数、地点及发布时间等关键信息。重点解决Python列表直接写入Json文件时中文乱码问题,通过序列化及UTF-8编码确保数据正确存储,最终将结果保存为Json格式文件供后续使用。
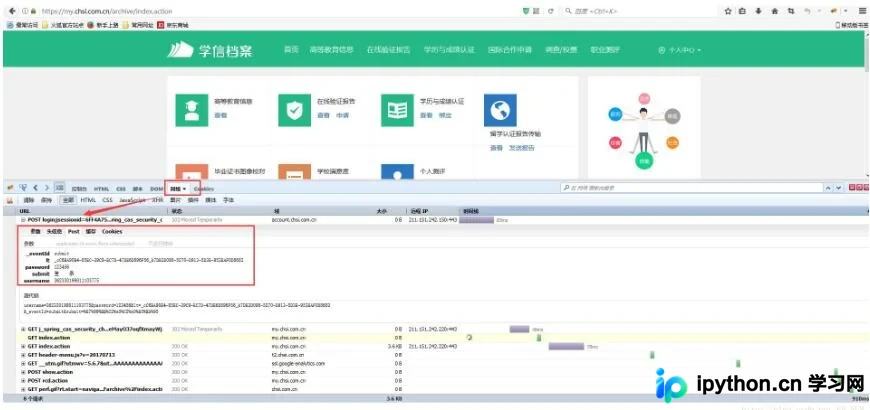
本文以学信网为例,详细介绍如何使用 Python 模拟登录并爬取个人信息。通过 Firefox 开发者工具分析网络请求,定位 POST 提交链接及表单参数,利用 requests 库和 BeautifulSoup 构造会话与提交数据,最终实现自动登录并解析页面表格内容,为类似网站的爬虫开发提供参考。
本文介绍如何在Python爬虫项目中实现中断重连与断点续爬功能,以应对网站验证或IP封禁导致的程序中断。通过维护新URL与已爬取URL集合,并将数据持久化至文件,避免内存溢出。文中提供了基于文件操作的URL管理器类及获取最后一行数据的详细代码实现,帮助开发者快速集成该功能。
本文详细解析使用Python实现网络投票自动化的关键技术,包括突破验证码识别、IP限制及Cookie保持机制。通过urllib2库模拟浏览器请求,结合Tesseract OCR进行验证码识别,并配置代理服务器以维持会话状态,提供完整的代码实现思路与注意事项。
本文介绍在Python爬虫程序中验证代理IP是否成功配置的方法。通过访问httpbin.org/ip获取当前出口IP,并结合ip138.com进行比对,可确认代理是否生效。文中提供了基于requests库的完整代码示例,包含动态隧道代理的配置与IP切换头设置,帮助开发者快速排查代理连接问题。