Python实现复杂Post请求数据爬取实战:Query与Body共存场景解析
本文详解如何利用Python的requests库爬取包含复杂参数的Post接口。针对部分网站要求同时传递Query字符串参数与空的JSON Body以触发反爬机制的特殊场景,提供了具体的代码实现方案。文章分析了请求头配置、参数序列化及raw格式提交的关键点,帮助开发者解决此类逆向工程难题。
2026-10-13
6

本文详解如何利用Python的requests库爬取包含复杂参数的Post接口。针对部分网站要求同时传递Query字符串参数与空的JSON Body以触发反爬机制的特殊场景,提供了具体的代码实现方案。文章分析了请求头配置、参数序列化及raw格式提交的关键点,帮助开发者解决此类逆向工程难题。
本文演示如何使用Python的urllib库获取基金网站网页内容,并利用BeautifulSoup库解析HTML结构。通过具体代码示例,展示如何读取网页源码、处理编码问题,并提取基金编码、名称及净值等关键信息,供Python开发者参考学习。
本文深入解析Python中requests模块的核心用法,涵盖GET请求的参数传递、响应内容解析及请求头设置,以及POST请求的数据、JSON、文件上传和Cookie处理。通过具体代码示例,演示如何高效进行网络交互,并包含超时控制等关键配置,帮助开发者快速掌握HTTP请求处理技巧。
本文介绍如何使用Python结合Selenium和Requests库,自动化获取前程无忧职位的竞争力得分与匹配度评价。通过解析页面结构提取职位ID,利用MongoDB去重存储数据,并筛选高匹配度职位进行批量自动投递,旨在提高求职效率。
本文详解如何使用Python的requests库模拟豆瓣6.0新版网站的登录过程。通过开发者工具分析POST请求接口与数据格式,利用Session保持Cookie状态,成功获取个人首页内容。针对新版反爬策略,提供了完整的代码示例与关键步骤解析,帮助开发者解决登录失败问题。
本文通过Python实战案例,详细解析如何模拟登录CSDN平台。内容涵盖从导入必要库、获取请求头部信息、解析网页结构,到维持登录状态Session及验证登录结果的完整代码流程。旨在帮助开发者理解模拟登录的核心逻辑,提升Python网络编程与爬虫开发能力。
本文系统介绍Python爬虫的基本概念、应用场景及合法性边界。详细解析常见的反爬虫手段,如IP限制与数据投毒,并梳理Python在爬虫开发中的核心优势。重点列举了请求处理、多线程、正则解析、JSON处理及DOM解析等关键模块,为开发者提供清晰的技术选型参考。
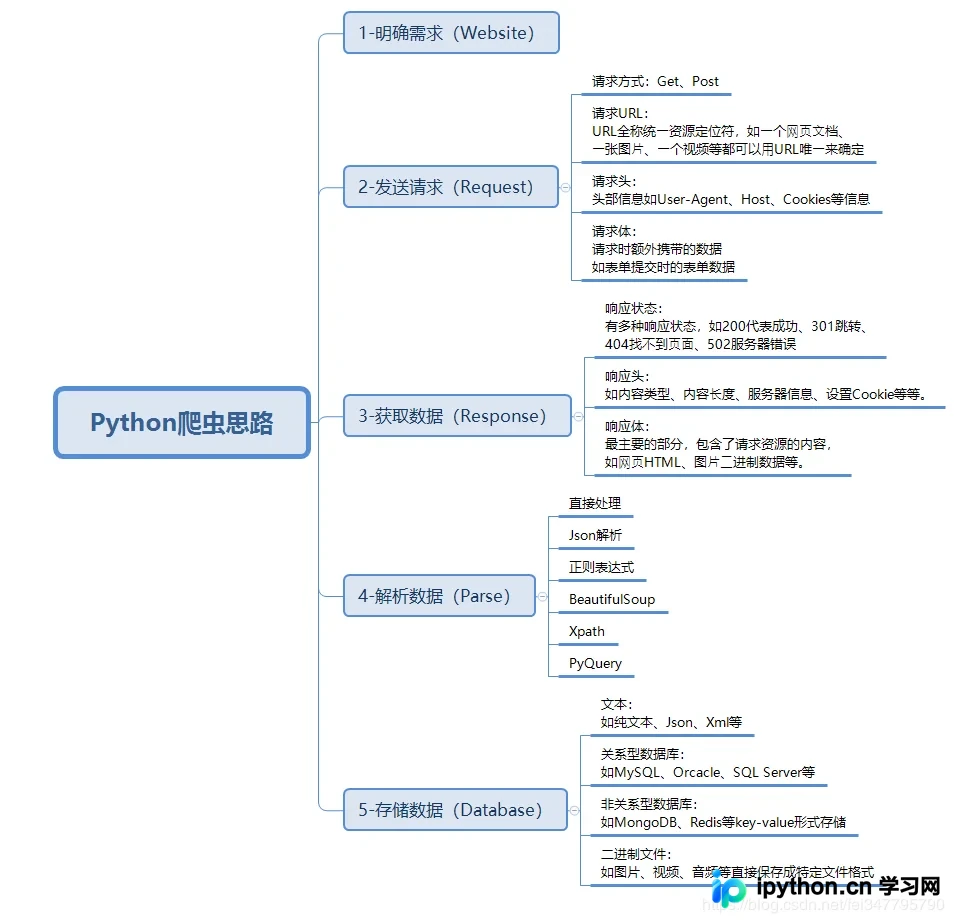
本文针对Python3爬虫中常见的编码错误,深入解析Unicode与bytes的转换机制。详细说明了字符串encode与bytes decode的区别,以及在不同文件写入模式('w'与'wb')下如何正确处理编码参数。通过网页抓取实例,展示了如何避免TypeError和UnicodeEncodeError,确保数据正确存储。
本文基于《Python3网络爬虫开发实践》案例,针对腾讯网站更新后导致的Cookie登录失效问题提供解决方案。通过整合Selenium浏览器自动化与代理池技术,详细演示了如何配置Chrome驱动、设置请求头及处理重试机制,帮助开发者应对反爬策略变更,实现稳定的微信文章数据抓取。
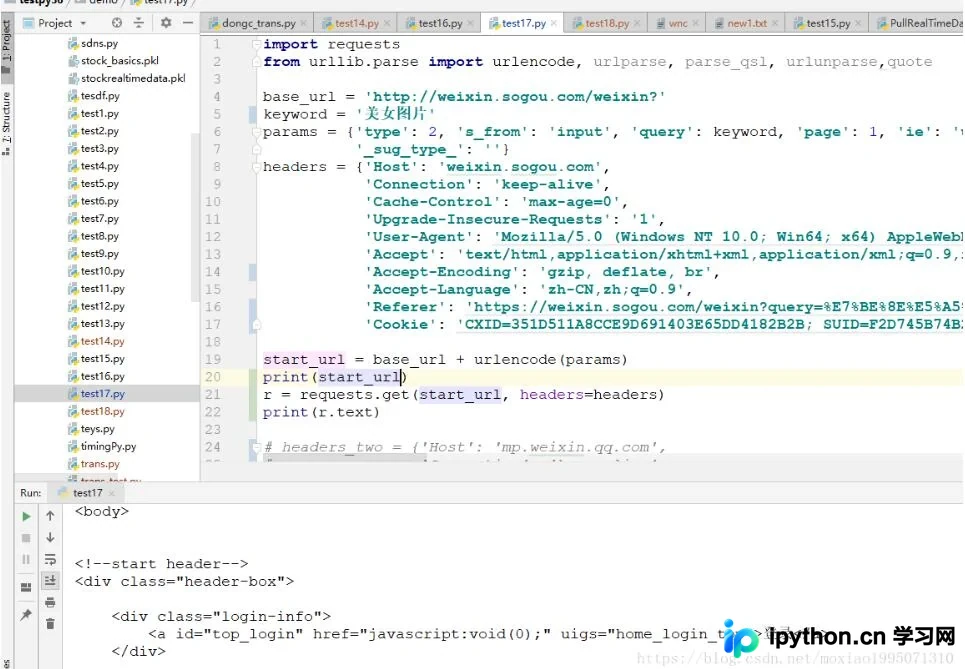
本文分享利用Python抓取CNVD工控漏洞库信息的完整流程。针对网站反爬虫机制,通过模拟请求头、Cookie及Selenium自动化浏览器技术解决访问限制。代码涵盖从分页URL抓取到详情页信息提取的全过程,旨在帮助安全研究人员高效整理漏洞数据。
本文详解Python中模拟登录的两种主要方式:直接复制浏览器Cookie与使用Session维持会话。重点解析为何普通请求无法保持登录状态,并通过代码示例展示如何利用requests.Session对象自动管理Cookie,实现跨请求的身份验证与数据获取,解决多页面交互中的会话断开问题。
本文详解Python爬虫中如何使用代理IP防止IP被封。通过urllib.request的ProxyHandler构建自定义opener,并调用install_opener设置全局代理,使urlopen默认使用代理IP。文中涵盖HTTP/HTTPS代理设置、端口配置及常见连接拒绝错误的排查方法,帮助开发者实现稳定的数据抓取。