

Python3爬虫应对反爬机制:利用Request模拟浏览器头信息

本文详解Python3中利用urllib模块应对网站反爬虫策略的方法。通过构造Request对象并添加包含User-Agent的headers字典,可模拟浏览器访问行为,有效绕过基于请求头鉴别的反爬检测。文中提供了完整的代码示例及API说明,帮助开发者实现更稳定的数据采集。
本文介绍Python3环境下应对网站反爬虫机制的具体实现方法,供读者参考学习。
应对网站反爬虫机制的策略
在访问部分网站时,服务器常通过检查请求是否携带特定的头文件(Headers)来鉴别访问来源是否为爬虫,以此作为反爬取的核心策略之一。
以访问搜狐首页为例,首先通过Chrome浏览器按F12打开开发者工具查看请求头信息,具体展示如下:
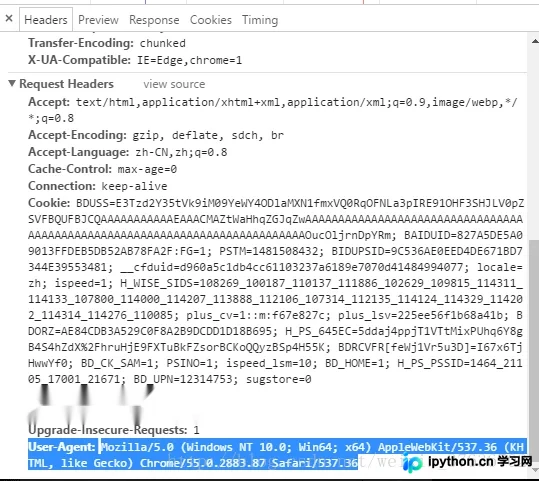
如图所示,访问头信息中包含了浏览器版本及操作系统等详细标识(Headers包含大量信息,具体字段含义可自行查阅文档)。
在Python中,urllib库的request模块提供了模拟浏览器访问的功能,相关实现代码如下:
from urllib import request
url = 'http://www.baidu.com'
# page = request.Request(url)
# page.add_header('User-Agent', 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36')
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}
page = request.Request(url, headers=headers)
page_info = request.urlopen(page).read().decode('utf-8')
print(page_info)
可以通过调用add_header(key, value)方法,或者在创建请求时直接以参数形式与URL一同提交进行访问。
urllib.request.Request()
urllib.request.Request(url, data=None, headers={}, origin_req_host=None, unverifiable=False, method=None)
其中,headers是一个字典对象,通过这种方式可以将爬虫程序伪装成正常浏览器对目标网站进行访问。 参考文档:https://docs.python.org/3/library/urllib.request.html?highlight=request#module-urllib.request
如需了解更多Python相关内容,可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》。
希望本文所述内容能对大家的Python程序设计工作有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









