Python爬虫模拟浏览器访问User-Agent详解
本文解析Python爬虫中通过设置User-Agent模拟浏览器访问的方法。通过urllib2构造请求对象并添加Headers,实现伪装浏览器身份进行数据抓取,同时展示获取响应状态码、URL及头部信息的技巧,帮助开发者规避基础反爬限制。
2026-10-13
6

本文解析Python爬虫中通过设置User-Agent模拟浏览器访问的方法。通过urllib2构造请求对象并添加Headers,实现伪装浏览器身份进行数据抓取,同时展示获取响应状态码、URL及头部信息的技巧,帮助开发者规避基础反爬限制。
本文详解Python爬虫中常见的UnicodeDecodeError异常原因,并提供两种通用解码策略:通过HTML标签提取charset自动解码,以及遍历utf-8、gbk等常用编码并配合errors='replace'参数尝试解析。通过对比数据完整性,推荐以实际数据表现选择最佳编码方式,有效解决网页抓取中的乱码问题。

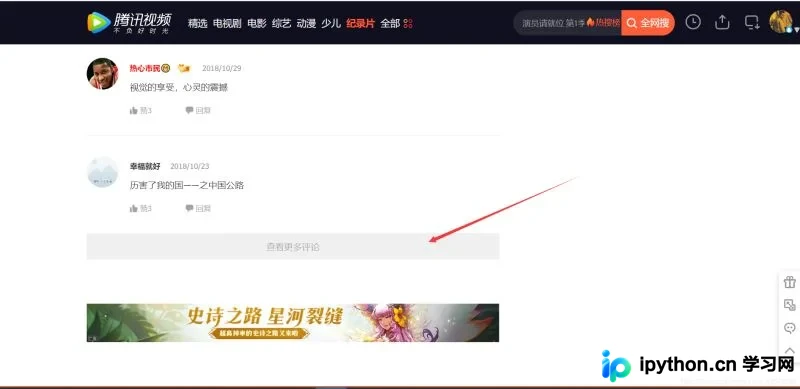
本文详解如何使用Python爬取腾讯视频纪录片评论。通过Fiddler抓包分析Ajax异步加载机制,解析评论接口URL规律,重点推导cursor参数的获取逻辑。结合Python代码实现自动翻页抓取,完整展示从环境配置、接口分析到代码编写的全过程,帮助开发者掌握动态网页数据抓取的核心技巧。
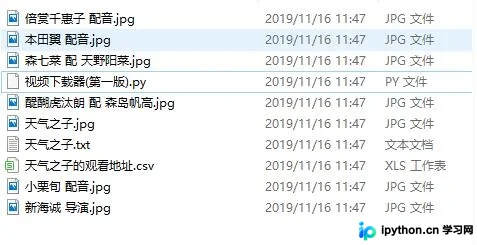
本文详细介绍如何使用Python的pyquery库爬取豆瓣电影信息。通过示例代码展示如何获取电影源代码、解析链接并提取观看地址。文章包含完整代码逻辑及输入“天气之子”、“独立日”等电影名的运行结果截图,强调仅上映电影可获取观看链接,为Python学习者提供实用的爬虫参考。
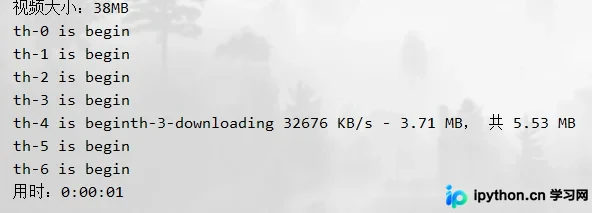
本文介绍使用Python实现多线程下载视频的方法。通过解析视频文件大小动态计算线程数,最大支持10个线程以提升下载速度。文章指出获取视频原链是主要难点,涉及反爬机制,建议结合爬虫技术解决。代码包含进度显示与错误处理,适合需要快速下载大文件场景。
本文介绍利用Python和OpenCV库进行简单验证码降噪的完整流程。内容涵盖图像灰度化处理、二值化阈值设定以及基于8邻域算法的噪声过滤方法,并提供完整的Python实现代码,帮助开发者解决爬虫中常见的简单图形验证码识别问题。
双十一期间“明降暗升”现象频发,本文介绍使用Python构建定时监控工具的方法。通过requests库抓取天猫、京东等平台数据,结合Windows任务计划或Linux crontab实现定时执行,并利用pyecharts绘制价格变化折线图。工具支持多平台比价,帮助消费者识别先涨后降的虚假优惠,还原商品真实价格走势。
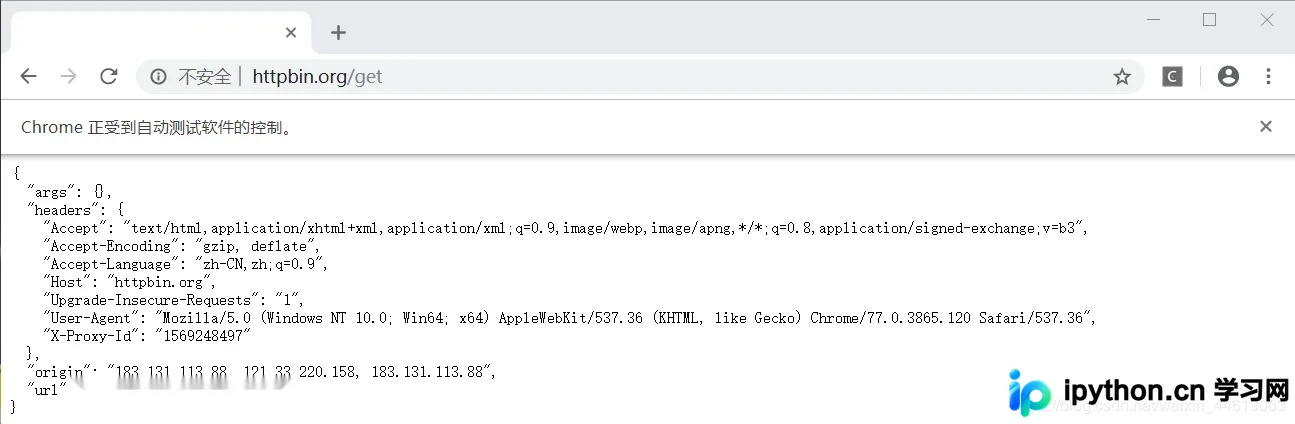
本文详解Python爬虫中代理IP的配置方法,涵盖Urllib、Requests及Selenium三种主流库的代理设置。通过搭建代理池接口获取IP,并结合httpbin.org验证IP伪装效果,帮助开发者解决IP被封禁问题,提升爬虫稳定性与效率。
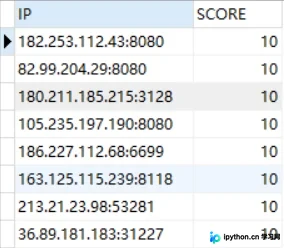
本文详解如何使用MySQL数据库存储Python代理IP池中的IP地址。通过定义MAX_SCORE、MIN_SCORE和INITIAL_SCORE等参数,实现IP可用性的动态评分机制。文章提供了完整的数据库连接配置、核心操作方法(添加、减分、获取)及抓取保存代码,帮助开发者构建高效、自动化的代理IP管理系统。
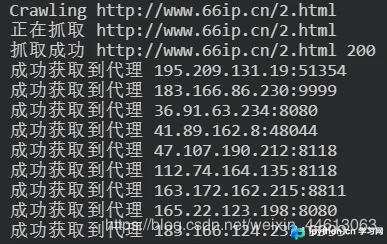
本文介绍如何使用Python构建代理IP池的第一步:获取IP。通过结合Requests和PyQuery库,利用自定义的ProxyMetaclass元类自动识别以crawl开头的方法,实现从多个免费代理网站批量抓取IP和端口。代码采用生成器模式返回数据,便于后续存储与检测,为反爬策略提供灵活的IP轮换方案。
本文详细介绍如何在Python中利用Selenium配合Headless Chrome进行网页内容抓取。文章涵盖Chrome及Chrome Driver的安装配置,解决国内源安装问题,并提供完整的Python代码示例,包括无头模式启动、页面加载超时设置及元素提取方法,适用于Linux环境下的自动化数据采集场景。
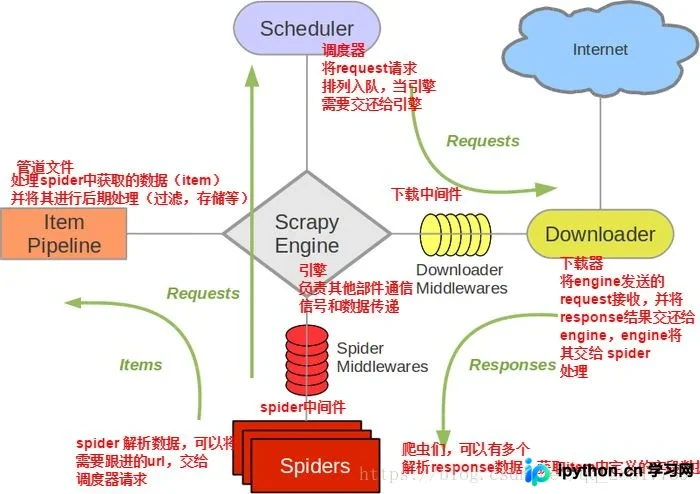
本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的抓取难题。通过重写爬虫构造方法与关闭方法管理浏览器实例,并在下载中间件中拦截Response对象,利用Selenium渲染页面后篡改响应数据,从而在Spider中获取完整的动态内容。