

Python内置模块urllib详解:URL解析、编码与解码实战
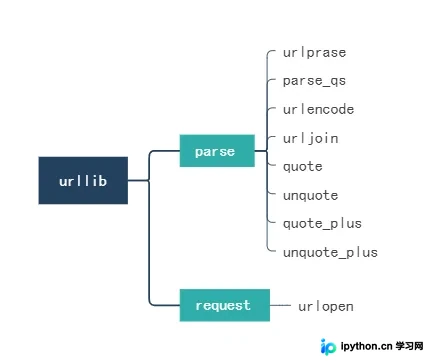
本文深入解析Python内置模块urllib,重点介绍urlparse、parse_qs、urlencode、quote及unquote等核心方法。通过实际代码示例,展示如何拆分URL、处理查询参数、进行字符编码与解码,帮助开发者高效处理网络请求中的URL操作。
2026-10-14
1

本文深入解析Python内置模块urllib,重点介绍urlparse、parse_qs、urlencode、quote及unquote等核心方法。通过实际代码示例,展示如何拆分URL、处理查询参数、进行字符编码与解码,帮助开发者高效处理网络请求中的URL操作。
本文探讨Python爬虫中URL包含字典或列表等非字符串参数时的编码问题。通过对比直接urlencode与先进行json序列化再urlencode两种方法,展示Python2环境下生成的URL差异,并建议当直接编码导致访问失败时,采用json序列化方式以确保参数正确解析。
本文详细介绍如何使用Python正则表达式从京东网站抓取商品信息。通过构造包含关键词的URL,利用urllib库获取网页源码,并运用[\s\S]等正则模式精准提取商品数据。文章涵盖URL编码原理、正则匹配技巧及代码实现,帮助开发者掌握基础爬虫技能。
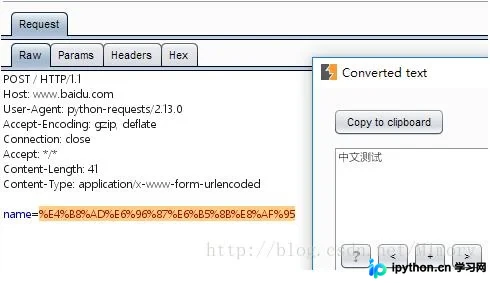
本文详细解析Python中处理含中文URL参数的常见需求,重点介绍urllib库中的urlencode和unquote函数。通过具体代码示例,展示如何将键值对转换为标准查询字符串,以及如何对单个字符串进行编码和解码操作,解决Callback等场景下的中文传递问题。

本文解决Django中FileField获取文件路径时出现的URL编码问题,提供使用urllib.parse.unquote解码的具体方案。同时详细解析FilePathField字段的path、match、recursive等参数用法,并结合缩略图生成场景给出完整代码示例与配置建议。
本文详解Python中利用urllib模块处理URL中文编码与解码的方法。通过urllib.quote进行编码(支持UTF-8和GBK),使用urllib.unquote进行解码,解决URL中特殊字符歧义及非ASCII字符传输问题,并提供完整代码示例。
本文详解Python爬虫中urllib模块处理URL编码的方法。针对包含非ASCII字符(如中文)的URL,直接请求会引发UnicodeEncodeError。通过urllib.parse.quote函数对特殊字符进行ASCII编码并拼接,可生成有效URL,确保爬虫程序正常发起请求并获取页面数据。
本文详细介绍Python3中处理URL编码与解码的核心方法。通过urllib.parse模块的quote和unquote函数,实现中文字符串到URL安全格式的转换及还原。文章提供完整代码示例与执行结果,帮助开发者快速掌握编码技巧,适用于API开发、数据交互等场景。
本文详解Python中requests模块处理中文参数的三种方式:字典自动编码、字符串原样输出及格式化导致bytes类型的问题。通过具体代码示例与注意事项,帮助开发者解决HTTP请求中中文参数编码异常,提供手动编码与自动编码的最佳实践建议。
本文介绍Python爬虫在请求包含中文或特殊符号的URL时常见报错问题,通过urllib.parse.quote函数进行安全编码处理,保留可打印字符,解决请求失败问题。
本文介绍在Python爬虫开发中如何处理包含中文的URL。直接使用未处理的中文会导致请求失败,需利用urllib.parse模块中的quote函数对中文部分进行单独编码,避免影响其他特殊字符,确保URL格式正确。

本文介绍Python中字符串与URL编码相互转换的具体实现。通过urllib模块的quote函数可将中文等字符编码为URL安全格式,利用unquote函数则可将编码还原为原始字符串。该功能常用于爬虫生成带搜索关键词的网址,确保参数传递正确。