

Python爬虫UA伪装实战:利用urllib.request突破反爬机制

本文详解Python爬虫中User-Agent(UA)的作用及反爬原理。通过对比默认urlopen与自定义Request对象,演示如何获取浏览器UA并封装进headers字典,成功伪装爬虫身份以绕过网站检测。包含搜狗搜索抓包获取UA及完整代码示例,帮助开发者解决基础反爬问题。
urllib基础请求与参数编码
本节介绍使用urlencode函数进行参数编码的方法。
核心函数为urllib.request.urlopen(),用于发起网络请求。
import urllib.request
import urllib.parse
url = 'https://www.sogou.com/web?'
#将get请求中url携带的参数封装至字典中
param = {
  'query':'周杰伦'
}
#对url中的非ascii进行编码
param = urllib.parse.urlencode(param)
#将编码后的数据值拼接回url中
url += param
response = urllib.request.urlopen(url=url)
data = response.read()
with open('./周杰伦1.html','wb') as fp:
  fp.write(data)
print('写入文件完毕')
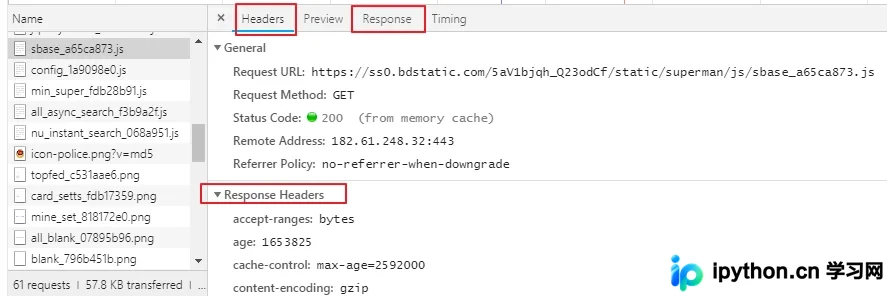
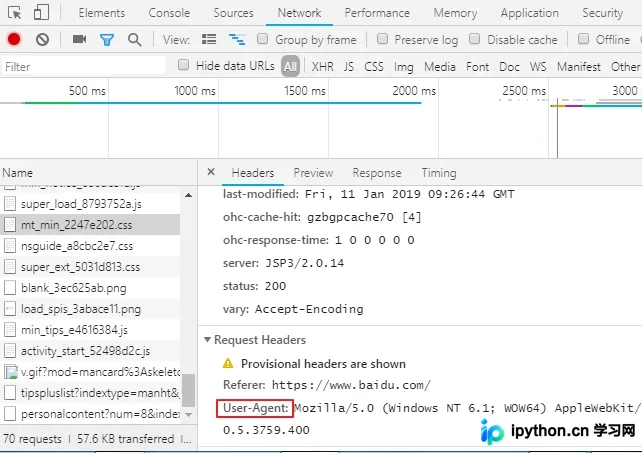
在浏览器中按下F12键或右键点击“检查”打开开发者工具,切换至Network(网络)标签页。刷新页面后,可查看网页资源列表及请求头信息,其中包含User-Agent(UA)字段。
在抓包工具中点击任意一个具体请求,即可查看该请求的完整信息,包括响应信息和请求头详情。
主要关注headers、response以及response headers(存放响应头信息)和request headers(存放请求头信息)等关键部分。
UA反爬机制原理
常见的反爬机制包括:网站会检查请求的User-Agent(UA),若识别出UA属于爬虫程序特征,则拒绝返回页面数据。
若网站检测到请求的UA符合主流浏览器标识(即由浏览器发起的请求),则判定为正常访问,并向客户端返回页面数据。
User-Agent(简称UA):用于标识请求载体身份的数据字段。
UA伪装与自定义请求对象实现
针对反爬机制的应对策略称为“反反爬”,核心思路是伪造UA。
具体做法是将爬虫程序发出的请求UA伪装成主流浏览器(如Chrome或Firefox)的标识字符串。
通过创建自定义请求对象,实现爬虫程序请求身份的伪装。
User-Agent参数(UA)用于表明本次请求载体的身份。若通过浏览器发起请求,载体即为当前浏览器,UA值对应浏览器的身份标识字符串。
若通过爬虫程序发起请求,载体为爬虫程序,此时UA值为爬虫程序自身的身份标识字符串。
部分网站通过识别请求的UA来判断载体是否为爬虫。若确认为爬虫,则不返回响应,导致爬虫无法获取数据。这是初级反爬技术。为避免此问题,需对爬虫UA进行伪装,使其模拟某款浏览器的身份标识。
前文案例使用request模块中的urlopen发起请求,该对象为urllib内置默认请求对象,无法直接修改其UA。urllib提供了自定义请求对象的方式,可通过该方式对请求对象中的UA进行伪装(修改)操作。
通过构建包含谷歌浏览器UA标识的自定义请求头字典,并创建自定义请求对象,可实现对谷歌UA的伪装。
步骤1:封装包含自定义请求头信息的字典。
注意:在headers字典中可以封装任意类型的请求头信息。
步骤3:获取浏览器的UA数据,并将其封装到字典中。该UA值可通过抓包工具或浏览器开发者工具中查看特定请求来获取。
import urllib.request
import urllib.parse
url = 'https://www.sogou.com/web?query='
# url的特性:url不可以存在非ASCII编码字符数据
word = urllib.parse.quote("周杰伦")
# 将编码后的数据值拼接回url中
url = url+word # 有效url
# 发请求之前对请求的UA进行伪造,伪造完再对请求url发起请求
# UA伪造
# 1 子制定一个请求对象,headers是请求头信息,字典形式
# 封装自定义的请求头信息的字典,
# 注意:在headers字典中可以封装任意的请求头信息
headers = {
  # 存储任意的请求头信息
  'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_0) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36'
}
# 该请求对象的UA进行了成功的伪装
request = urllib.request.Request(url=url, headers=headers)
# 2.针对自定义请求对象发起请求
response = urllib.request.urlopen(request)
# 3.获取响应对象中的页面数据:read函数可以获取响应对象中存储的页面数据(byte类型的数据值)
page_text = response.read()
# 4.持久化存储:将爬取的页面数据写入文件进行保存
with open("周杰伦.html","wb") as f:
  f.write(page_text)
print("写入数据成功")
完成上述配置后,即可有效突破网站的初级反爬机制。
以上为本文全部内容,希望对学习有所帮助,欢迎支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









