

Python Selenium ChromeOptions 参数详解与实战配置
本文详细介绍Python Selenium中ChromeOptions类的核心配置方法。涵盖禁止图片加载、添加代理IP、修改User-Agent、设置编码及禁用JavaScript等常用技巧,并提供关闭密码提示框、添加扩展插件等高级配置代码示例,帮助开发者提升爬虫稳定性与执行效率。
2026-10-13
6

本文详细介绍Python Selenium中ChromeOptions类的核心配置方法。涵盖禁止图片加载、添加代理IP、修改User-Agent、设置编码及禁用JavaScript等常用技巧,并提供关闭密码提示框、添加扩展插件等高级配置代码示例,帮助开发者提升爬虫稳定性与执行效率。
本文介绍Selenium处理网页内容需滚动加载的两种方法:调整浏览器窗口高度延时加载,以及模拟下拉滚动操作。针对懒加载特性,强调page_source仅包含已加载内容,需通过模拟滚动触发加载。提示网速慢时需增加等待时间,确保获取完整HTML后再执行翻页或元素定位操作。
本文介绍使用 Python 的 Selenium 库抓取页面点击后弹出的窗口信息。通过 Firefox 浏览器配合 GeckoDriver,利用 XPath 定位元素并切换窗口句柄获取数据。针对自动化测试中点击按钮弹窗不显示的问题,提供使用模拟键盘 Enter 键替代 click() 的解决方案,并附带完整代码示例。
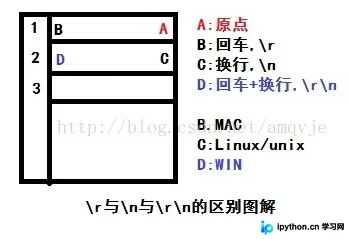
本文详细解析了Python中\r、\n及\r\n的历史渊源与系统差异,涵盖Unix、MAC和Windows的不同标准。同时介绍了如何处理爬虫获取的Unicode编码文件,通过指定encoding='unicode_escape'等参数正确读取和解码内容,确保数据准确输出。
本文详解Python中urllib模块的自定义Opener构建原理。通过HTTPHandler、ProxyHandler及HTTPCookieProcessor处理器,实现代理IP切换与Cookie持久化。涵盖Debug调试、免费与私密代理选择策略,以及基于CookieJar的模拟登录流程,帮助开发者突破基础urlopen的功能限制。
本文详解如何利用Python爬取爱奇艺非VIP视频。通过构造搜索URL并分析分页规律,使用requests获取页面源码,结合BS4库解析HTML标签提取视频链接、标题及描述信息。针对作者信息位置不固定的问题,采用try-except机制进行容错处理,确保数据抓取的完整性与稳定性。
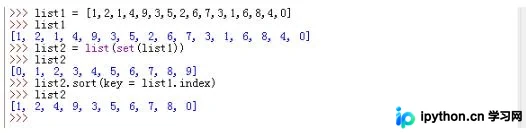
本文介绍如何在Python中对列表进行去重操作,同时保持元素原有的出现顺序。通过结合set集合去重与list.sort方法利用index排序,可解决set默认按值排序的问题。此外,文章还补充了Python爬虫中利用集合实现链接去重的完整代码示例,帮助开发者高效处理数据。
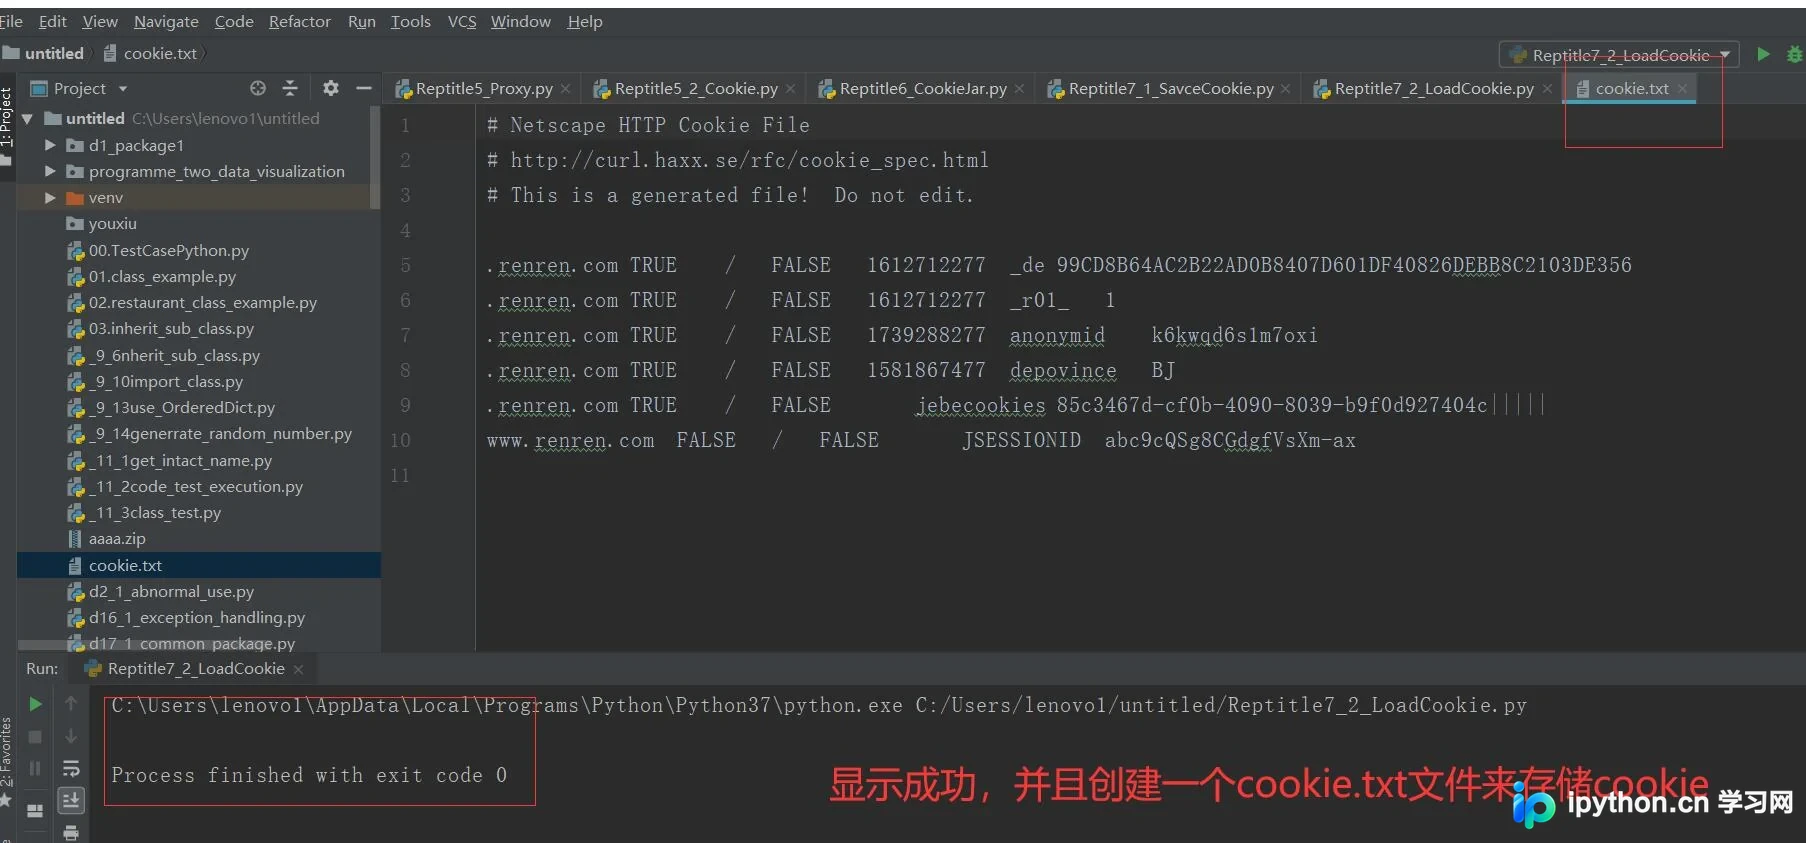
本文详解Python爬虫中Cookie的持久化保存与读取方法,利用FileCookieJar类实现登录状态的文件存储。同时介绍如何处理HTTPS请求中的SSL证书验证问题,通过替换默认上下文环境来忽略不信任的SSL证书,确保爬虫程序在复杂网络环境下的稳定运行。
本文详细介绍在Scrapy框架中实现网站登录的三种常见方式。第一种通过预置Cookies直接访问;第二种手动解析网页获取隐藏字段后发送POST请求;第三种利用FormRequest.from_response自动处理表单提交。文章提供完整代码示例,帮助开发者掌握不同场景下的登录策略。
本文介绍如何使用Python结合Redis数据库构建IP代理池。通过apscheduler库实现定时爬取IP,并采用两层检测机制确保代理有效性:先将IP存入Redis db0进行初步验证,成功者转入db1进行二次检测。代码包含IP的增删改查及定时调度逻辑,为网络爬虫提供稳定的代理支持。
本文详细讲解在Python3 Scrapy框架中配置IP代理的方法。针对阿里云IP代理参数变更及公共IP池不可用的问题,提出结合阿里云API生成有效IP池并在middlewares.py中通过process_request动态设置request.meta['Proxy-Authorization']的解决方案,确保爬虫稳定运行。
本文详解Selenium中get_cookies()与add_cookie()函数的使用方法。通过获取当前浏览器Cookie并保存为JSON文件,后续爬虫任务可直接读取该文件并利用add_cookie()注入Cookie,从而绕过登录验证。该方法特别适用于验证码识别困难或需要高频定时爬取且不想频繁登录的场景,有效提升爬虫稳定性和效率。