如何用 SQL LEAD 获取下一行数据
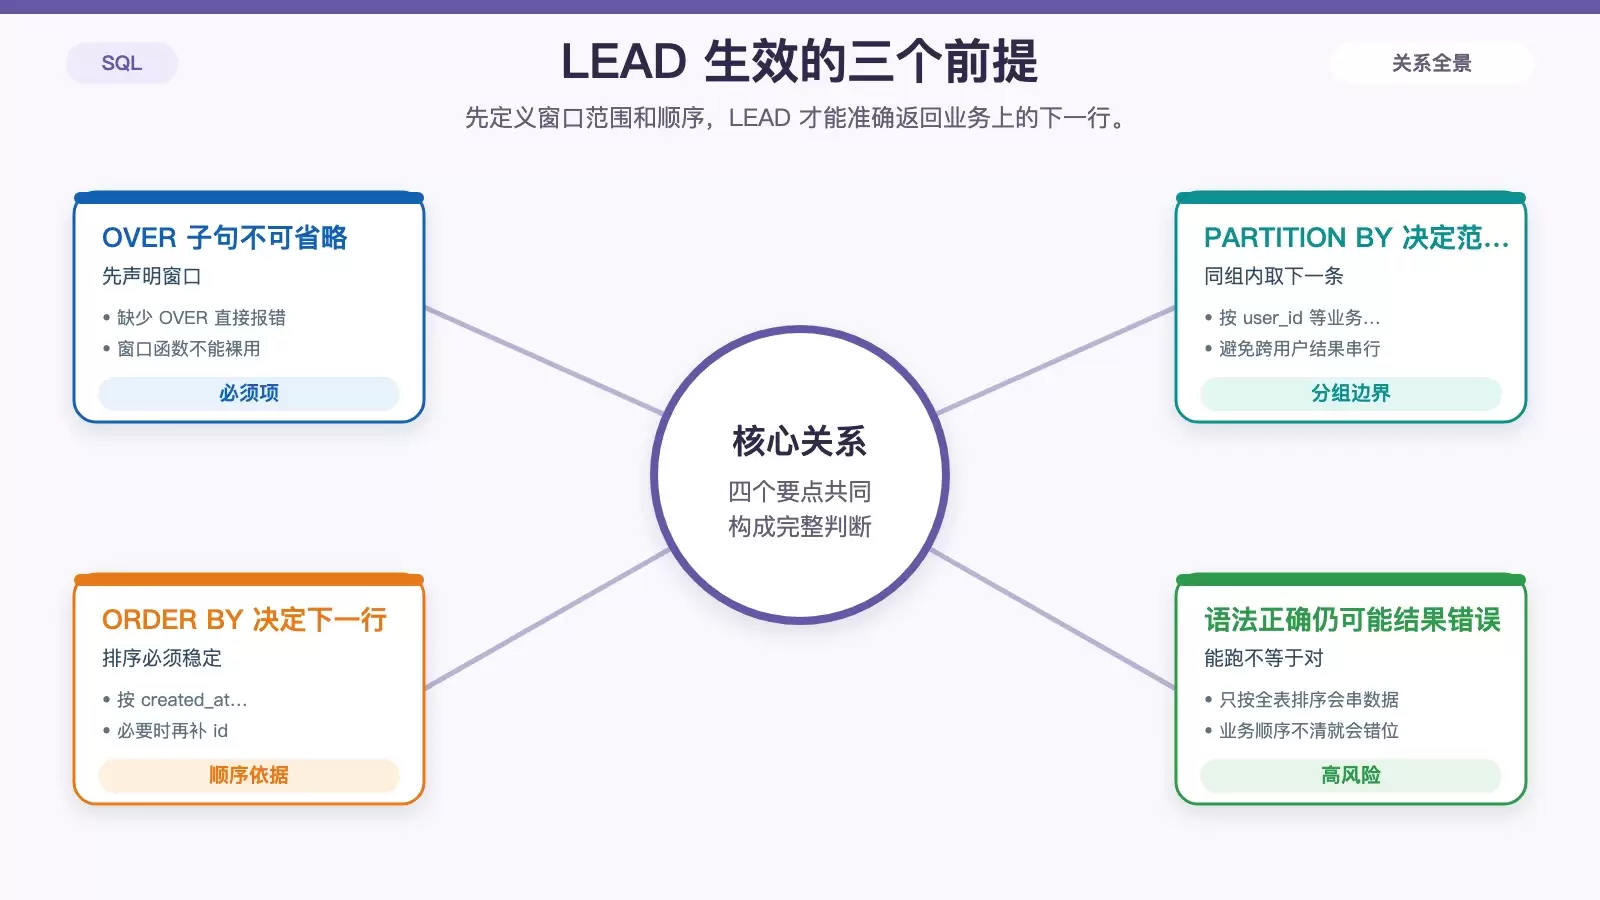
LEAD 能取“下一行”数据,但前提不是写出函数名,而是先把窗口顺序定义清楚。本文围绕常见报错、结果大量为 NULL、以及 offset 与 default 的设置陷阱,梳理 LEAD 在 SQL 中最容易出错的几个关键点。 很多人把 LEAD 当成“自动取下一行”的快捷函数,真正落地时却常常遇到报错、结果错位,或者莫名出现大量 NULL 。
2026-08-25
87

LEAD 能取“下一行”数据,但前提不是写出函数名,而是先把窗口顺序定义清楚。本文围绕常见报错、结果大量为 NULL、以及 offset 与 default 的设置陷阱,梳理 LEAD 在 SQL 中最容易出错的几个关键点。 很多人把 LEAD 当成“自动取下一行”的快捷函数,真正落地时却常常遇到报错、结果错位,或者莫名出现大量 NULL 。
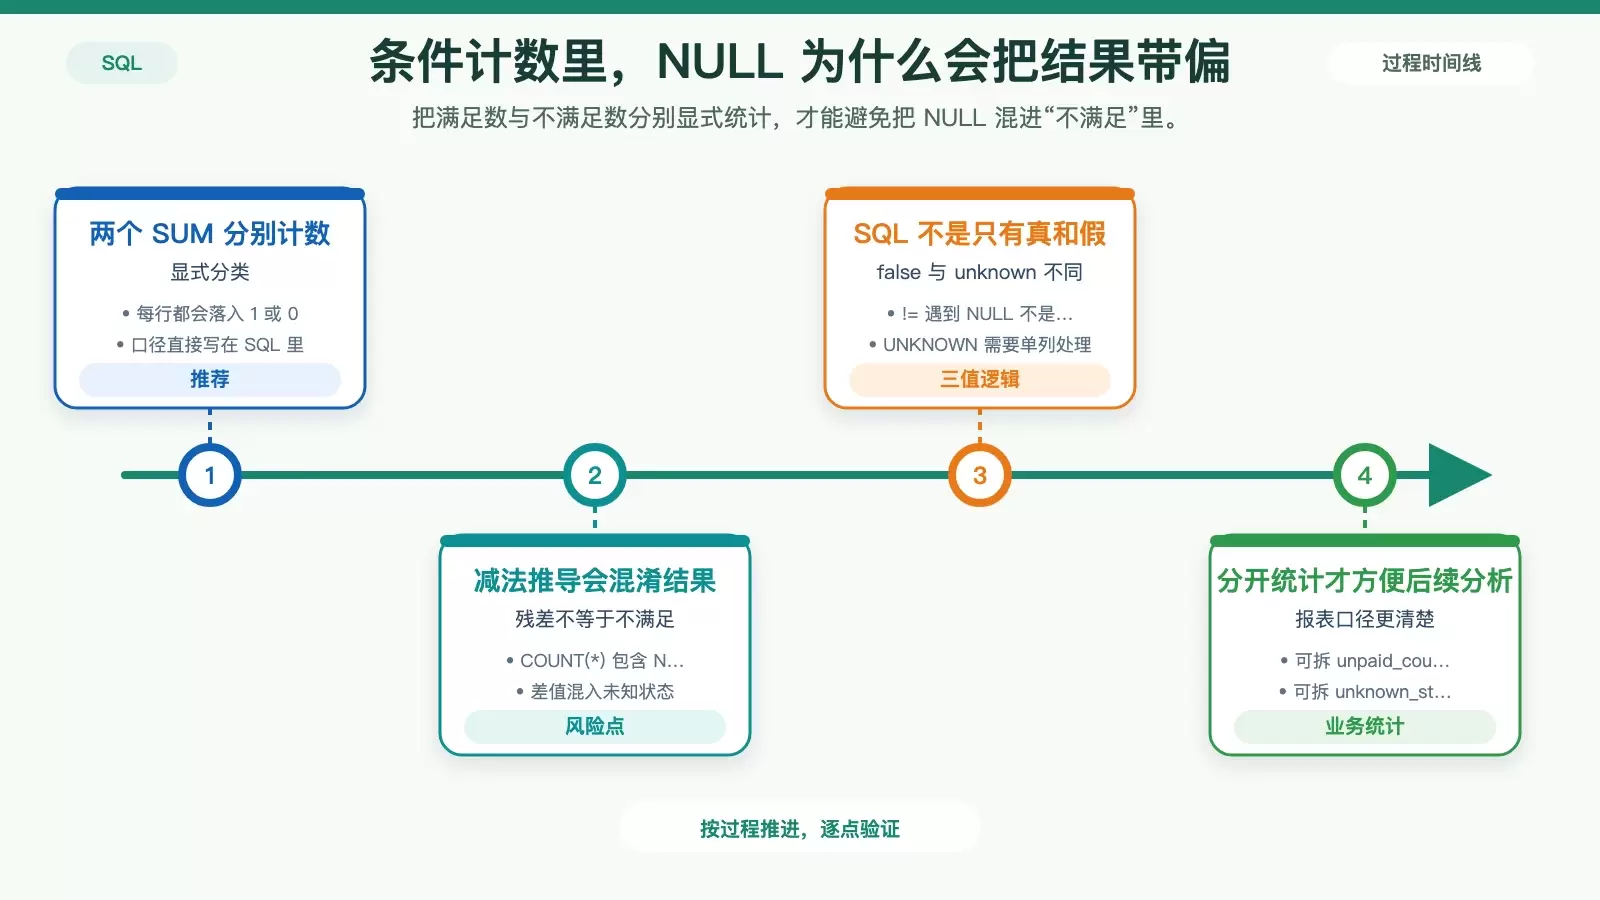
在 SQL 里同时统计“满足条件”和“不满足条件”的数量,看起来简单,但一旦遇到 NULL、分组和跨数据库差异,结果很容易偏。本文用可直接落地的写法说明为什么应优先使用两个 `SUM(CASE WHEN ...)`,并补齐分组比例、兼容性和 NULL 检查这几个关键点。
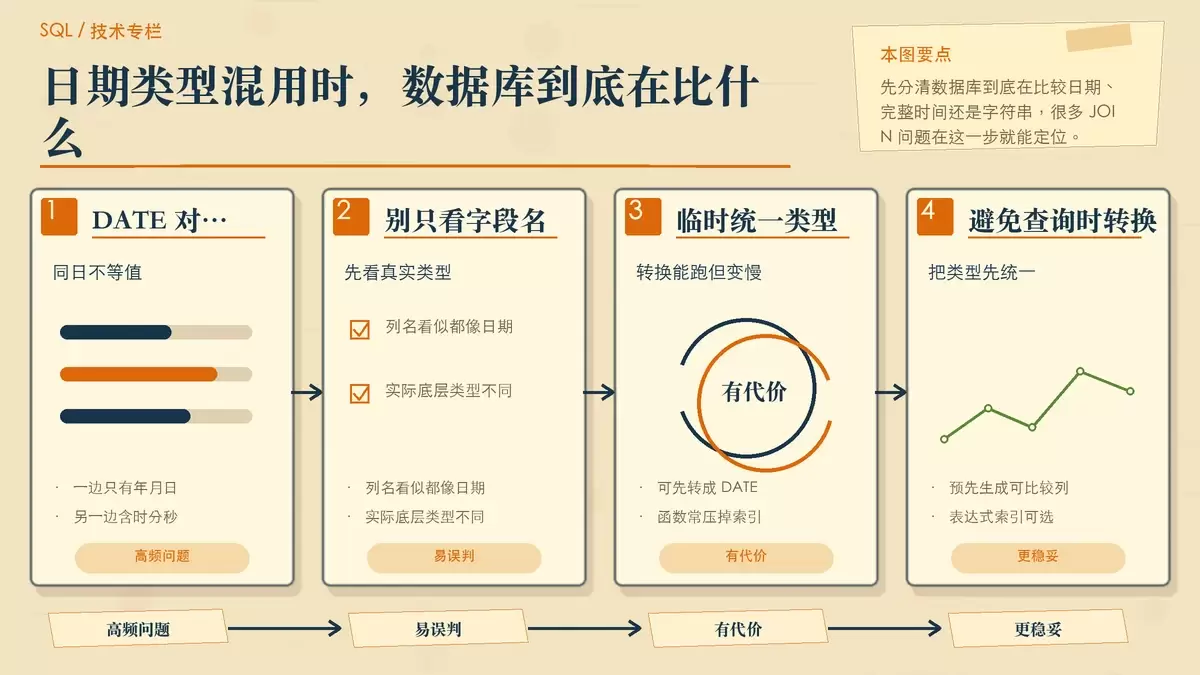
SQL 里日期字段 JOIN 匹配不到,通常不是“连不上”,而是比较条件本身有偏差。常见问题集中在类型不一致、时间精度不同、LEFT JOIN 条件位置错误,以及 NULL 和时区干扰;把排查顺序理清后,定位会快很多。
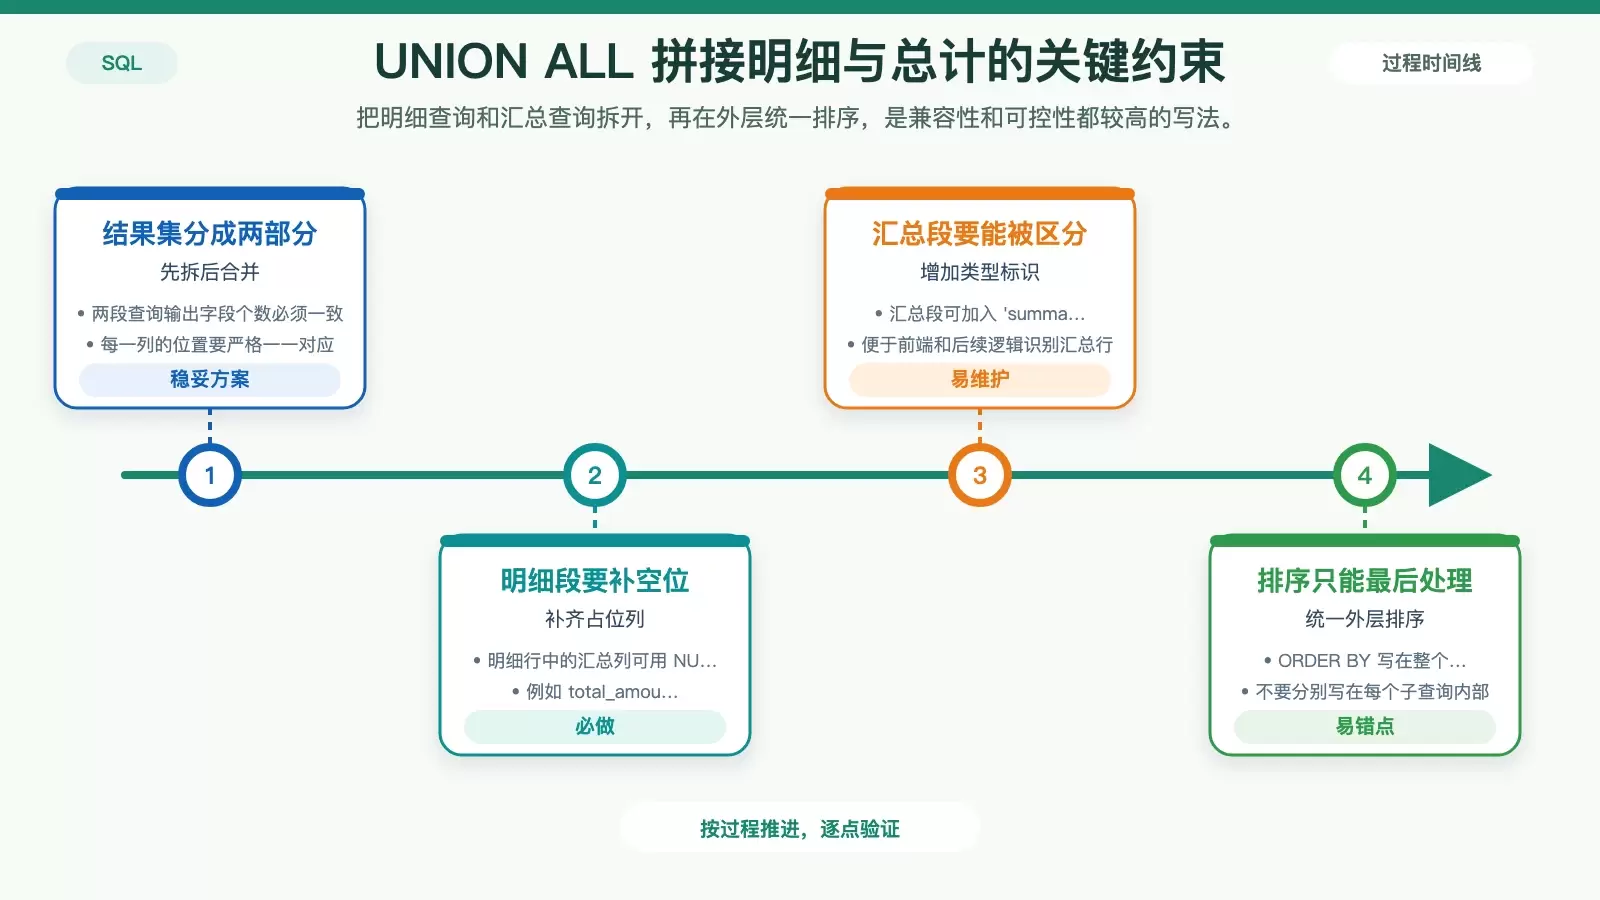
在 SQL 里想把明细行和汇总结果一起返回,不能直接把 `SELECT *` 和聚合函数硬拼到同一个查询里。更稳妥的做法通常是 `UNION ALL`,支持窗口函数时可进一步减少扫描;如果需求本身就是分组小计与总计,则应考虑 `ROLLUP`。
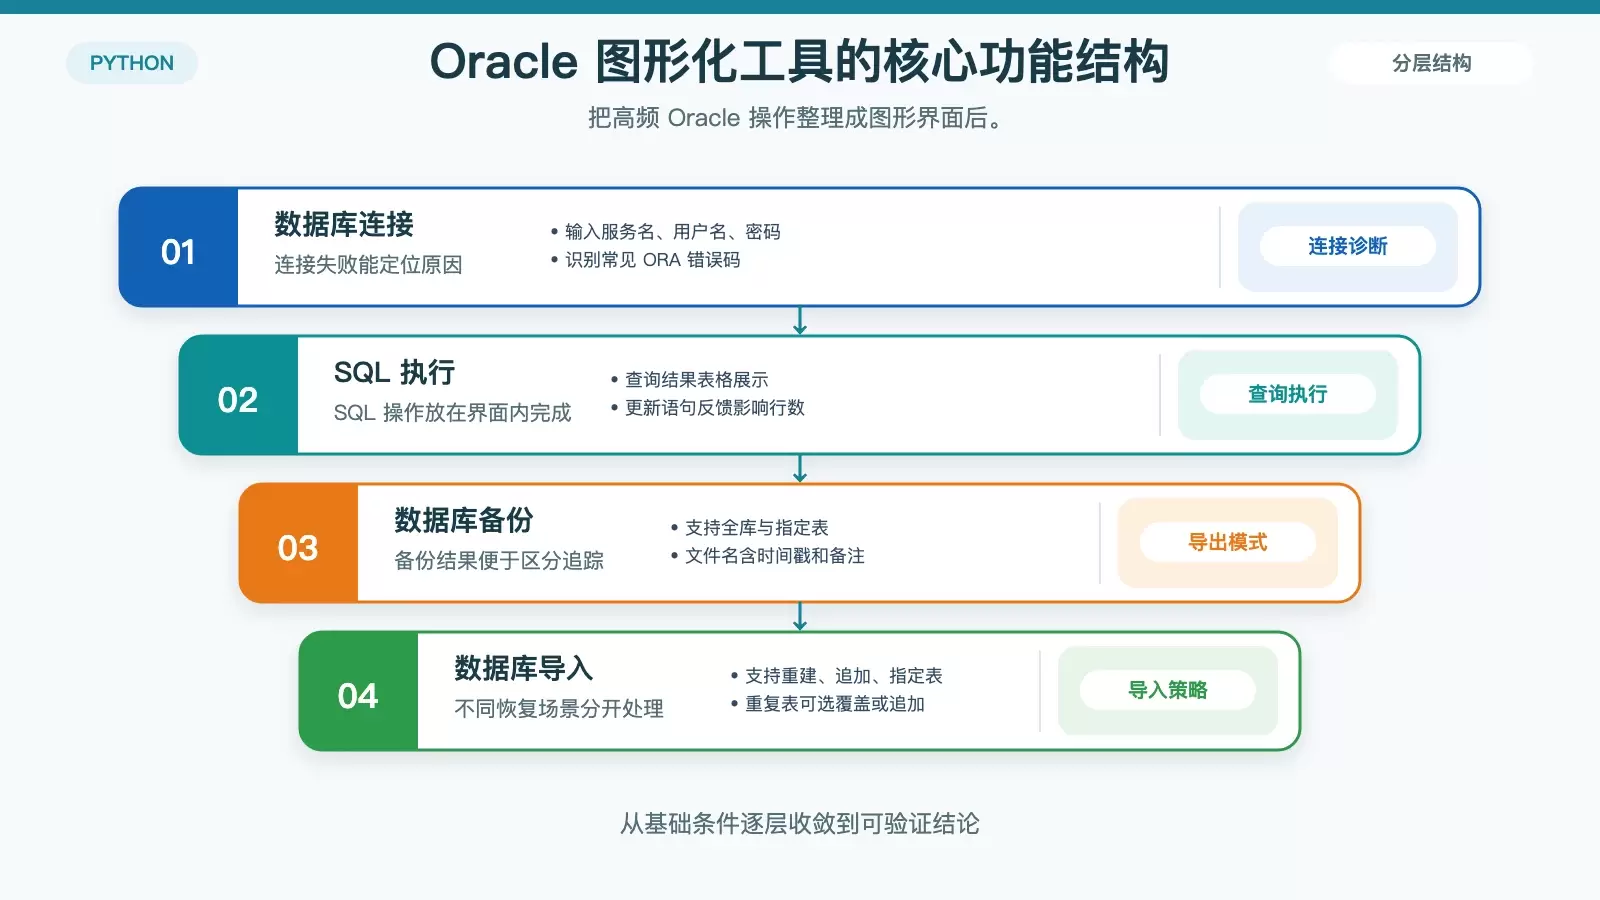
这款用 Python + Tkinter 编写的 Oracle 图形化工具,核心目标是把常见的备份、导入、SQL 执行和用户管理操作,从难记的命令行改成可视化流程。文章按实际使用场景梳理实现思路、关键代码和部署方式,便于判断它是否适合团队日常运维。
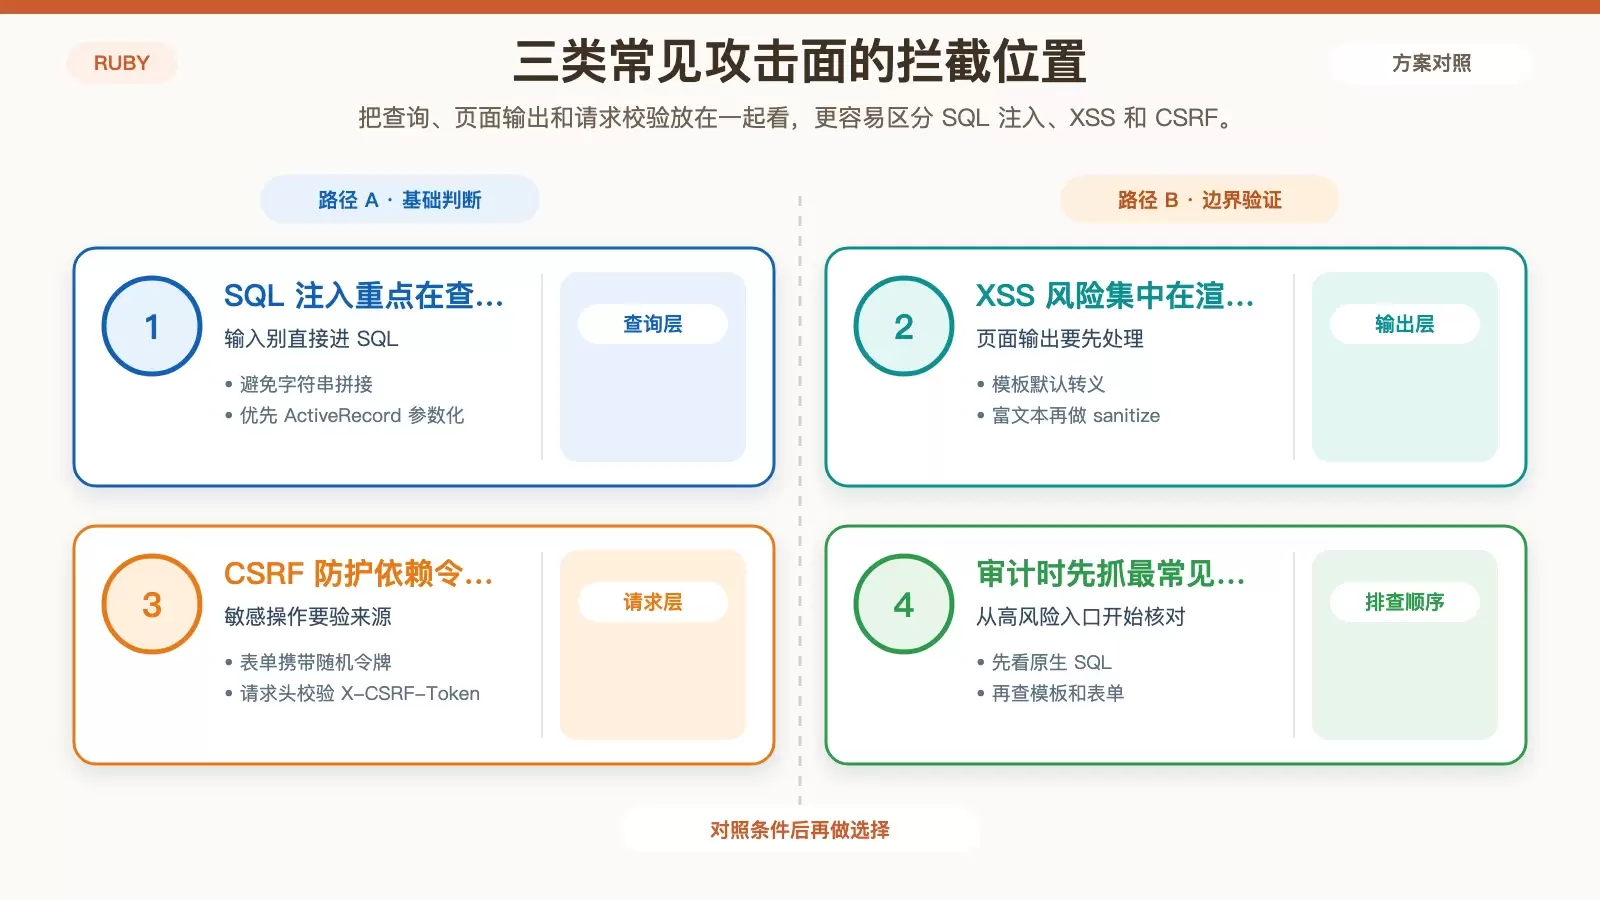
这篇文章围绕 Ruby 开发中最常见的几类安全风险展开,覆盖 SQL 注入、XSS、CSRF、输入校验、密码存储与日志审计等重点场景。文章保留原有 Ruby/Rails 示例,并补充每类问题的判断思路,便于在项目里快速核对安全基线。
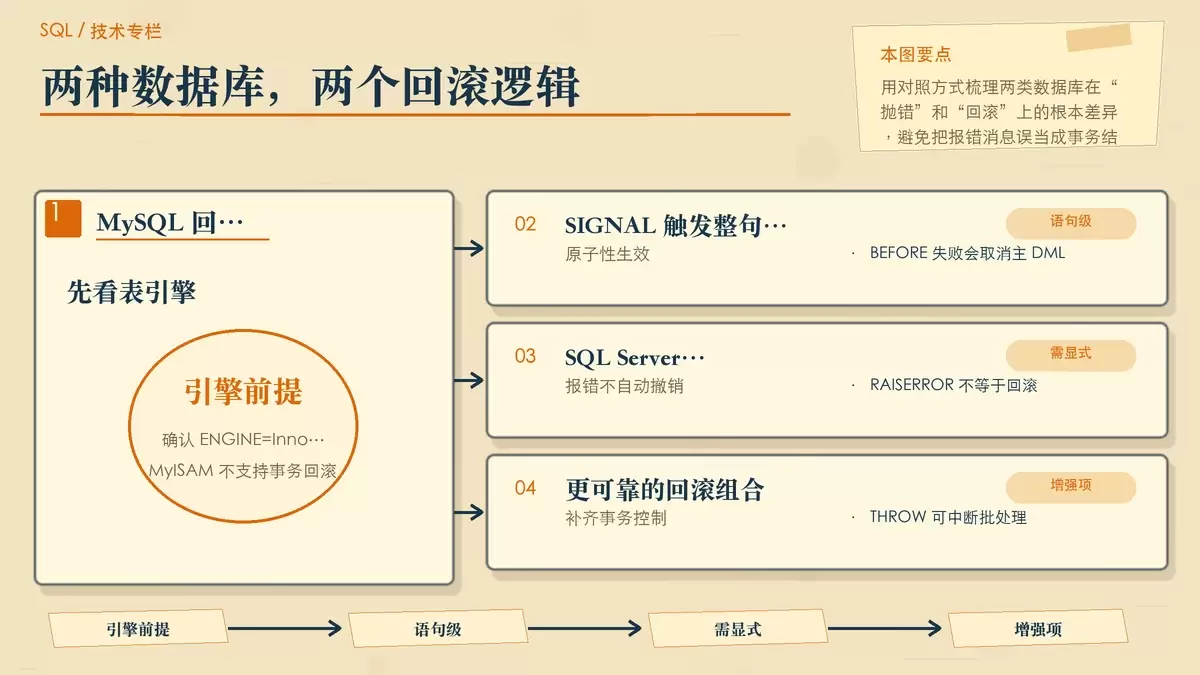
触发器里一旦抛错,为什么有的库会自动回滚,有的却只是报错后继续保留数据?关键不在“触发器会不会回滚”,而在数据库引擎、事务设置和异常传播链路。本文用 MySQL 与 SQL Server 对照拆开讲清常见误判与排查方法。
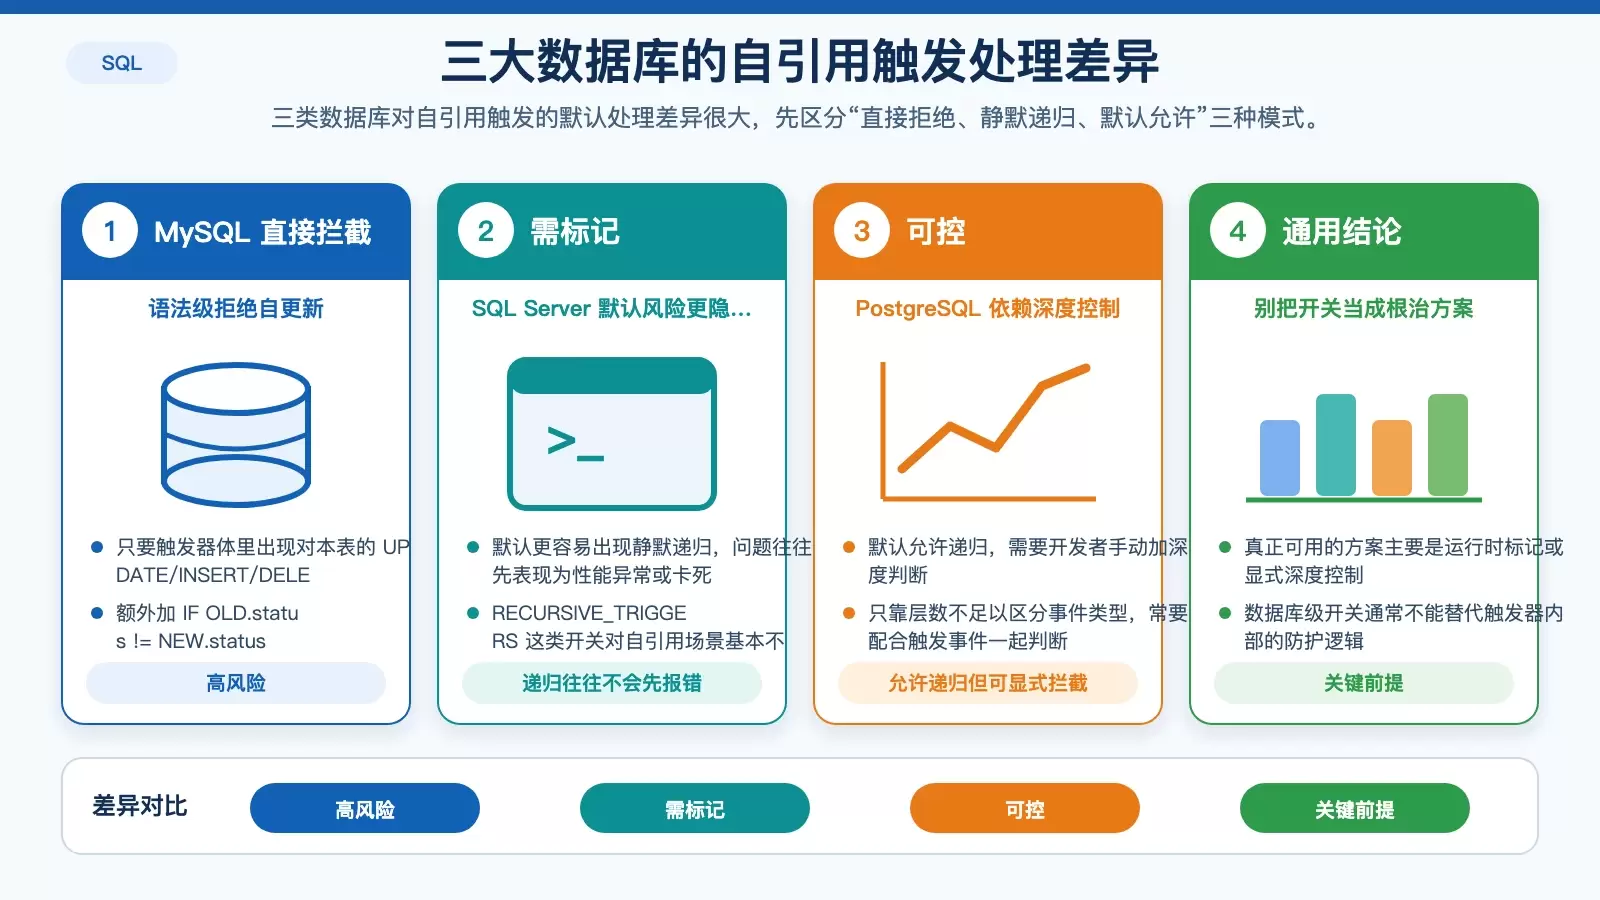
SQL 触发器一旦回写自身监听的表,三大数据库的表现并不一样:MySQL 直接报 `ERROR 1442`,SQL Server 可能静默递归,PostgreSQL 则默认允许但需要手动拦截。本文按数据库拆解限制、可行写法和容易踩坑的上下文污染问题。
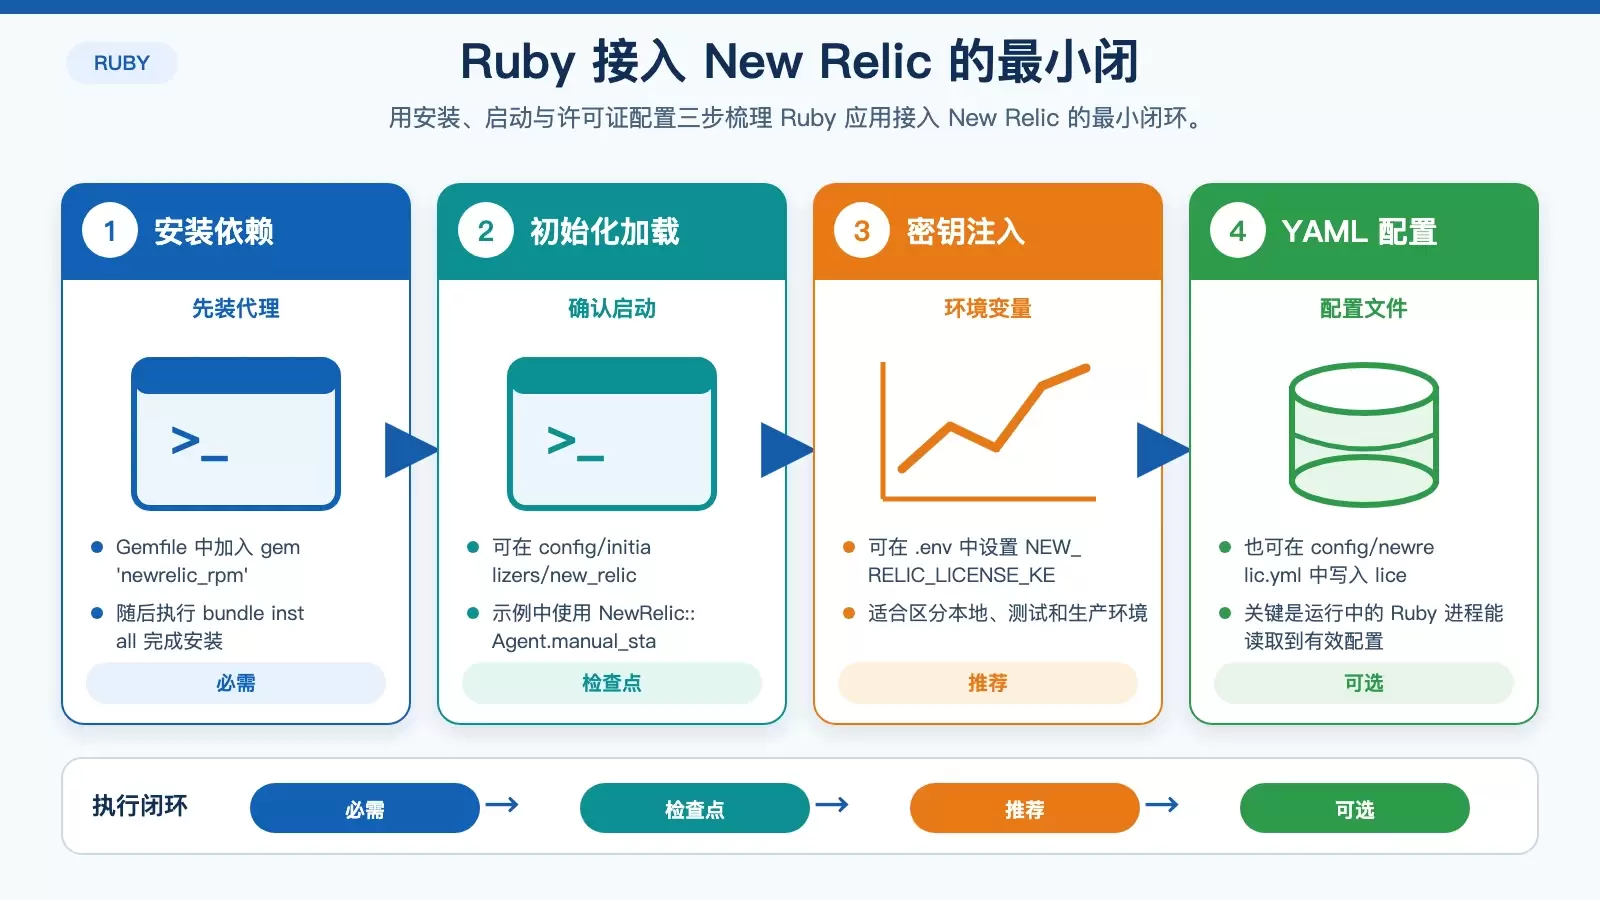
这篇文章围绕 Ruby 应用接入 New Relic 的实际流程展开,涵盖安装、许可证配置、核心监控视图以及慢查询优化思路。重点不是罗列功能,而是帮助你判断哪些指标值得先看、哪些问题适合用 New Relic 直接定位。
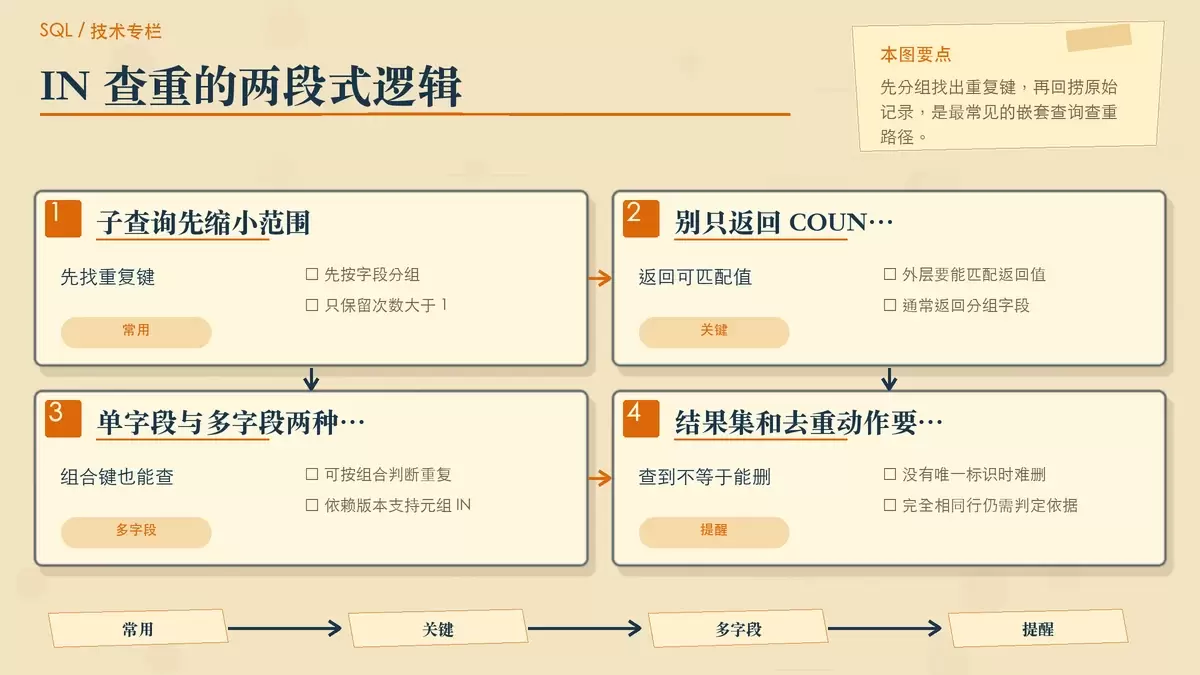
在 SQL 里查找重复数据,最常见的做法是先用子查询找出重复键,再由外层查询回捞原始行。但 `IN`、`EXISTS`、多字段匹配和 MySQL 删除限制各有坑,尤其会受 `NULL`、版本能力和同表删除规则影响。 查重复数据,真正麻烦的通常不是写出一条 GROUP BY ,而是继续把原始记录捞出来,并判断后续能否安全删除。
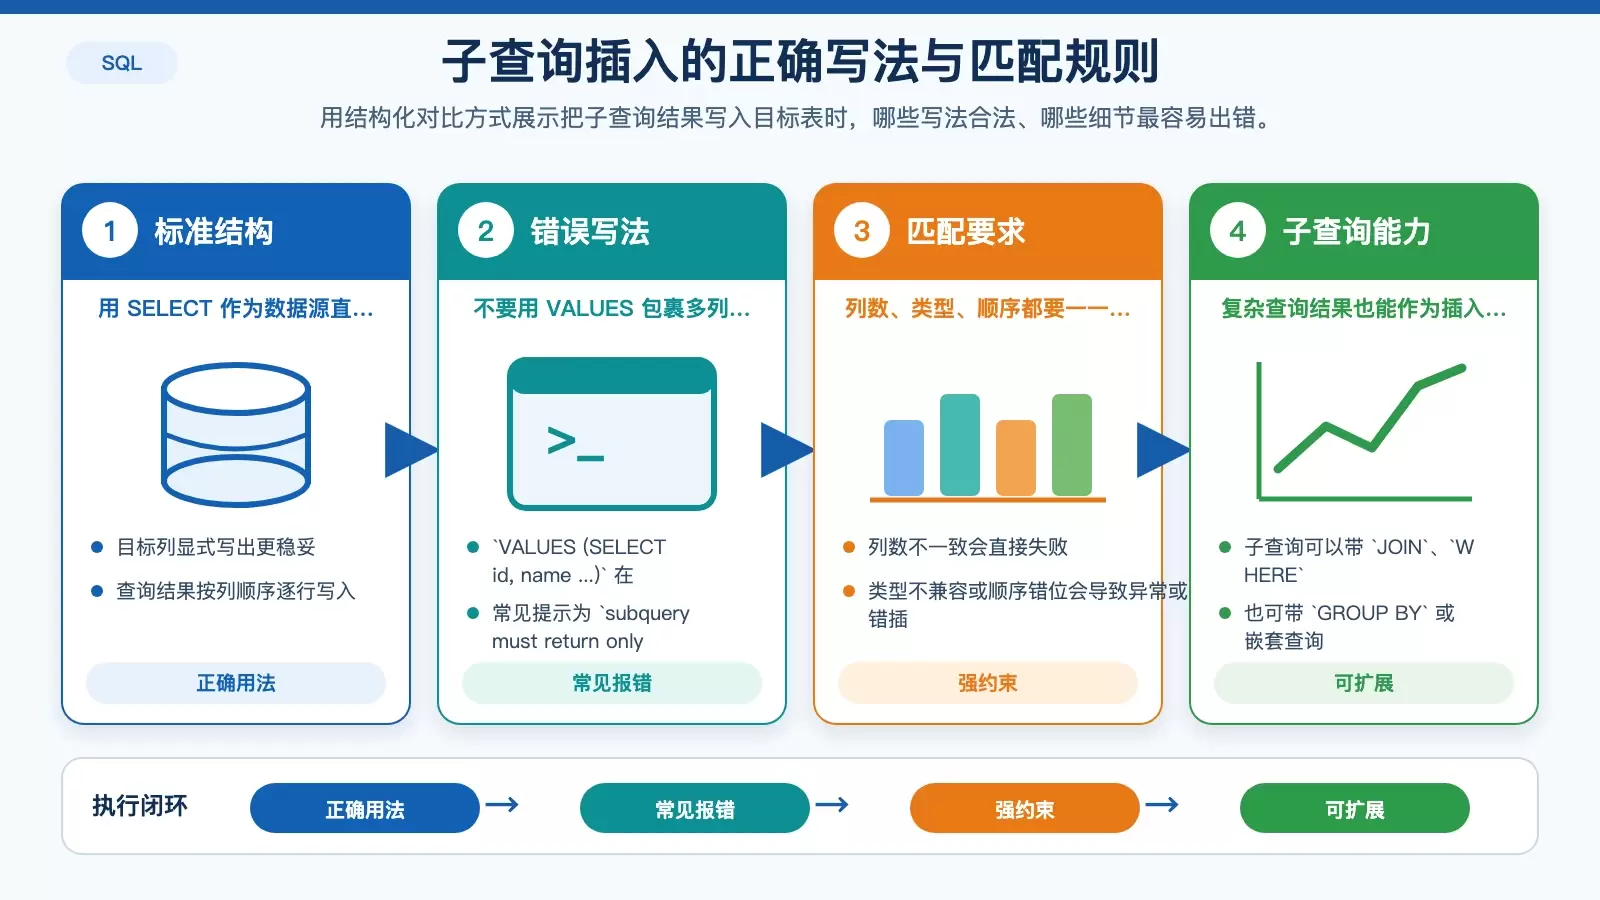
把子查询结果写入目标表,最稳妥的做法是 `INSERT INTO ... SELECT`。这类语句语法不复杂,但列顺序、类型匹配、方言差异、锁行为和空结果处理都很容易踩坑,文章将按写法、兼容性、性能与排错四部分梳理清楚。
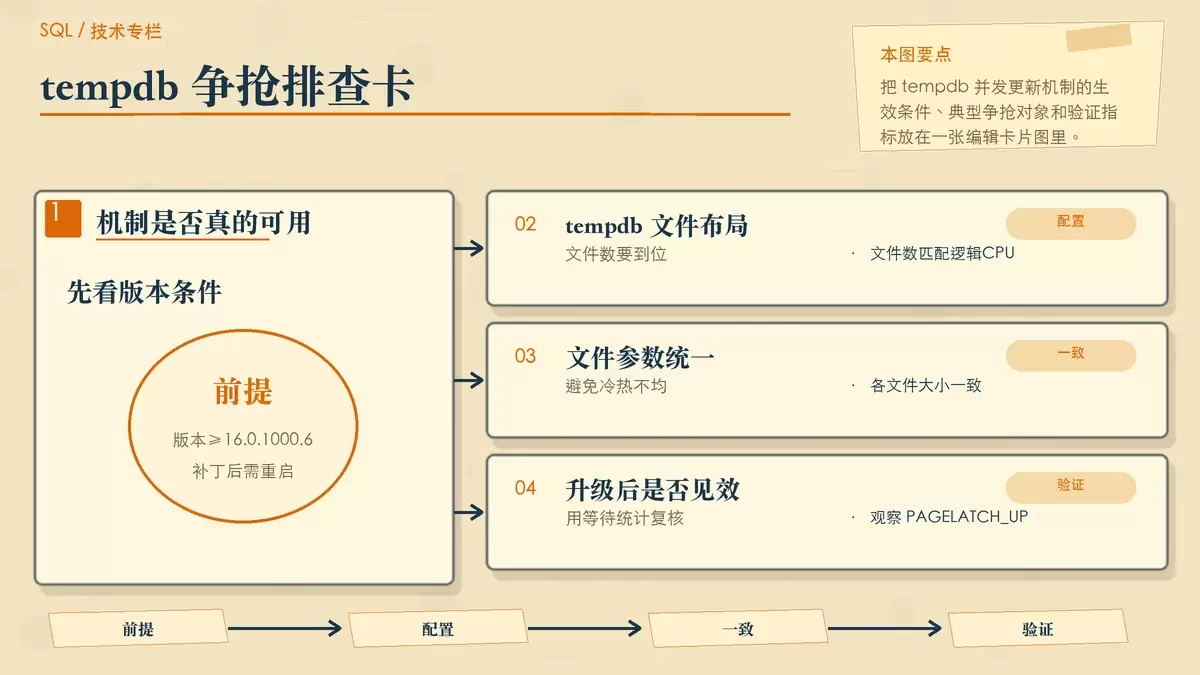
SQL Server 2022/2024 中,存储过程执行计划优化的重点不在改写语法,而在于让既有过程正确触发新机制。排查时应先看统计信息,再分别确认 tempdb 并发更新、参数敏感计划(PSP)、RECOMPILE 使用边界,以及查询存储中的优化重播是否真正带来编译收益。