


很多人第一次遇到“同一条 SQL 既要返回订单明细,又要带上合计或分组小计”时,直觉上会把普通查询和聚合查询写到一个 SELECT 里,但这往往要么直接报错,要么结果不可靠。本文把几种常见写法拆开讲清楚:什么时候该用 UNION ALL 拼接明细与汇总,什么时候改用窗口函数减少重复扫描,以及在需要层级小计时为什么 ROLLUP 更贴近需求。
读完后,你可以按数据库版本、结果形态和性能要求做判断:只要“明细 + 总计”就优先看窗口函数;需要兼容性和可控输出时用 UNION ALL;明确要“每组小计 + 全局总计”时再上 ROLLUP,同时避开子查询和 CTE 里那些表面简洁、实际容易踩坑的写法。
为什么不能在一个 SELECT 里直接混写明细和聚合
SQL 标准并不支持在同一个 SELECT 中,既原样返回记录明细,又随手取出 SUM()、COUNT() 这类聚合结果。最常见的误写是:
SELECT *, SUM(amount) FROM orders GROUP BY id这类写法的问题很直接:
- 在 MySQL 5.7+ 严格模式下,通常会直接报错。
- 即使某些数据库或宽松模式能执行,非聚合字段的值也可能不可靠。
- 从语义上说,明细行和汇总行本来就是两类不同结果,硬塞进同一层查询很难兼顾正确性与可维护性。
所以,第一步不是“想办法让它跑起来”,而是先确认结果需求属于哪一类:你要的是把两类结果拼成一个结果集,还是要在每一行旁边附带汇总值。
用 GROUP BY + UNION ALL 拼接明细和汇总行
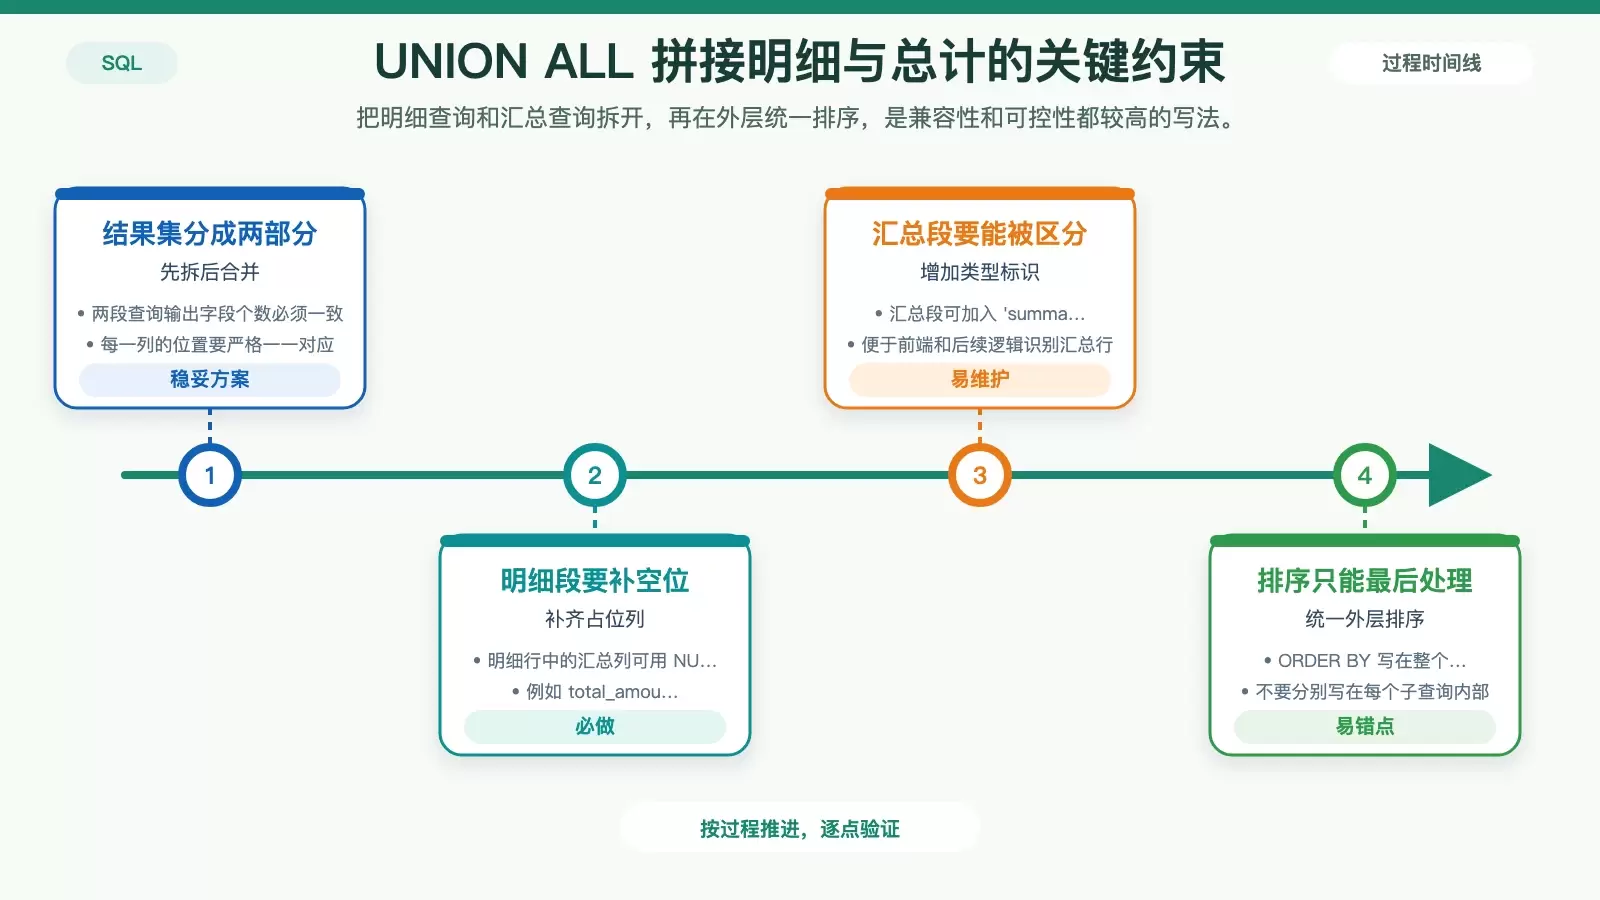
如果你的目标是“返回多行明细,最后再附一行总计”,GROUP BY + UNION ALL 仍然是最稳妥、最容易跨数据库理解的方案。它的核心思路是:把明细查询和汇总查询拆成两段,再用 UNION ALL 合并。
这类写法要满足的三个条件
- 列数一致:两段查询输出的列必须一一对应。
- 类型一致:同一列位置上的数据类型要兼容,必要时用
NULL或0占位。 - 顺序一致:列顺序不能错,排序也要放到最外层统一处理。
通常还会加一个标识字段,方便前端或后续逻辑区分这是明细行还是汇总行。
SELECT id, amount, 'detail' AS type, NULL AS total_amount
FROM orders
WHERE status = 'paid'
UNION ALL
SELECT NULL AS id, NULL AS amount, 'summary' AS type, SUM(amount) AS total_amount
FROM orders
WHERE status = 'paid'
ORDER BY type, id;
实际使用时要特别注意什么
- 明细部分要给汇总列补占位值,比如
NULL AS total_amount。 - 汇总部分要给明细列补空值,并显式加上如
'summary'这样的类型标记。 ORDER BY必须写在整个UNION ALL的最后,不能分别写在每个子查询里。
这种方式的优点是兼容性强、结果结构清晰,缺点是通常会对同一批数据做两次逻辑扫描。如果基础表很大,或者 WHERE 条件很复杂,就该考虑窗口函数。
支持窗口函数时,用 SUM() OVER() 减少重复扫描
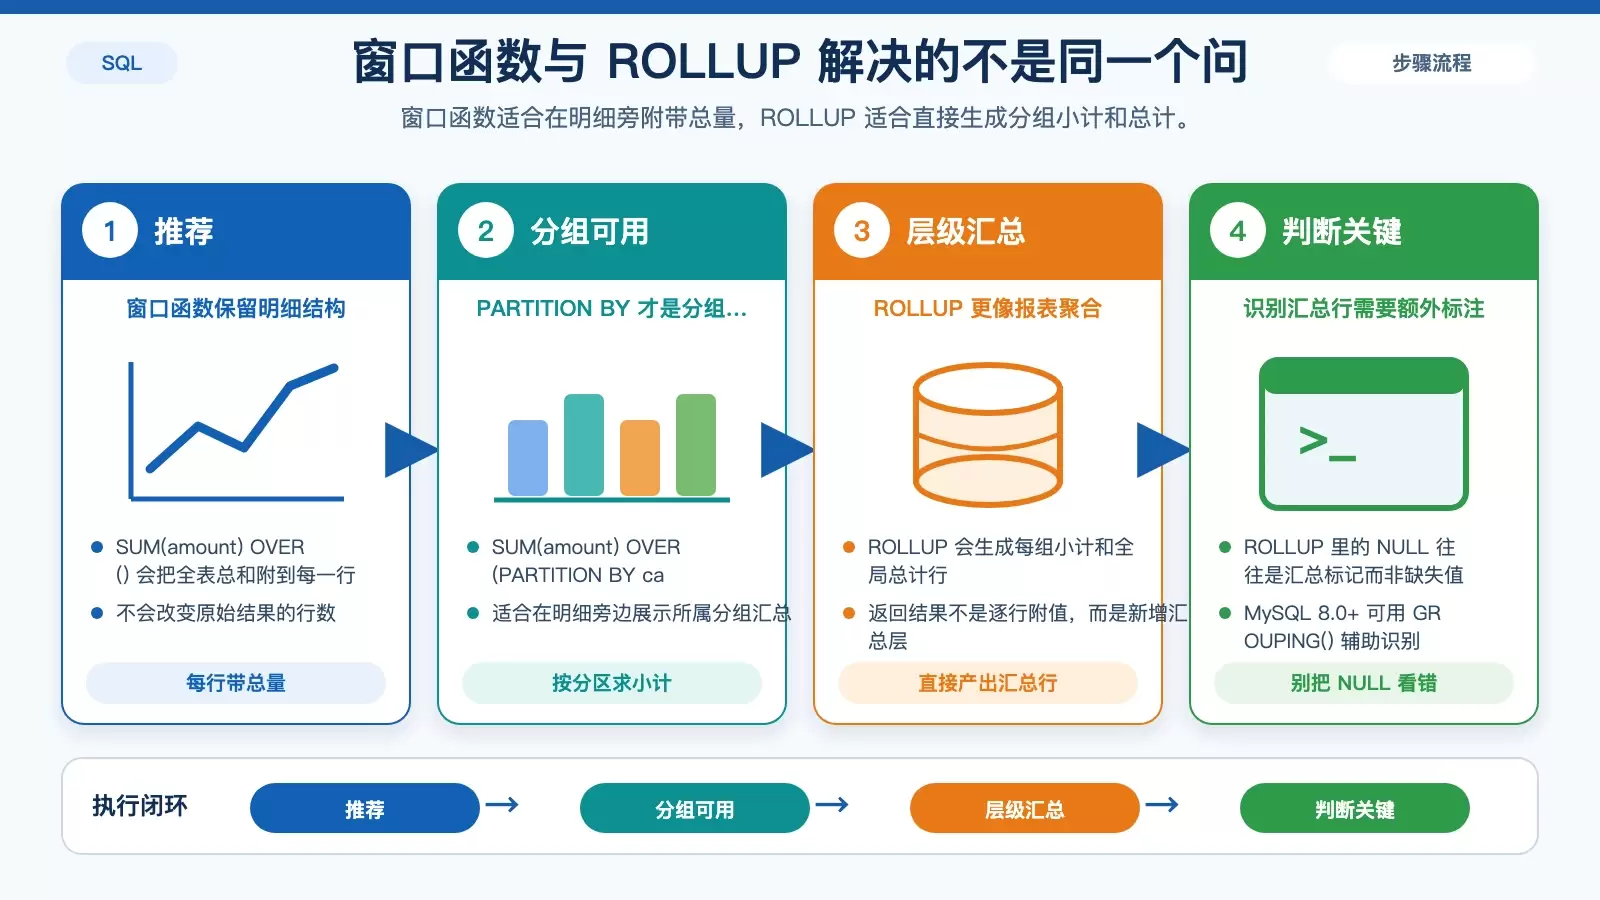
如果数据库支持窗口函数,那么“明细里顺带带出汇总值”通常可以写得更短,也更高效。文中提到的支持范围包括 PostgreSQL 8.4+、SQL Server 2005+、MySQL 8.0+、Oracle 9i+。这类写法的关键在于:窗口函数不会改变结果行数,而是在每一行上附加统计值。
SELECT
id,
amount,
category,
SUM(amount) OVER() AS total_all,
SUM(amount) OVER(PARTITION BY category) AS total_by_cat
FROM orders
WHERE status = 'paid';
它适合解决哪类问题
SUM(amount) OVER()适合给每一行附带全表总和。SUM(amount) OVER(PARTITION BY category)适合给每一行附带所属类目的小计。- 当基础表很大、过滤条件复杂时,它通常比
UNION ALL更省一次扫描。
窗口函数的边界也要看清
- 它不能替代
GROUP BY去生成真正的“汇总行”。 - 如果你要的是“每组小计一行 + 总计一行”,窗口函数本身并不直接产出这种结果。
- 明细行里混入窗口汇总列后,不能再拿这些字段继续做不合适的
GROUP BY,否则容易触发语法错误。 - 某些旧版 SQLite 或 MariaDB 不支持窗口函数,执行前最好先查一次:
SELECT version();所以,窗口函数更适合“明细保留不变,但每行都想看到总量或分组总量”的场景,而不是“我要额外多出几行汇总记录”的场景。
需要分组小计和总计时,用 ROLLUP 更贴近语义
如果需求已经明确成“按类目分组统计,同时给出每组小计和全局总计”,那就不要再勉强用明细拼接思路了。GROUP BY ... WITH ROLLUP 天然就是为这种层级聚合准备的。
SELECT
IF(GROUPING(category), 'All Categories', category) AS category,
COUNT(*) AS cnt,
SUM(amount) AS sum_amt
FROM orders
WHERE status = 'paid'
GROUP BY category WITH ROLLUP;
ROLLUP 里的 NULL 不是缺失值
ROLLUP 会自动补出更高层级的汇总行,而这些行里出现的 NULL 往往不是“原始数据为空”,而是“这一层已经被汇总掉了”的标记。这一点很关键。
- 可以用
CASE WHEN GROUPING(category) = 1 THEN 'Total'之类的写法显式标注汇总行。 GROUPING()返回1,表示该列在当前行里是被 rollup 掉的。- MySQL 8.0+ 支持
GROUPING(),早期版本如果只能靠IS NULL判断,就有误判真实NULL数据的风险。
ROLLUP 的层级是固定展开的
例如 ROLLUP(a,b,c) 会按固定层级生成:
(a,b,c)(a,b,NULL)(a,NULL,NULL)(NULL,NULL,NULL)
这意味着它非常适合做“明细维度逐层向上汇总”的报表,但不适合拿来伪装成普通明细查询。不同数据库对这些 NULL 的呈现细节可能不完全一样,例如 MySQL 往往在最右列开始填 NULL,PostgreSQL 则可能同时出现多列为 NULL,因此判断逻辑不能只看单个字段。
为什么子查询或 CTE 看起来简单,实际却容易踩坑
不少人会尝试把总计字段直接“挂”到明细行上,例如:
SELECT *, (SELECT SUM(amount) FROM orders) AS total FROM orders这类写法的问题不在于能不能跑,而在于代价和正确性都不稳定:
- 子查询可能在每一行重复执行,数据量一大性能会明显下滑。
- 如果外层用了
WHERE或LIMIT,而子查询没同步过滤,算出来的总数就可能和明细范围不一致。
CTE 也有类似误区。比如:
WITH base AS (SELECT * FROM orders WHERE status = 'paid')
SELECT *, (SELECT SUM(amount) FROM base) FROM base;
这段 SQL 在 PostgreSQL 中可能被优化,但在 MySQL 8.0 中仍可能执行两次扫描。也就是说,WITH 看起来更整洁,不代表一定会自动变成单次计算。
如果你真的要把同一个汇总值回填到所有明细行里,数据库又不适合用窗口函数,那么更稳妥的办法通常是先把汇总结果算到变量、临时表或派生表里,再 JOIN 回主查询。但这时已经不再是“一条 SQL 同时优雅解决所有问题”的范畴了。
实际选型怎么判断
可以按结果需求直接选方案:
- 只想返回“明细 + 一行总计”:优先用
UNION ALL。 - 想在每一行旁边附带全局总量或分组总量,且数据库支持窗口函数:优先用
SUM() OVER()。 - 明确需要“每组小计 + 全局总计”的层级聚合:直接用
ROLLUP。 - 对子查询和 CTE,要重点警惕重复扫描和过滤范围不一致的问题。
一句话概括:别为了把逻辑塞进一个看起来更短的 SELECT,牺牲结果的可读性、可维护性和执行成本。SQL 能不能写成“一条”,从来不是最重要的判断标准。









