


很多团队在升级 SQL Server 后,第一反应是去改存储过程写法,但执行计划问题往往并不出在语法层面。真正影响结果的,通常是 tempdb 并发配置、PSP 是否被人为关闭、RECOMPILE 是否被滥用,以及统计信息是否足够新鲜。下面按排查顺序拆开讲,帮助你判断“该改配置、该改提示,还是该先更新统计信息”。
升级后执行计划还是卡在 tempdb,先看这几个前提
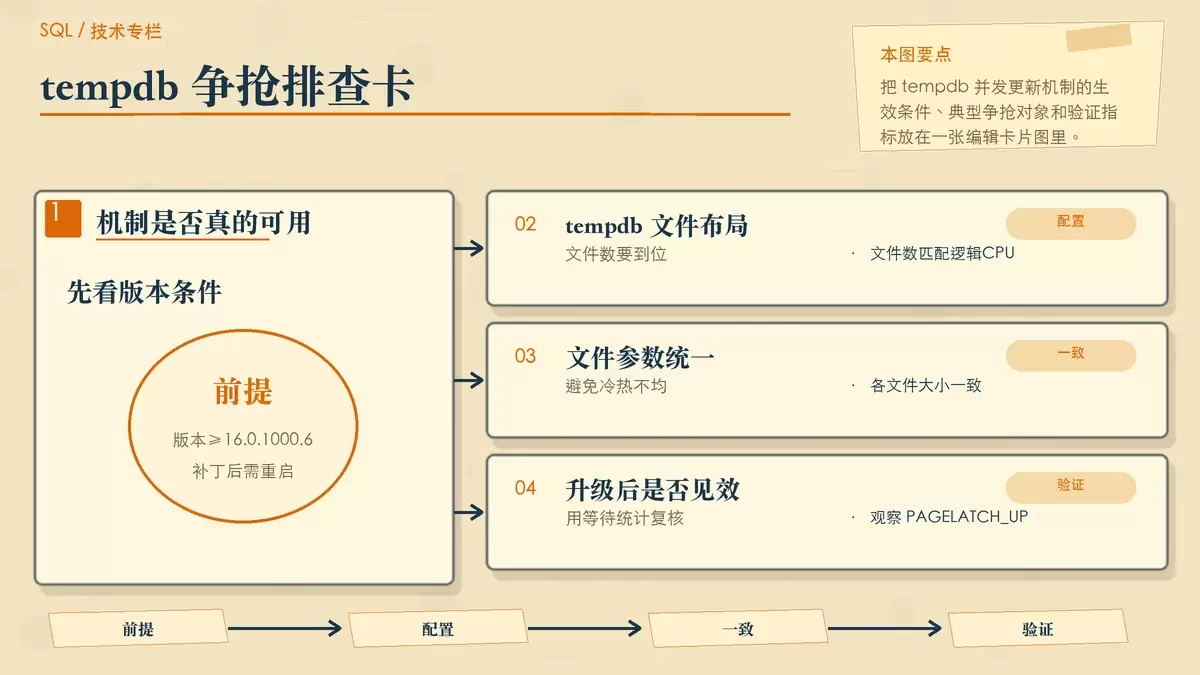
升级到 SQL Server 2024 后,如果存储过程执行时间开始抖动,或者等待类型里的 PAGELATCH_UP 明显升高,问题通常不是“新版本优化器失灵”,而是 tempdb 的并发争抢还没被真正缓解。
这类场景常见于以下对象或机制持续使用 tempdb:
- 本地临时表
#tmp - 表变量
@table - 行版本控制,例如启用了
READ_COMMITTED_SNAPSHOT
它们会持续争抢 tempdb 中的 GAM/SGAM 页,进而把等待堆到 PAGELATCH_UP 上。SQL Server 2024 默认启用了并发 GAM/SGAM 更新机制,但这个机制要真正起作用,前提条件必须同时满足。
机制生效需要满足什么条件
- 实例版本必须达到
16.0.1000.6及以上,而且安装补丁后要完成重启;只更新版本不重启,这项机制不会生效 tempdb数据文件数要匹配逻辑 CPU 数,例如 8 核至少配 8 个数据文件- 各个
tempdb数据文件的大小和增长设置要保持一致;如果仍是单文件配置,这套机制完全触发不了
这意味着,很多所谓“升级后还是慢”的案例,本质上还是旧配置沿用了下来,导致新版本能力没有被实际用上。
怎么验证是否真的缓解了争抢
可以直接看等待统计,比较升级前后的 PAGELATCH_UP 累计等待时间是否有明显下降。文中的判断标准很直接:如果下降幅度能超过 30%,说明配置方向基本正确。
SELECT * FROM sys.dm_os_wait_stats WHERE wait_type LIKE 'PAGELATCH%'如果等待没有下降,优先回头检查版本号、是否重启,以及 tempdb 文件数与大小设置,而不是急着重写存储过程。
参数敏感计划(PSP)没生效,常见原因是被自己关掉了
同一个存储过程面对不同参数值,本来就可能需要不同执行计划。典型例子是 @CustomerID = 'ALL' 这种大范围参数更适合扫描,但系统却一直复用小结果集场景下的查找计划。很多人会把这类现象归结为“PSP 没用”,但更常见的情况是:PSP 其实被开发阶段加上的提示绕开了。
哪些写法会直接让 PSP 不参与
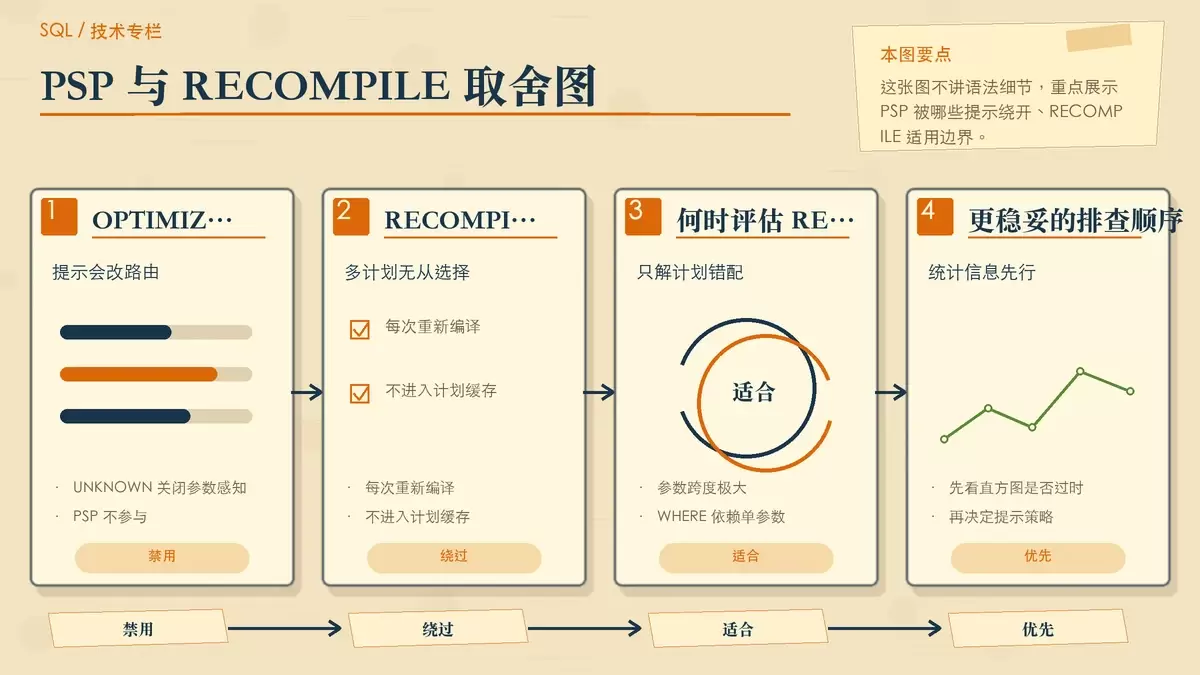
OPTIMIZE FOR UNKNOWN会让优化器主动放弃参数感知,等于直接禁用 PSP。只要存在这个提示,优化器就不会根据参数值保留多套候选计划WITH RECOMPILE或语句级OPTION (RECOMPILE)也会绕过 PSP。原因很简单:每次都重新编译,不进入计划缓存,自然没有“多计划并存、按参数选择”的空间
因此,看到“不同参数走同一个低效计划”时,第一步不是怀疑版本能力,而是先把这些提示找出来确认它们是否在主动干预优化器。
如何检查存储过程是否真的存在多计划
可以查看计划句柄是否出现多个版本。如果同一个过程始终只有同一套 plan_handle,那就说明多计划能力没有真正发挥出来。
SELECT p.*, q.query_plan
FROM sys.dm_exec_procedure_stats p
CROSS APPLY sys.dm_exec_query_plan(p.plan_handle) q
WHERE object_id = OBJECT_ID('YourProc')
按原文给出的判断方式,结果中的 plan_handle 不应全部相同。若始终只有一个句柄,再结合过程定义检查是否存在 OPTIMIZE FOR UNKNOWN、WITH RECOMPILE 或语句级重编译提示,通常就能找到原因。
OPTION (RECOMPILE) 该什么时候用,什么时候别急着加
OPTION (RECOMPILE) 经常被当成“计划不准就加一个”的通用解法,但它真正解决的是计划错配,不是所有性能问题。尤其在高频 OLTP 场景里,频繁重编译带来的 CPU 压力和编译开销,完全可能抵掉执行阶段节省下来的时间。
适合使用 RECOMPILE 的情况
- 参数取值跨度非常大,例如
@id从 1 到 500 万 - WHERE 条件几乎完全由这个参数决定
- 统计信息即使存在,也难以准确覆盖这种分布差异
这类查询容易出现严重的参数嗅探问题。对于极端参数值,单一缓存计划很难兼顾,临时重编译反而更容易拿到适合当前参数的方案。
不适合把 RECOMPILE 当默认选项的情况
- WHERE 条件里本身就有固定过滤,例如
AND Status = 1 - 参数分布比较均匀,例如
@region只有 5 个固定值
这时查询模式通常更稳定,PSP 或定向的 OPTIMIZE FOR 往往更轻量,也更适合长期运行的业务系统。
更稳妥的处理顺序
原文给出的优先级很值得直接照着做:先确认统计信息,再考虑参数提示,最后才评估是否要上重编译。
DBCC SHOW_STATISTICS- 先用
DBCC SHOW_STATISTICS看直方图是否过时 - 再考虑是否需要类似
OPTIMIZE FOR (@pid = 5000)这样的定向提示 - 最后才评估
RECOMPILE是否值得承担额外编译成本
这一步的核心判断不是“能不能更快”,而是“为了这点收益,是否值得付出每次重新编译的代价”。
查询存储里的优化重播,能省的是编译时间
优化重播脚本的价值,经常被误解成“跳过编译”。更准确地说,它复用了上一次优化过程中关键路径的决策快照,也就是 OptimizationReplay,目的是减少复杂查询再次编译时的成本。
对多表 JOIN、嵌套子查询、大量谓词这类复杂语句,它可能带来比较明显的收益;但它并不是无门槛可用,也不是所有查询都会保留这份重播信息。
哪些场景根本不会生成重播脚本
- 只对
StatementOptmLevel="FULL"的完全优化计划生效 - 带
RECOMPILE提示的语句不会生成 - 分布式查询不会生成
- 未启用查询存储的数据库也不会生成
也就是说,连前置条件都不满足时,再去讨论“为什么编译没变快”没有意义。
系统会不会一直保留这类脚本
不会。是否长期保留,取决于运行时的实际收益。只有当重放脚本节省的编译时间,大于保存它所带来的内存开销时,它才会继续留在缓存里;否则会被异步丢弃。
这点很关键,因为它说明优化重播本身也是成本收益模型的一部分,而不是一个永久开启、永久获益的静态优化项。
怎么验证它有没有带来效果
可以从查询存储中确认是否启用,再对比多次执行后的编译耗时。
SELECT is_optimization_replay_enabled, last_compile_duration_ms
FROM sys.query_store_plan- 查看
sys.query_store_plan中is_optimization_replay_enabled是否为 1 - 再对比同一查询多次执行后的
last_compile_duration_ms
如果启用了却没有看到明显下降,就要接受一个事实:这条语句未必足够复杂,或者节省下来的编译时间还不足以覆盖其内存代价。
别把统计信息放到最后,它其实是所有优化的前提
无论是 tempdb 并发更新、PSP,还是查询存储中的优化重播,最终都依赖优化器先拿到尽量接近真实分布的数据画像。只要统计信息明显过时,行数估算就会偏离实际,后面这些“智能机制”也很难选中正确计划。
这也是原文里最容易被忽略、但实际最该先检查的一点:别只盯着版本、补丁和数据库开关,先确认统计信息到底新不新。
UPDATE STATISTICS排查时可以直接看关键列统计信息的修改计数,确认它是否已经远超应触发更新的阈值。
sys.dm_db_stats_properties如果这里已经明显失真,那么先处理统计信息,通常比继续折腾提示、缓存或配置更有效。对存储过程执行计划来说,统计信息不是收尾动作,而是所有优化动作能否成立的起点。









