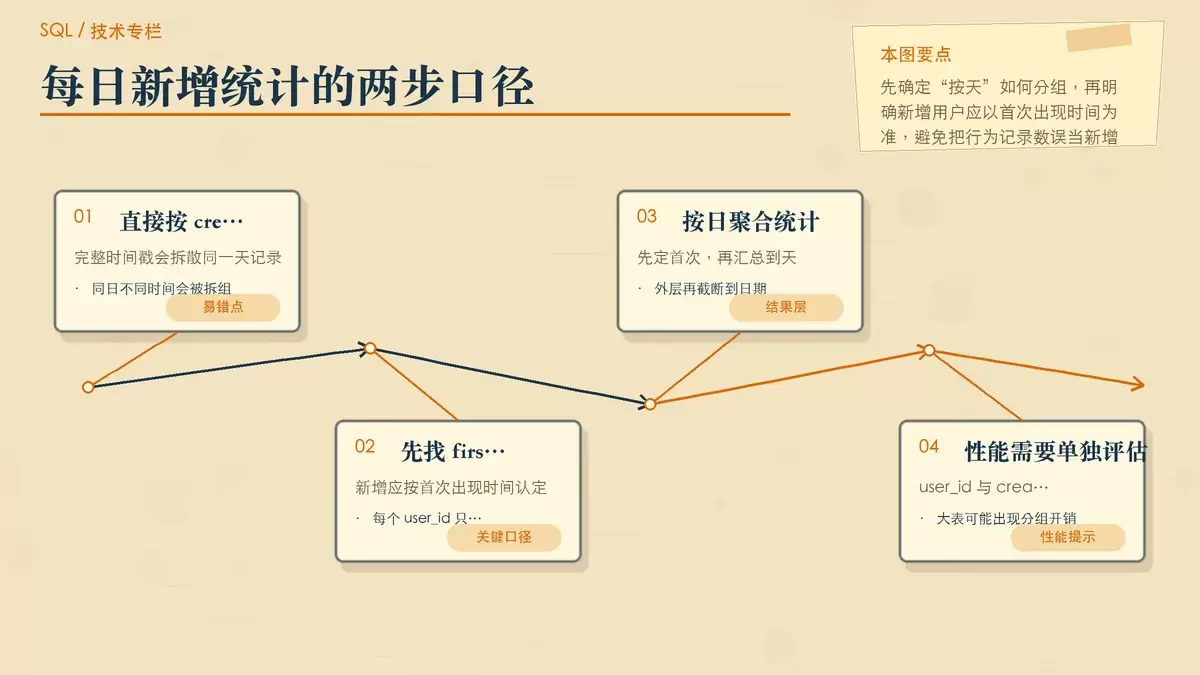
SQL 中如何按日期分组统计每日新增用户?
按日期统计每日新增用户,常见误区不是 SQL 语法,而是统计口径和时间处理。关键点有三处:先把时间截断到“日”,再用每个用户的最早注册时间定义新增,最后把时间过滤放进子查询,同时排除 NULL 和异常时间值,结果才可靠。
2026-08-25
113

按日期统计每日新增用户,常见误区不是 SQL 语法,而是统计口径和时间处理。关键点有三处:先把时间截断到“日”,再用每个用户的最早注册时间定义新增,最后把时间过滤放进子查询,同时排除 NULL 和异常时间值,结果才可靠。
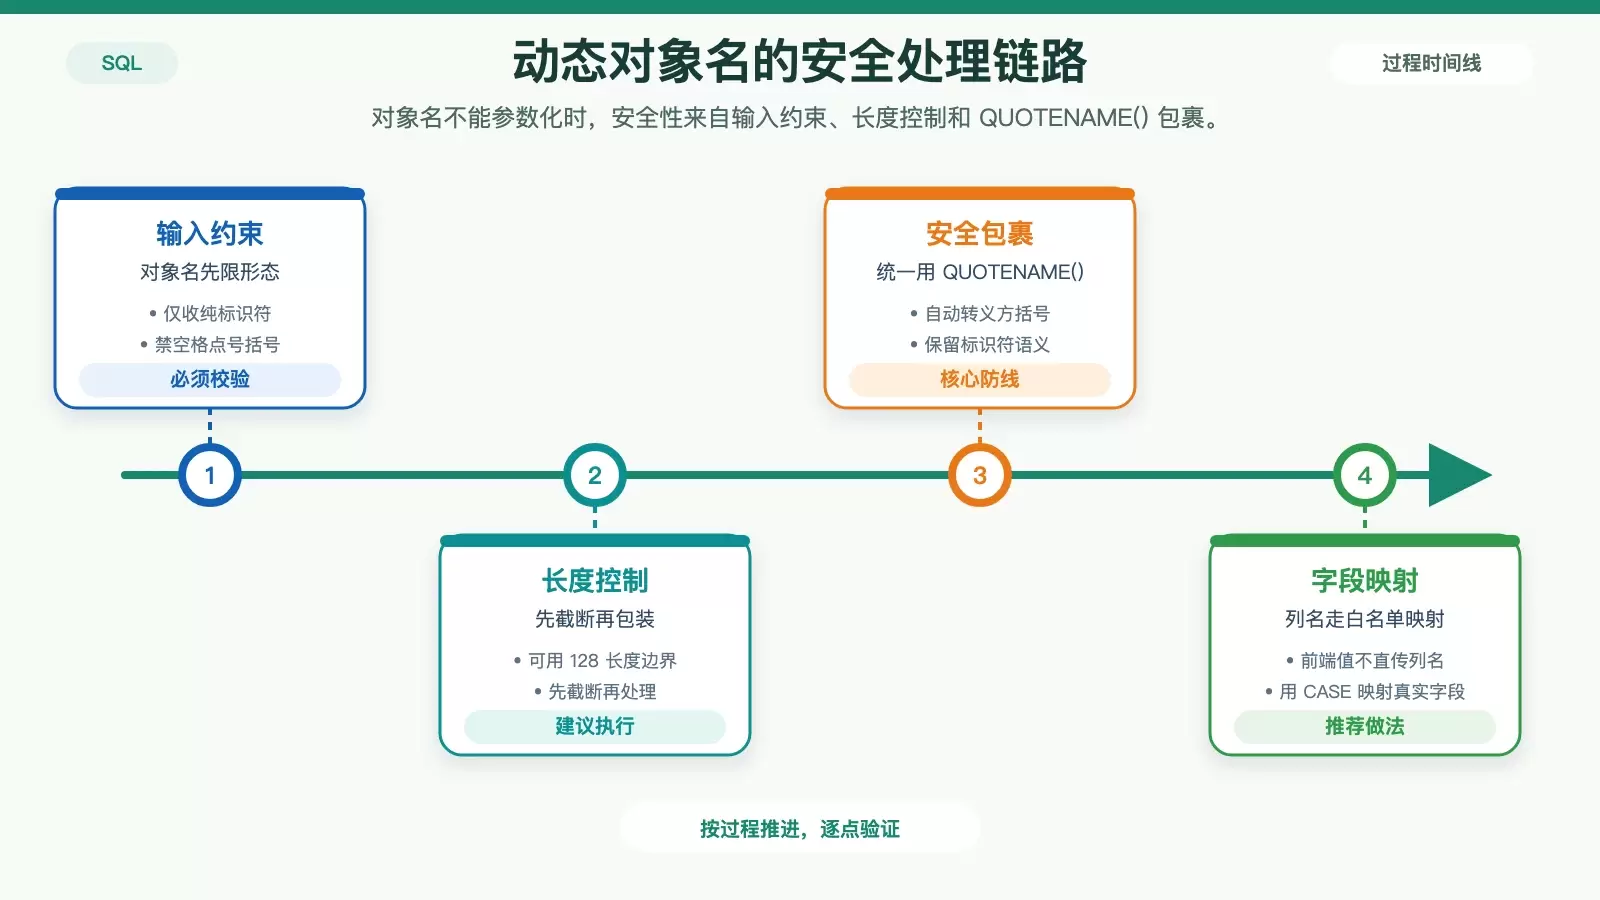
在 SQL Server 里,`sp_executesql` 只能保护值参数,挡不住列名、表名、排序方向这类动态语法片段的注入风险。要把动态 SQL 存储过程写安全,关键是把对象名、枚举值、执行权限分别收紧,并彻底放弃“过滤关键字”这类伪防护。
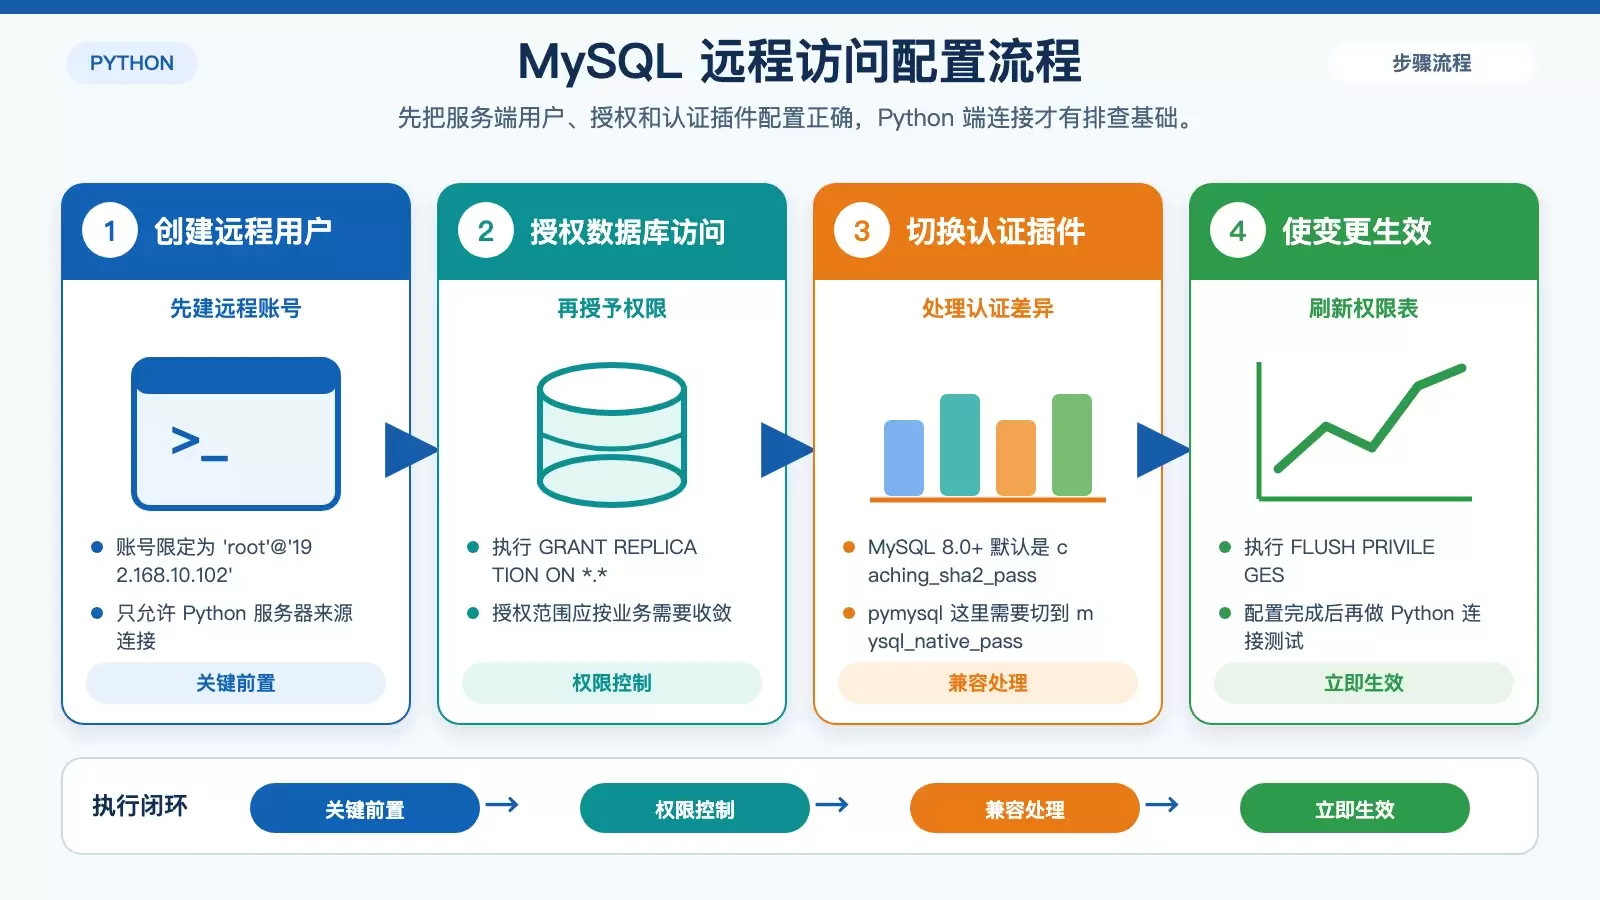
这篇文章用一套可落地的示例,把 Python 远程连接 MySQL 的关键环节串了起来:从服务端授权、认证插件兼容,到 `pymysql` 连接、常见 CRUD、事务、隔离级别和连接池。保留原始命令与代码的同时,也补出了每一步该关注的风险点和适用场景。
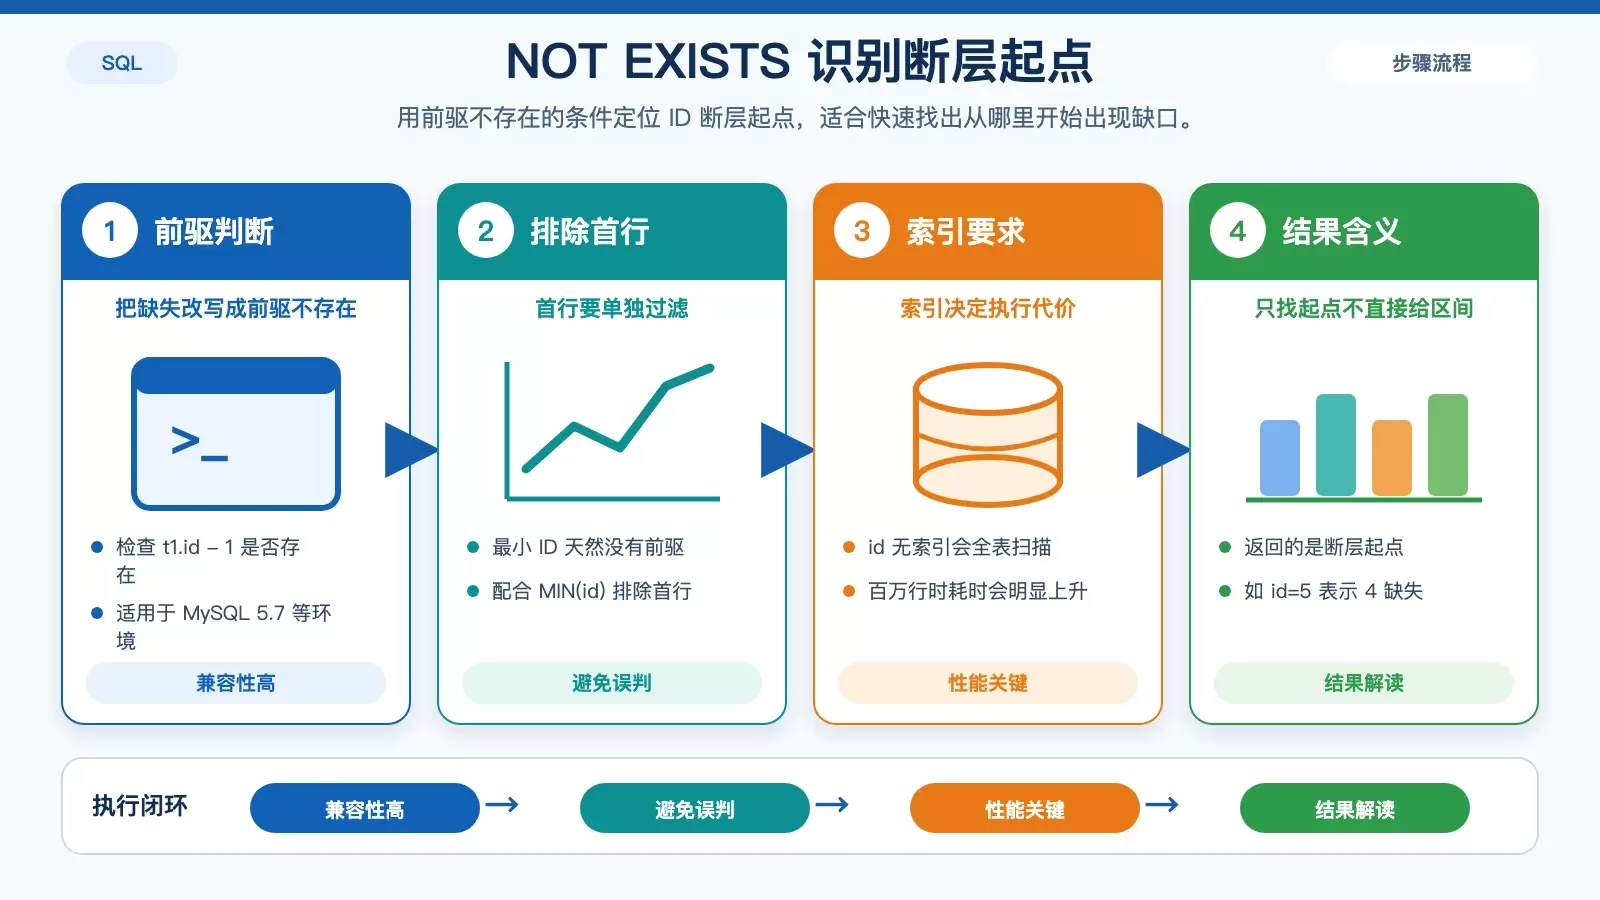
子查询并不会自动识别“数据断档”,真正决定结果的是你如何把“前驱缺失”“区间补全”这类对比关系写清楚。本文围绕 `NOT EXISTS`、`EXCEPT`/序列生成,以及模拟 `LAG()` 的常见陷阱,梳理不同数据库里的可用写法、适用前提与性能边界。
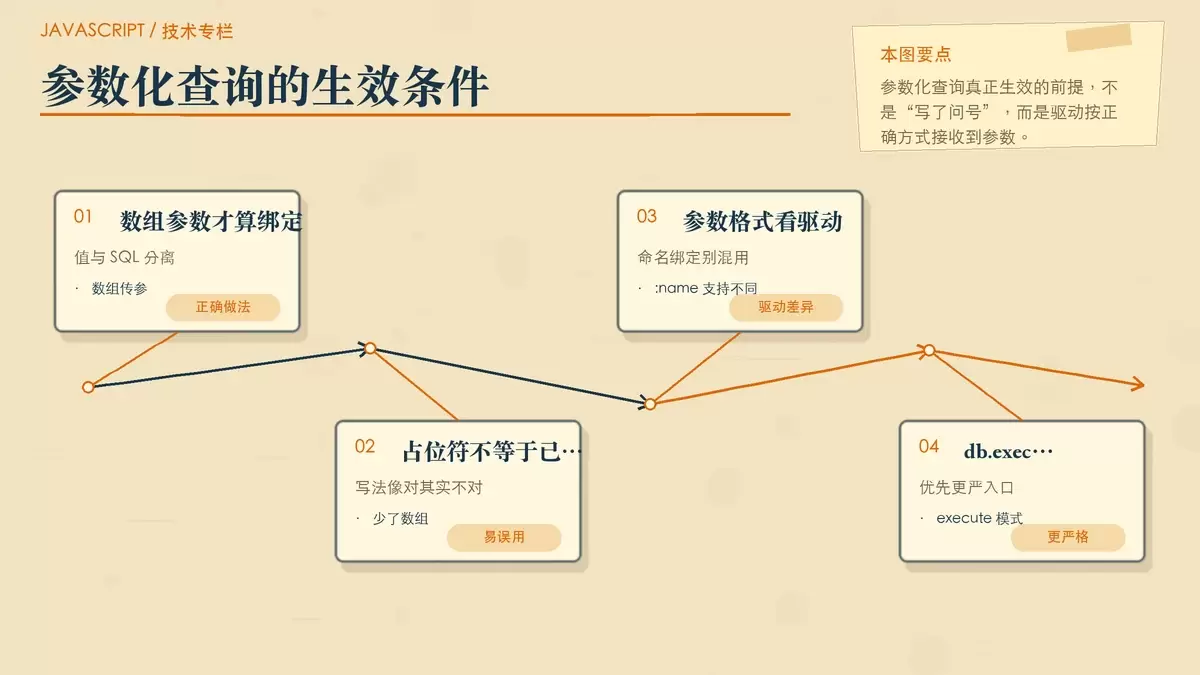
Node.js 22 并不会自带 SQL 注入防护,真正决定安全性的仍是数据库驱动、ORM 和代码写法。本文围绕 mysql2、pg、Sequelize 与 Joi 这几类常见组合,拆开说明哪些写法真正触发参数化,哪些地方看似校验完善却仍可能被拼接注入。
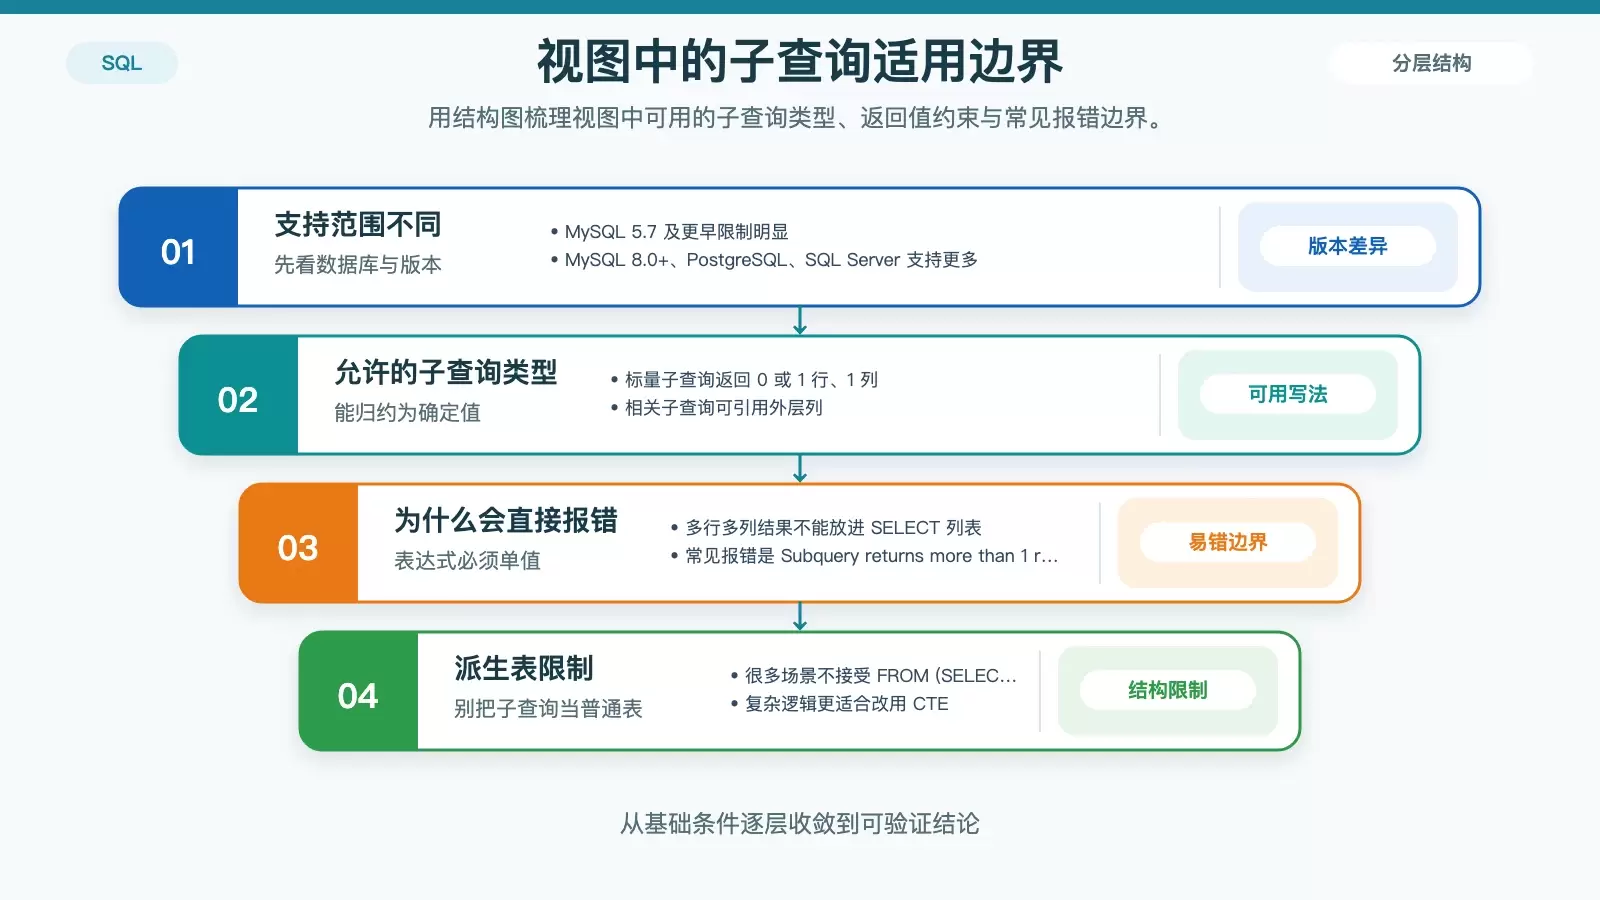
在 SQL 视图中使用子查询并非一律可行,关键在于数据库版本、子查询类型以及优化器的处理方式。本文从能否直接写、何时用 WITH 改写、MySQL 5.7 的替代方案,到常见性能失速原因,梳理出一套更适合落地判断的写法与排查思路。
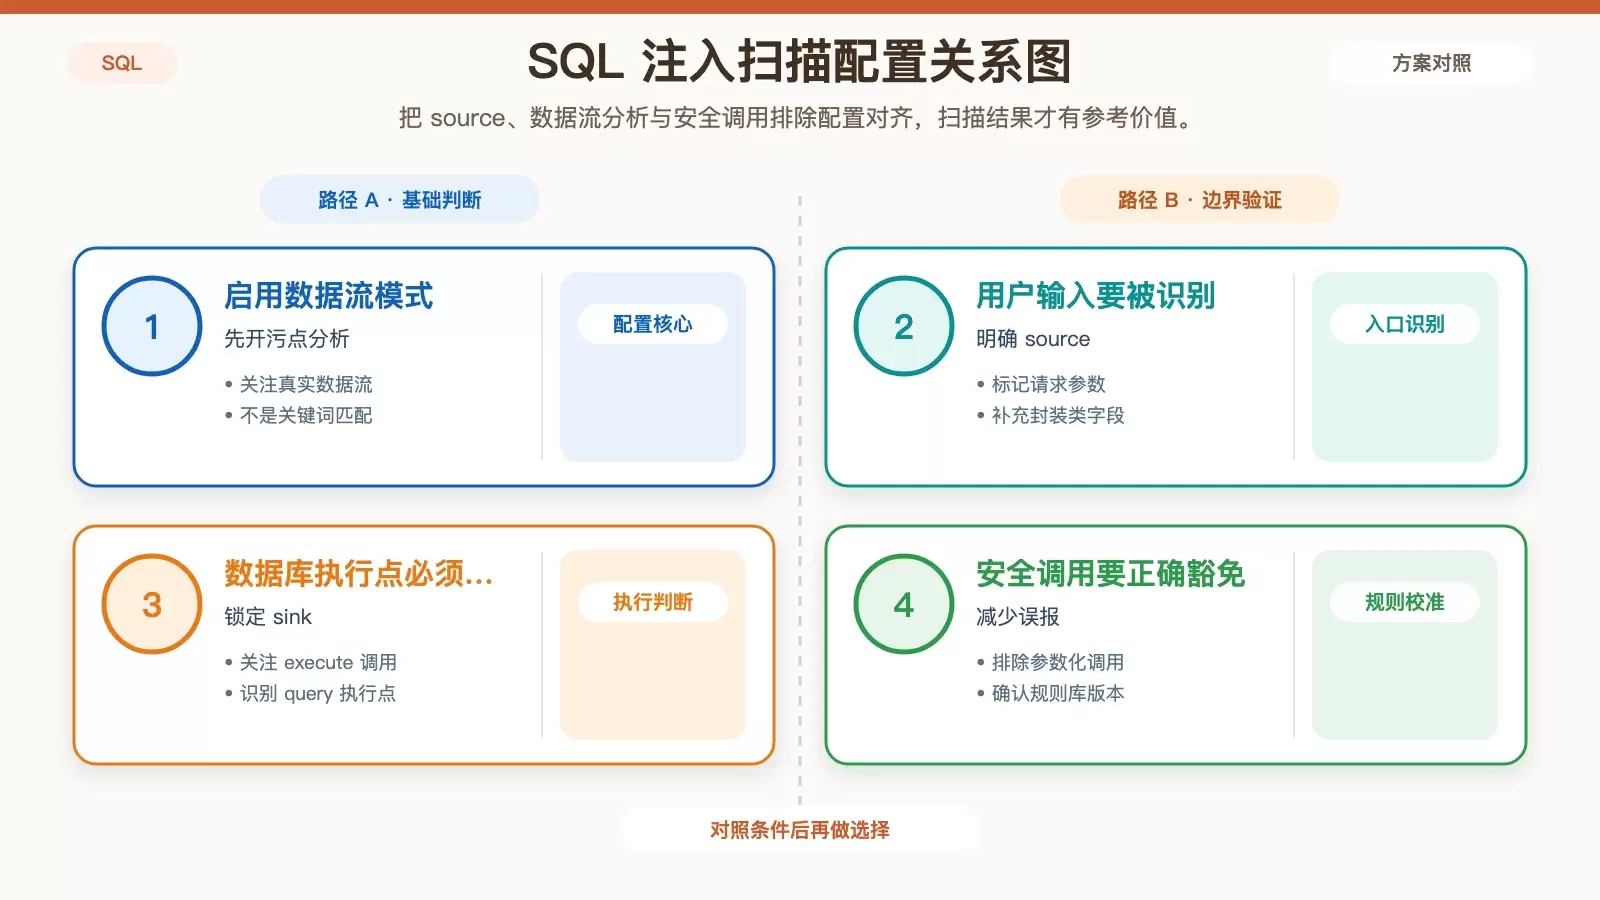
SAST 发现 SQL 注入,核心依赖 AST 分析和污点追踪:把用户输入一路跟到数据库执行点。但扫描结果并不能直接等同于漏洞结论,配置不完整会漏报,规则理解不到位也会误报。要把结果用起来,关键在于先配对 source、sink 和安全调用,再结合人工复核与 DAST 做交叉验证。
这篇内容把几段常见的 Scala 与 Akka 练习题重新整理成可发布的技术文章,涵盖递归求解“喝酒换瓶”、控制台猜拳、位置时长汇总 SQL,以及 Actor 通讯与 Master/Worker 心跳机制。重点不在堆代码,而是说明每题解决什么问题、核心实现如何运转,以及哪些写法值得直接借鉴。
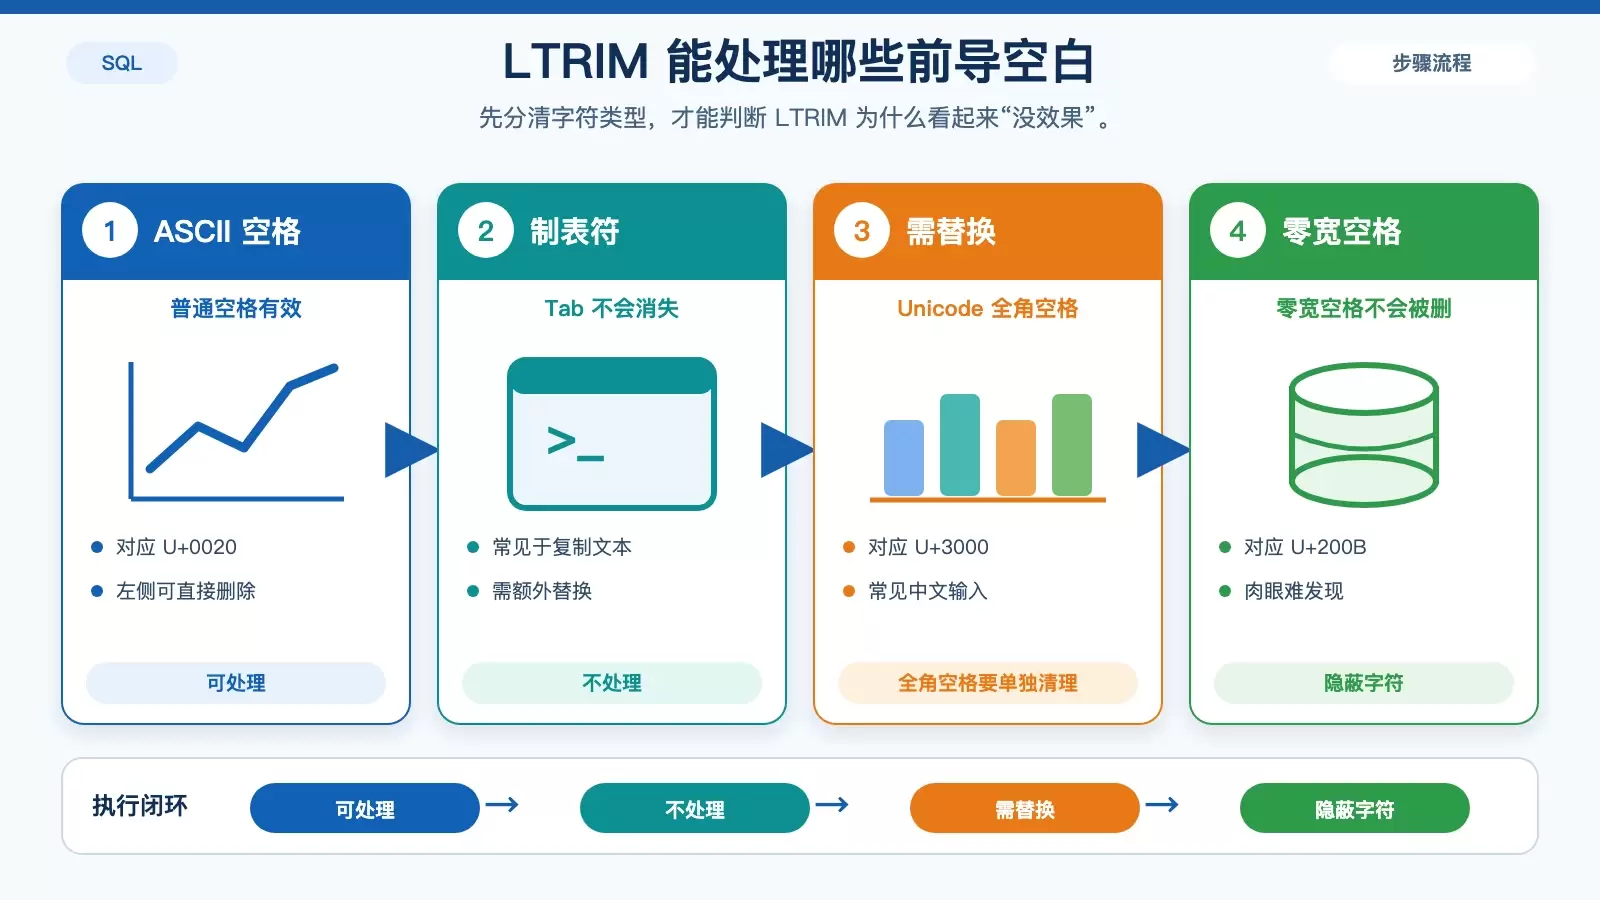
LTRIM 常被拿来清理字符串左侧空格,但它的适用范围其实很窄:只处理 ASCII 空格,跨数据库支持也不一致。本文按“能不能用、为什么没效果、会不会拖慢查询、迁移时怎么替代”四个问题梳理 SQL Server、MySQL 和 PostgreSQL 中的正确写法与避坑点。
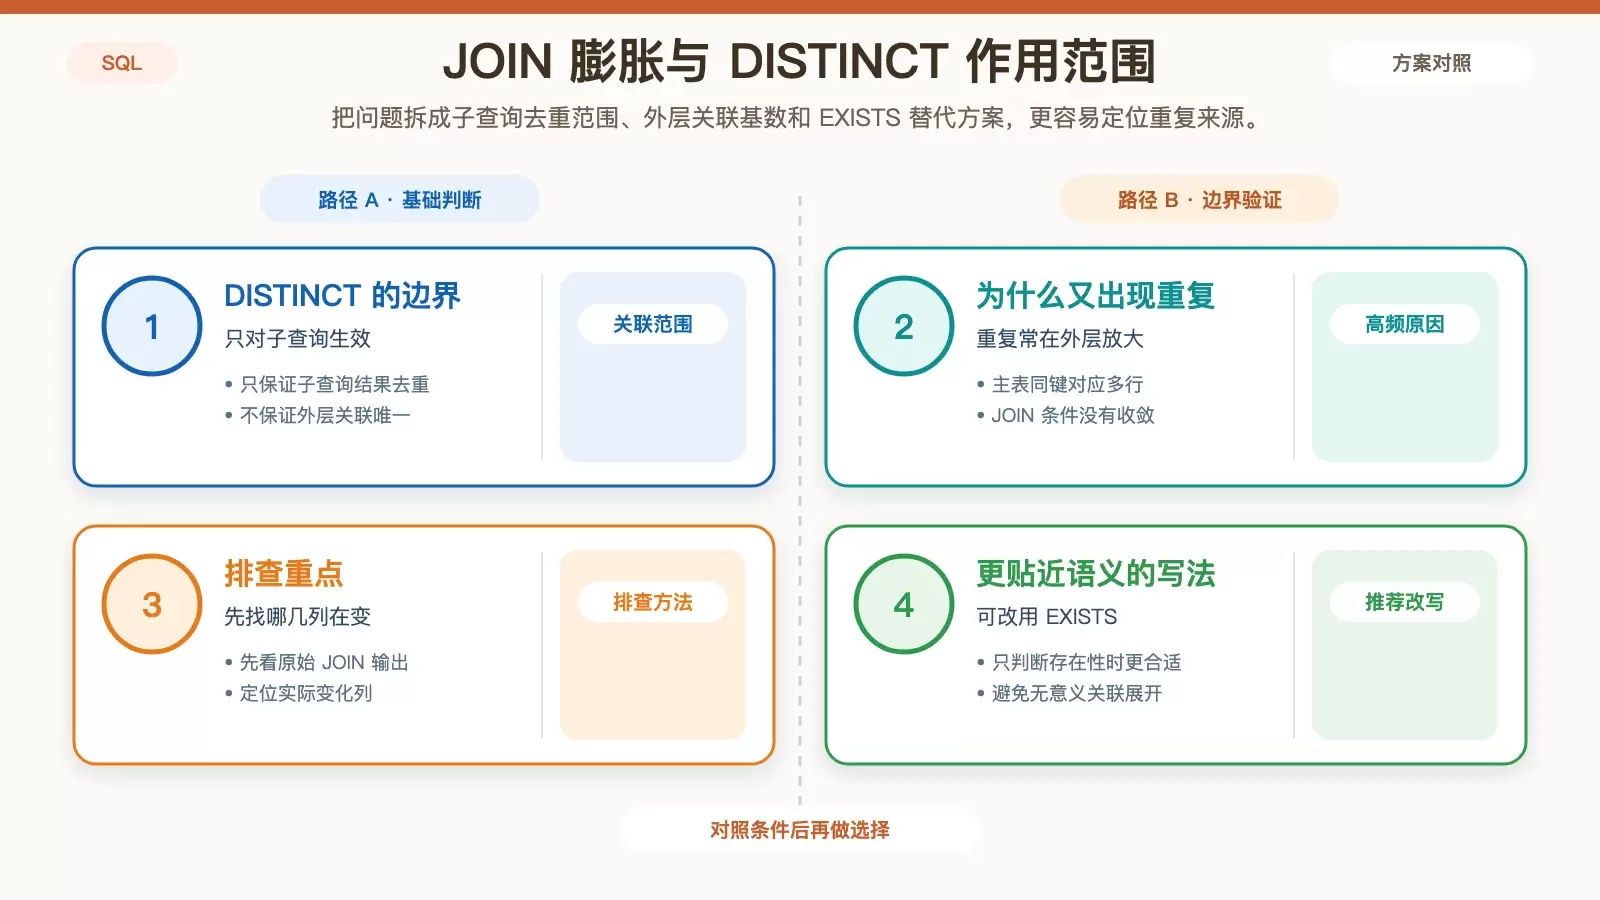
很多 SQL 查询里,子查询明明加了 DISTINCT,结果外层一 JOIN 还是出现重复,看起来像“去重失效”。问题通常不在 DISTINCT 本身,而在 JOIN 路径、字段组合唯一性、隐藏差异值,以及 GROUP BY、窗口函数、ORDER BY 等语义冲突上。 在 SQL 排查里, DISTINCT 经常被拿来压重复,但子查询一旦参与 JOIN、排序或分组,结果就可能和预期完全相反。
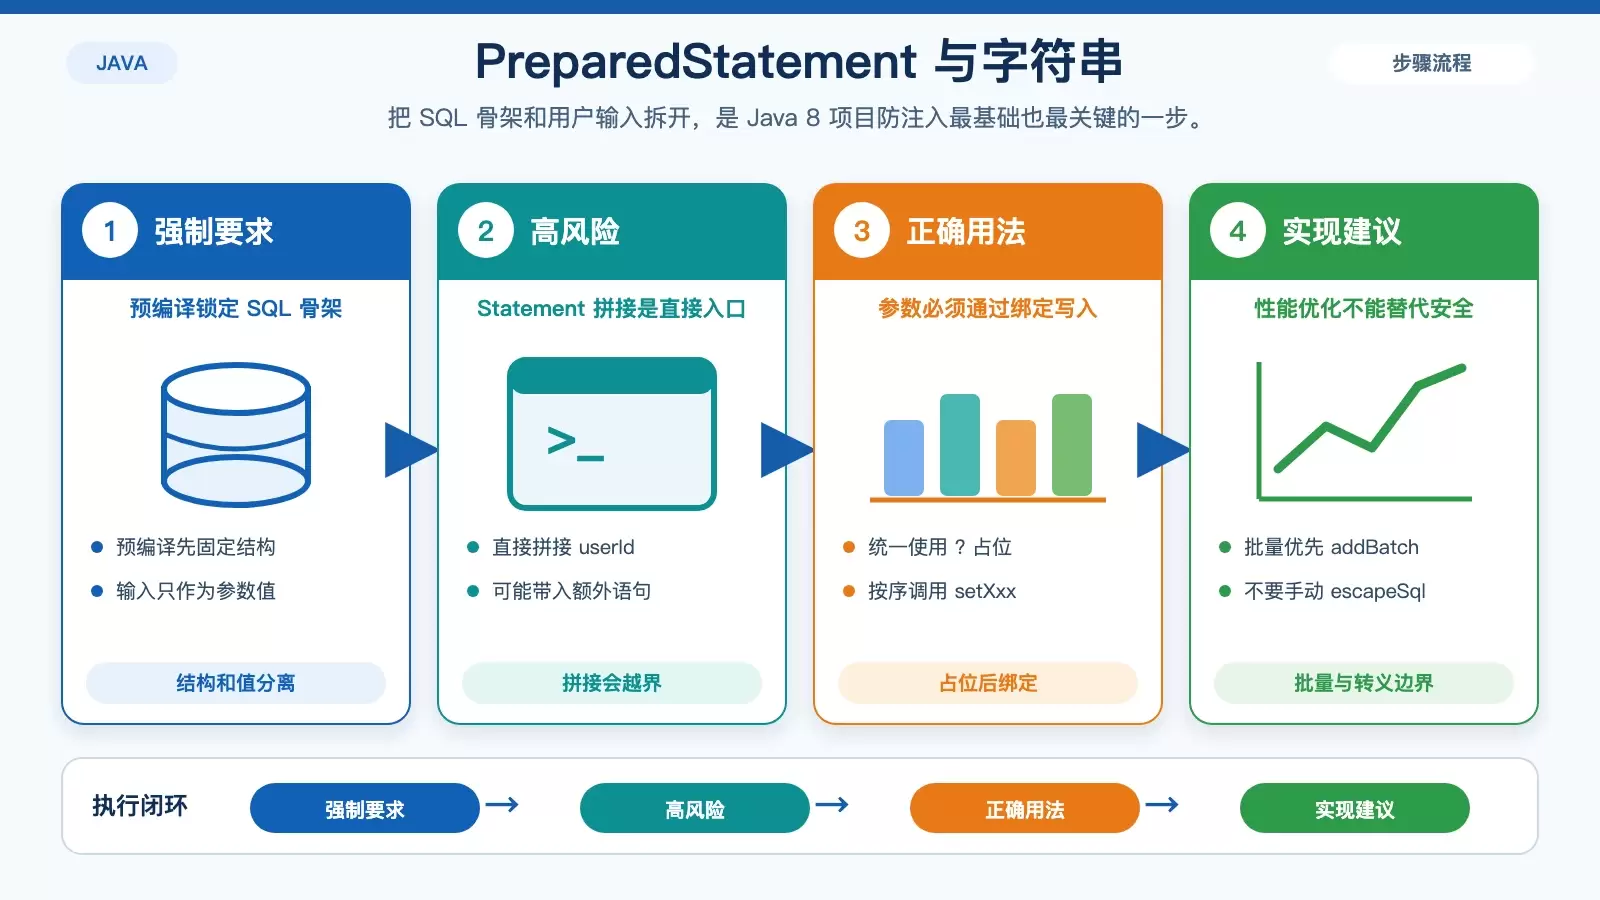
在 Java 8 项目里,防 SQL 注入不能靠“过滤关键字”这类经验做法,真正有效的是把 SQL 结构和用户输入彻底隔离。本文围绕 JDBC、MyBatis、异常处理和输入校验四个环节,梳理哪些写法安全、哪些地方最容易失守。
PostgreSQL 16 的 `REFRESH MATERIALIZED VIEW CONCURRENTLY` 并不是增量刷新,能否执行首先取决于物化视图上是否存在满足规则的唯一索引。本文梳理报错成因、索引硬条件、常见失败场景,以及并发刷新的真实性能代价与可替代思路。