


很多人第一次用 LEAD 时,以为它会自动返回“下一条记录”,实际并不是这样。它只有在你用 OVER、PARTITION BY 和 ORDER BY 明确写出业务顺序后,才知道什么叫“下一行”;本文就从报错原因、NULL 结果和参数设置三类高频问题入手,帮你判断查询到底是语法没写对,还是业务分组和排序逻辑出了偏差。
LEAD 为什么不能直接用
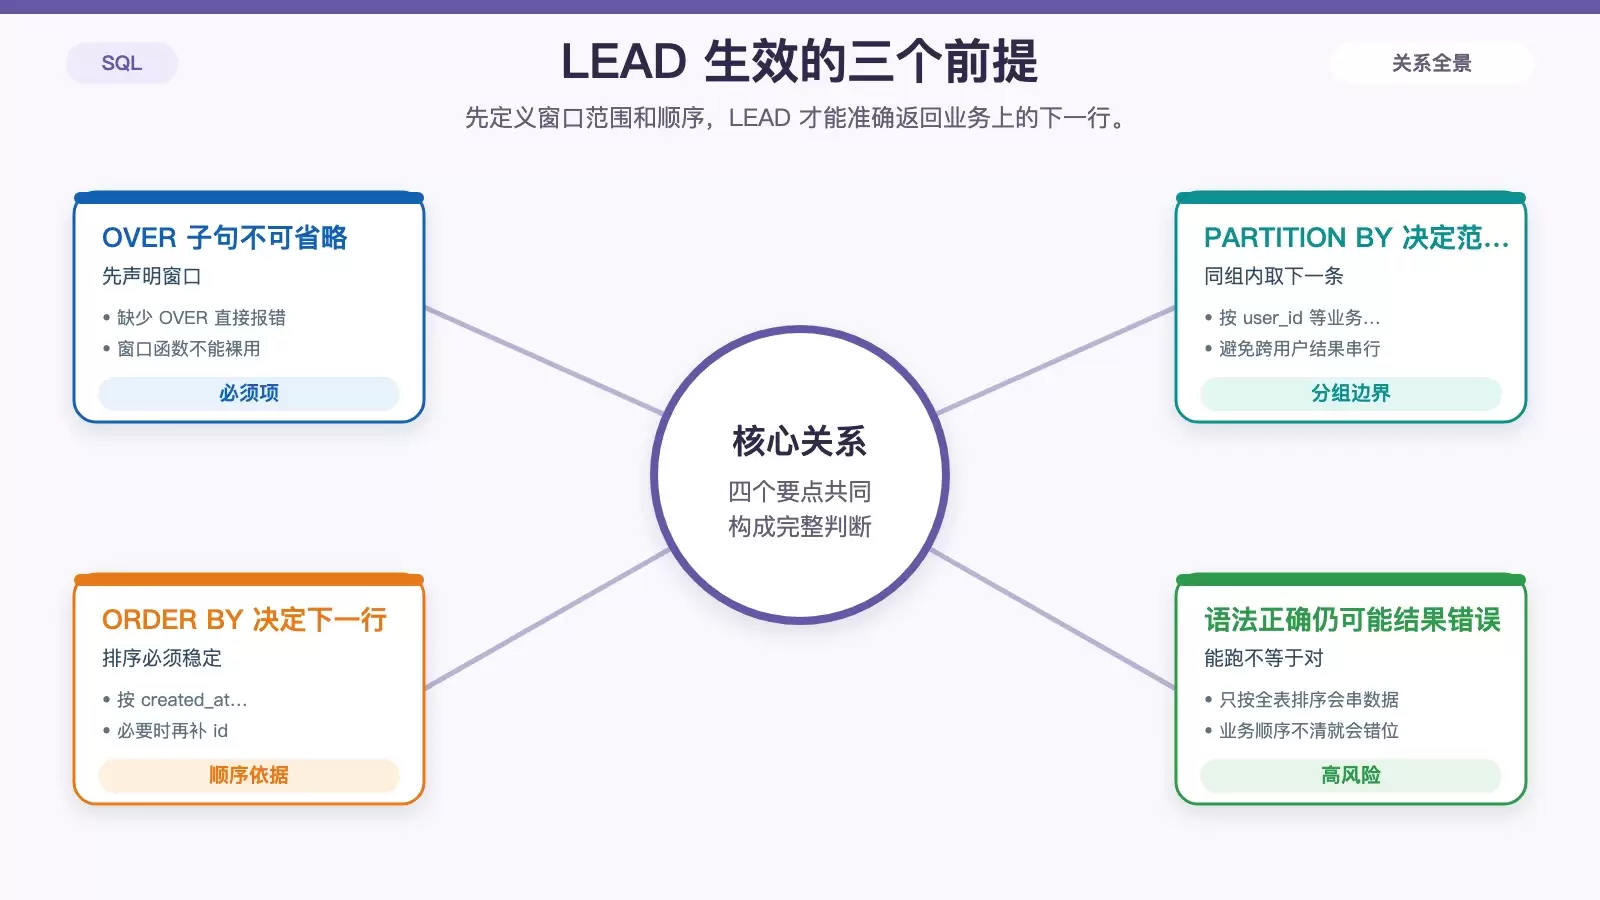
LEAD 是窗口函数,不是普通标量函数,所以不能裸写在查询里。只要没有 OVER (...) 子句,数据库通常就会直接报错。
常见错误写法如下:
SELECT id, LEAD(amount) FROM orders这类写法通常会触发类似错误:
Window function requires OVER clause正确写法至少要补上排序规则,例如:
LEAD(amount) OVER (ORDER BY created_at)如果业务上还需要按用户隔离,再进一步写成:
LEAD(amount) OVER (PARTITION BY user_id ORDER BY created_at, id)这里最关键的不是“把语法补完整”,而是理解 LEAD 并不会自动判断哪一条是下一条。你给它什么顺序,它就按什么顺序取值。
ORDER BY不能省略,而且排序字段必须有明确业务意义。- 如果只按
id排序,前提是id真的能反映业务时序,否则结果可能看起来能跑、实际已经错位。 - 如果缺少
PARTITION BY,不同用户、不同产品或不同业务对象的数据可能会被串在一起计算。
比如张三的最后一笔订单,理论上下一条应该不存在;但如果没有按 user_id 分组,LEAD 可能直接把李四的第一笔订单接到后面。这类问题不会报错,却会让结果在业务上完全失真。
LEAD 返回大量 NULL,通常不是函数坏了
LEAD 返回 NULL 本身是正常语义,因为每个分组的最后一行本来就没有“下一行”。真正需要警惕的是:为什么会出现一大批看起来不合理的 NULL。
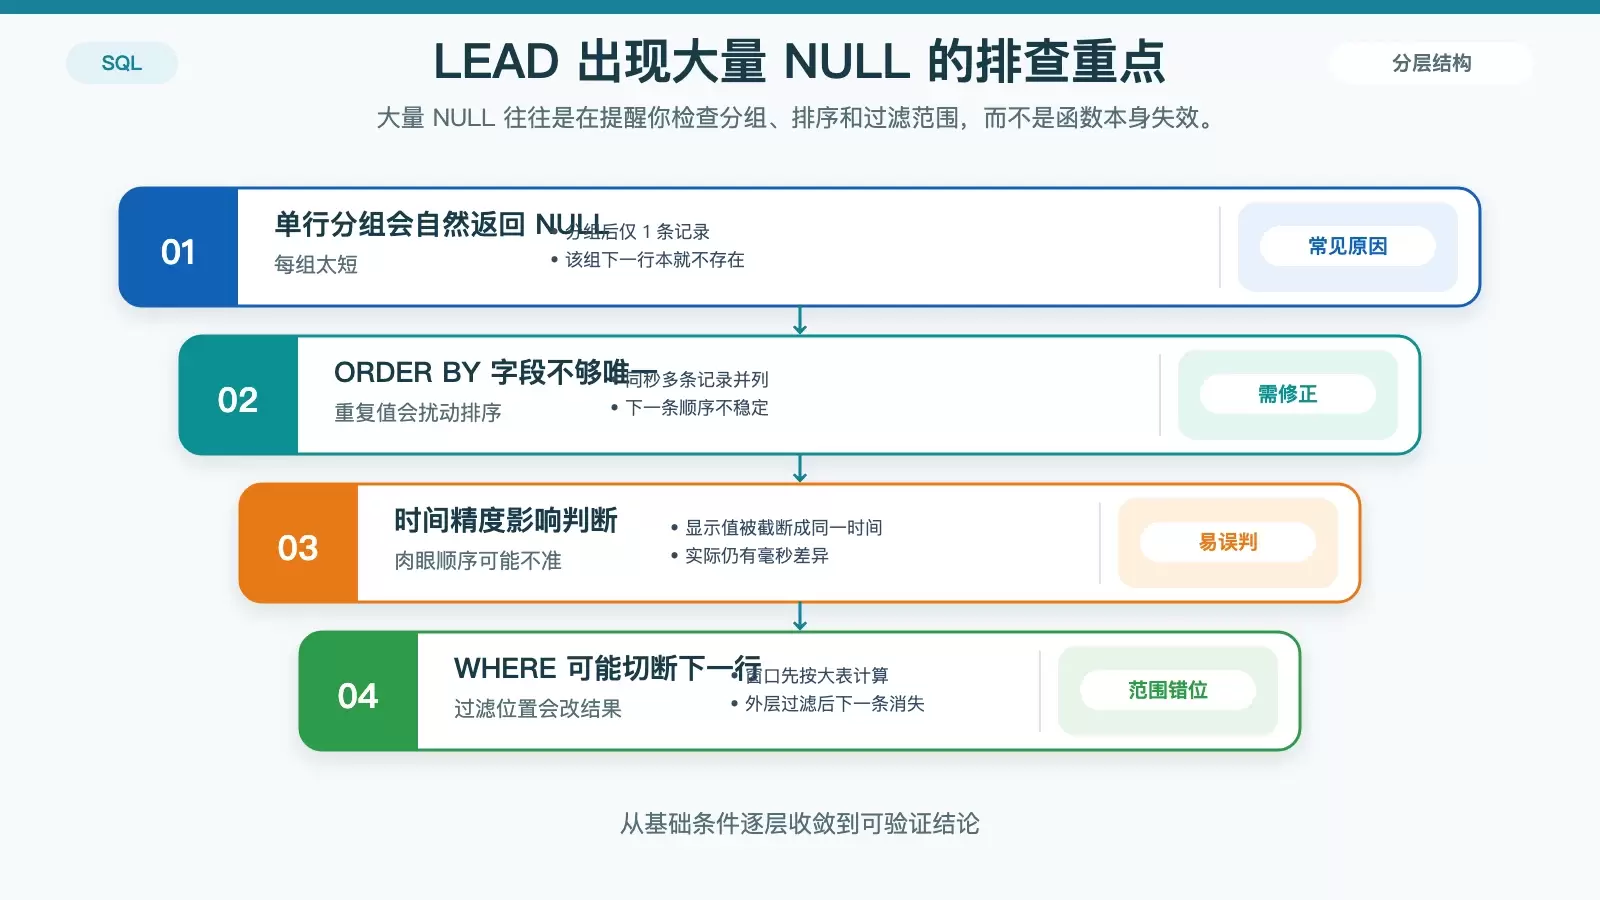
常见原因主要有几类。
分组后每组只有一条记录
如果你加了 PARTITION BY,而某些分组本身只有一条数据,那么该组的 LEAD 结果自然就是 NULL。这种情况在按用户、商品或订单状态细分后很常见。
排序字段不稳定,导致“下一条”无法确定
如果 ORDER BY 使用的字段有重复值,比如多个订单在同一秒创建,数据库就无法稳定判断先后顺序。此时 LEAD 不是严格意义上的错,而是会在不稳定顺序上取“下一条”,结果容易漂移。
更稳妥的写法通常是增加二级排序字段:
ORDER BY created_at, id这样即使 created_at 相同,也能用 id 继续消除并列,避免结果随机错位。
时间字段看着一样,实际并不完全一样
有些表里的时间字段带毫秒甚至更高精度,但展示时被截断了。你肉眼看到多条记录时间相同,数据库实际排序时却能分出细微先后,这就容易让人误判结果“怎么不按预期”。
这类场景下,仍建议显式补上稳定的二级排序字段,而不要依赖“看起来差不多”的时间顺序。
过滤位置不对,窗口和结果集不一致
另一个容易忽视的问题,是 WHERE 条件写在外层。这样会导致窗口函数先基于更大的数据集完成计算,最后再过滤出部分记录。于是你看到的当前行还在,但它原本对应的“下一行”已经被过滤掉了,结果自然可能是 NULL。
所以当 LEAD 出现大量 NULL 时,先不要急着怀疑函数语法,通常更值得检查的是:分组是否过细、排序是否稳定、过滤是否影响了窗口范围。
offset 和 default 该怎么设
LEAD 的完整形式通常写作:
LEAD(column, offset, default)这三个参数里,真正容易踩坑的是后两个。
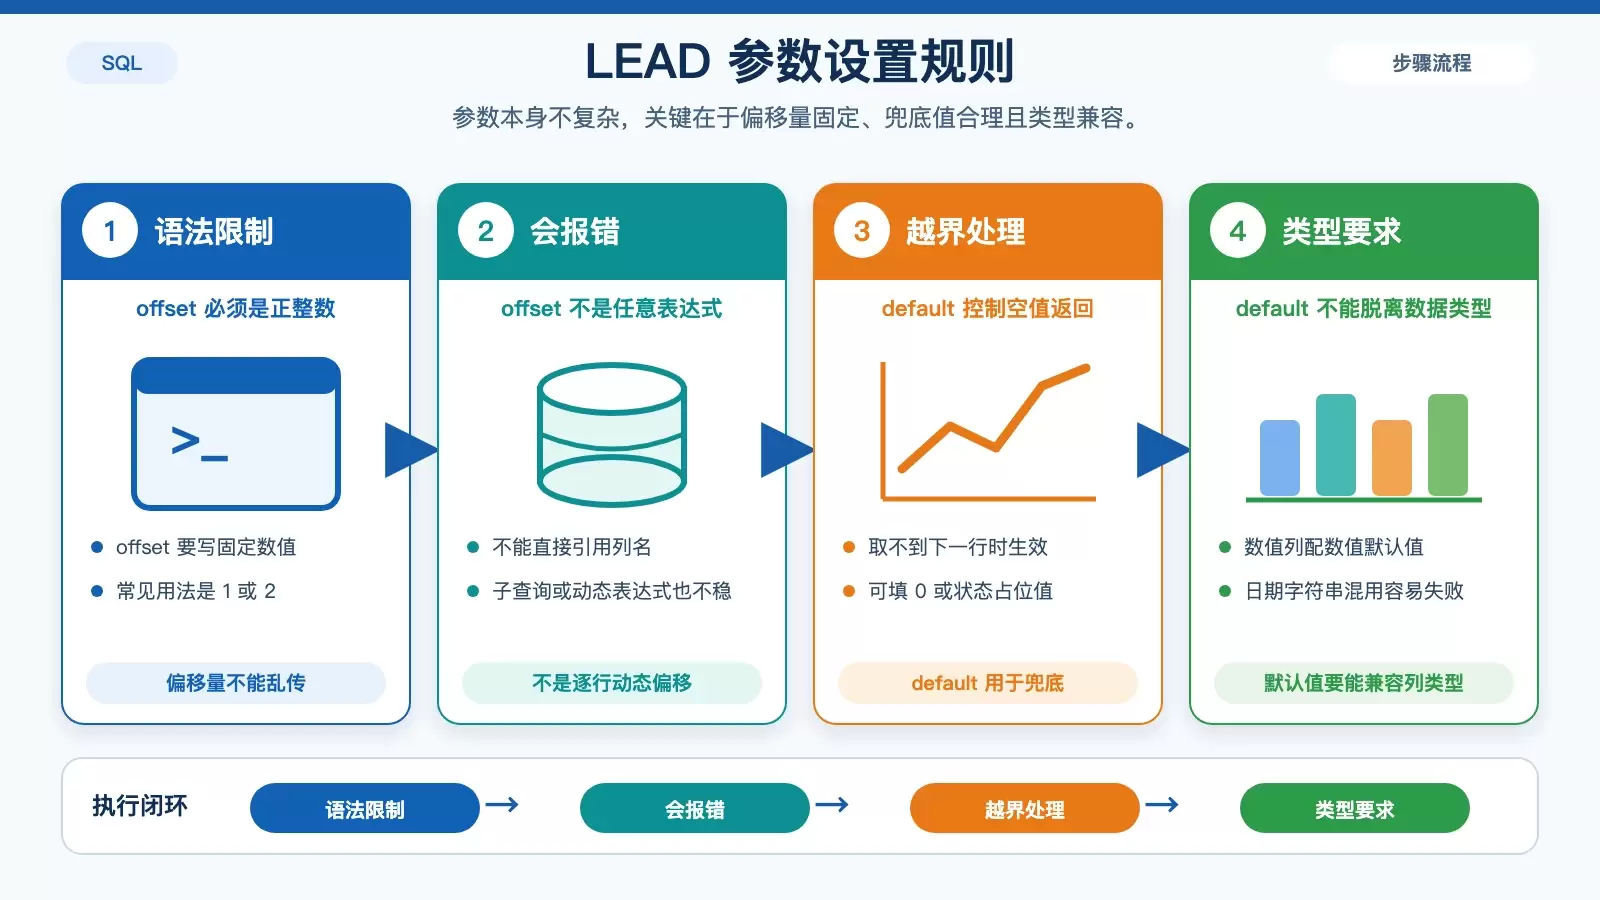
offset 必须是正整数
offset 表示向后取第几行,必须是常量正整数。也就是说,像下面这样是合法的:
LEAD(amount, 2)但如果把列名、子查询或不被支持的表达式塞进去,就可能直接报错,例如:
LEAD(amount, days_later)实际使用时,可以把它理解成一个固定偏移量,而不是“按每行动态计算下一条”。
default 用来处理越界结果
当偏移超出当前分组范围时,LEAD 默认返回 NULL。如果业务上不希望得到空值,就可以通过第三个参数提供兜底值。
例如环比分析里,为了避免后续计算出现空值或除零问题,可以这样写:
LEAD(revenue, 1, 0)如果你是在做状态流转判断,也可以填字符串:
LEAD(status, 1, 'unknown')default 的类型必须和目标列兼容
这里不能随意填值。default 的类型必须与目标列匹配,或者至少能够兼容转换;否则数据库可能发生隐式转换失败,尤其在日期、数字、字符串混用时更常见。
换句话说,LEAD 的参数问题往往不是“语法写不出来”,而是你给出的偏移和兜底值,是否真的符合当前列的数据类型和业务含义。
真正难点在于把业务上的“下一笔”翻译成窗口规则
从语法层面看,LEAD 并不复杂;真正容易出问题的地方,是如何把“业务上的下一笔、下一单、下一次状态变化”准确映射成 OVER 子句里的分组和排序。
通常可以这样理解:
PARTITION BY解决的是“谁和谁属于同一条业务链”。ORDER BY解决的是“这条业务链内部的先后顺序”。
这两个条件只要少一个字段,结果就可能偏掉一整组数据。比如你以为自己在取“某用户的下一笔订单”,实际却写成了“全表按时间排序后的下一条记录”;或者你以为自己按时间排序已经足够,实际同一时间戳下还需要 id 做二级排序才能稳定。
因此,判断 LEAD 是否写对,不能只看 SQL 能不能执行,还要反过来检查一句话:你定义的 PARTITION BY + ORDER BY,是否真的等价于业务口径里的“下一行”。只有这一步对齐了,LEAD 返回的数据才可信。









