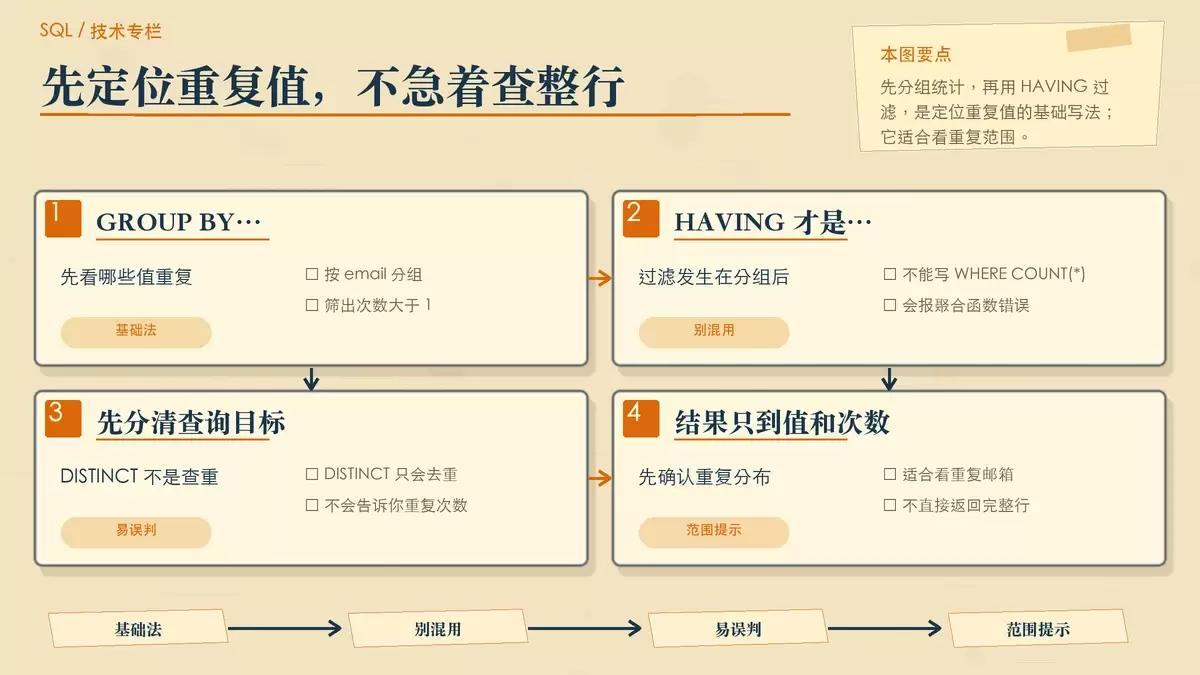
如何使用 SQL SELECT 查询重复数据?
SQL 查重常见分成两类:先找出哪些值重复,再定位到具体重复行。本文按查询目标和数据库版本拆开说明,分别给出 GROUP BY + HAVING、ROW_NUMBER() 以及 MySQL 5.7 自连接方案,并补上删除前最容易忽略的保留策略与复核要点。
2026-08-25
137

SQL 查重常见分成两类:先找出哪些值重复,再定位到具体重复行。本文按查询目标和数据库版本拆开说明,分别给出 GROUP BY + HAVING、ROW_NUMBER() 以及 MySQL 5.7 自连接方案,并补上删除前最容易忽略的保留策略与复核要点。
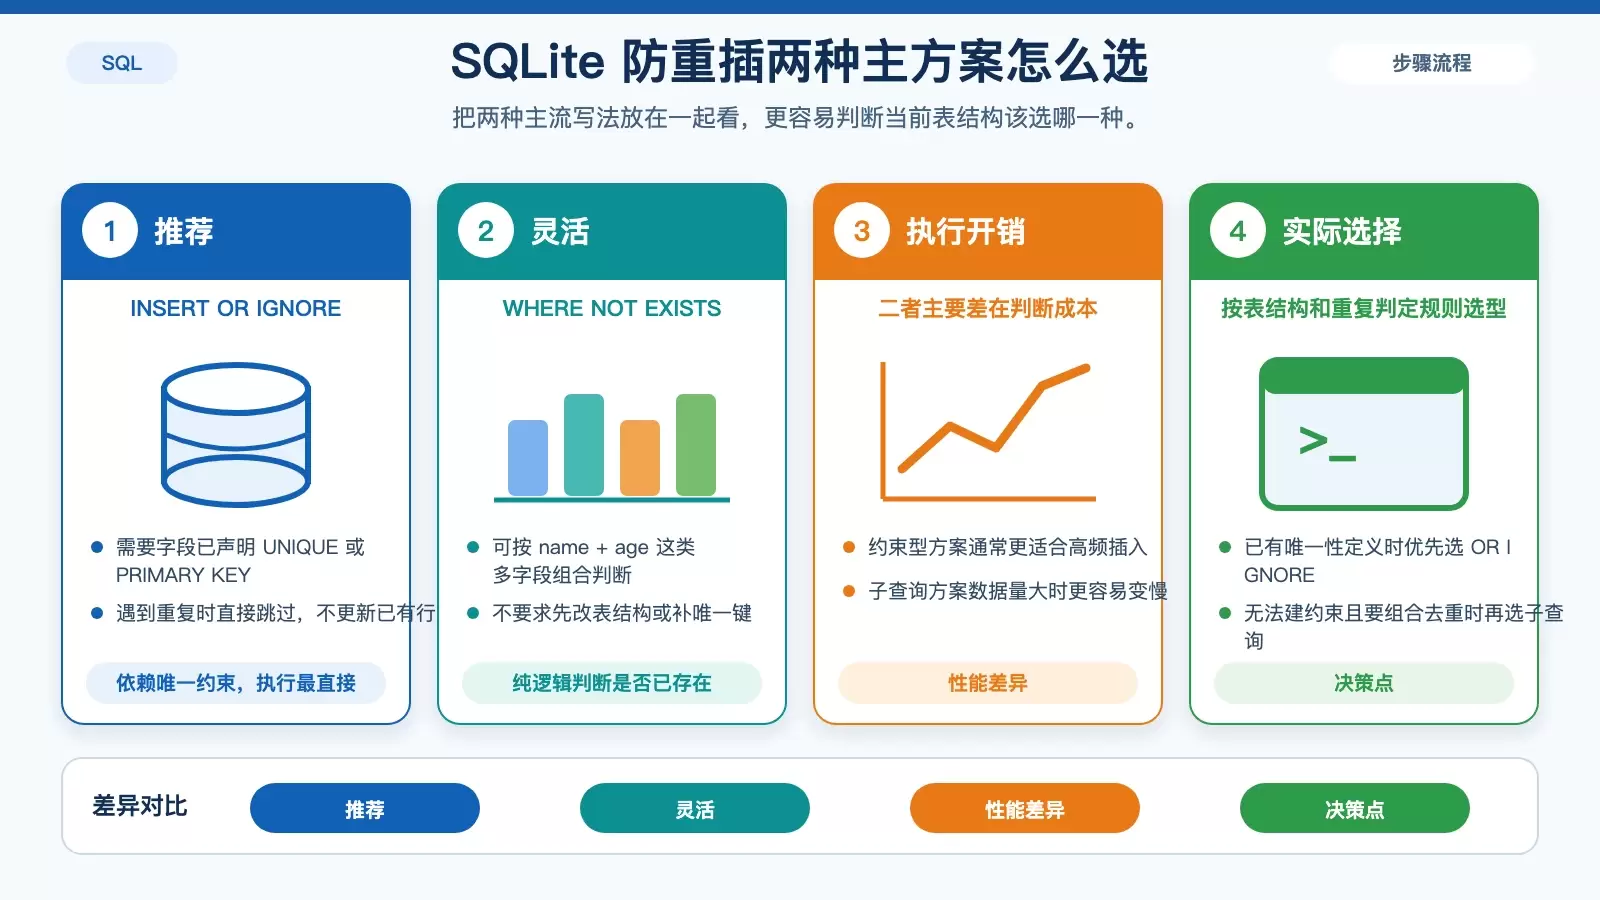
SQLite 3 不能直接写 `INSERT IF NOT EXISTS`。要实现“数据不存在才插入”,通常只有两条路:基于唯一约束的 `INSERT OR IGNORE`,或用 `INSERT ... SELECT ... WHERE NOT EXISTS` 做显式判断;两者适用场景、性能和坑点都不一样。 在 SQLite 3 里,很多人会下意识写出 INSERT IF NOT EXISTS ,但这条语法本身并不存在。真正要做“防重插”,要么依赖表上的唯一约束配合 INSERT OR IGNORE ,要么改写成带子查询的 INSERT ... SELECT ... WHERE NOT EXISTS 。
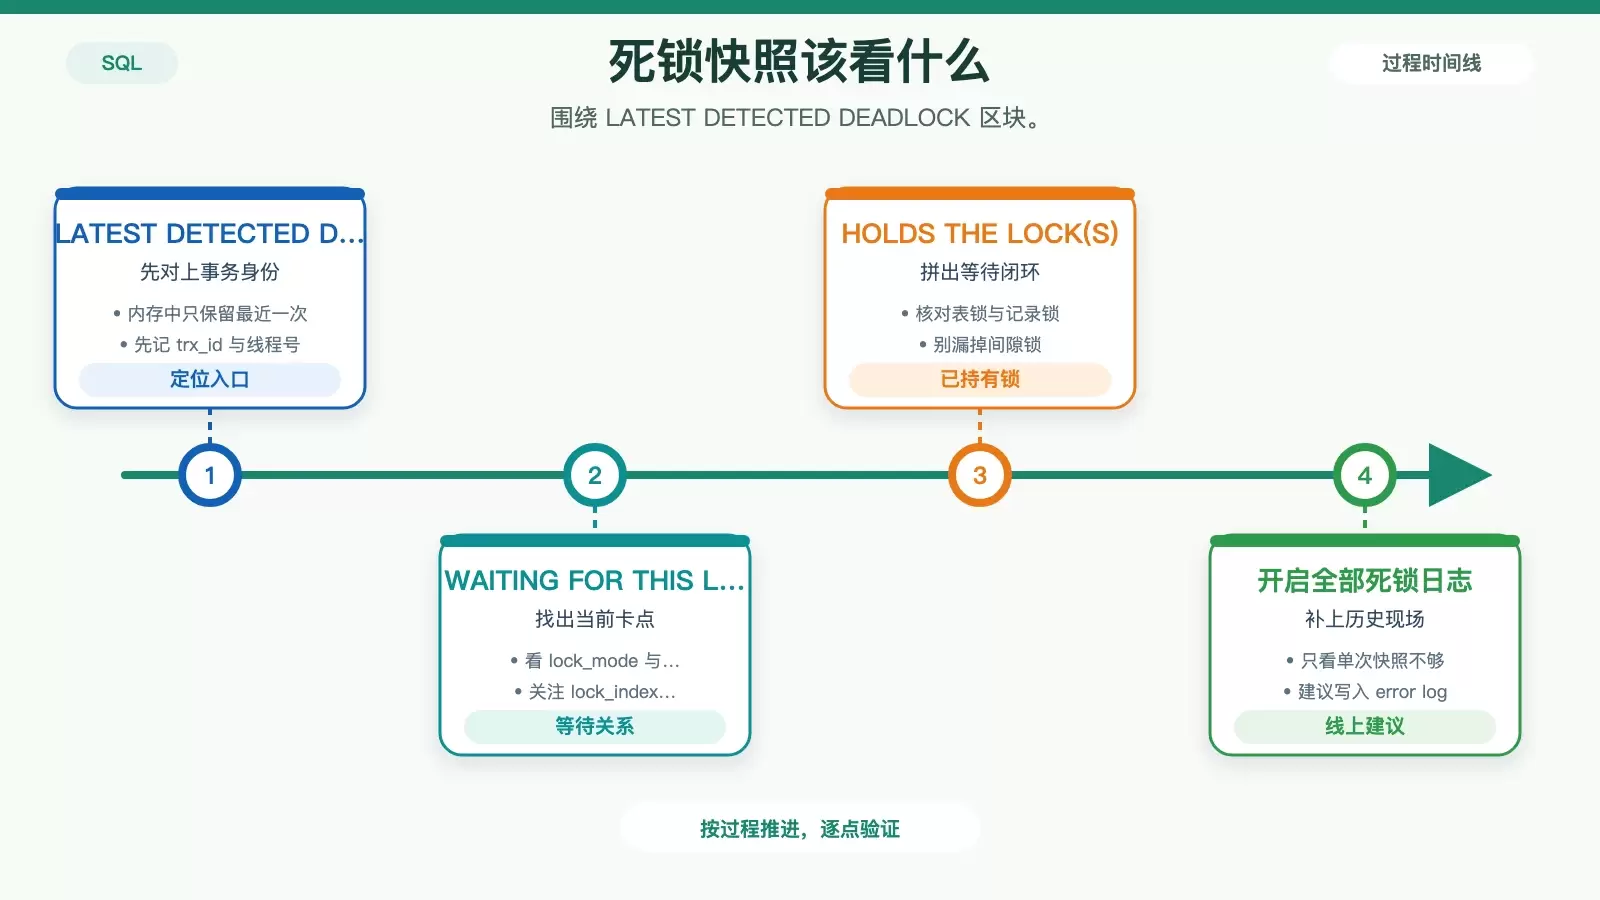
排查 SQL UPDATE 死锁,关键不是盯住报错语句本身,而是先还原两边事务的真实加锁链路。本文从 InnoDB 死锁快照、执行计划校验、间隙锁陷阱和批量更新策略四个方面,给出线上常用的定位入口与改写思路。
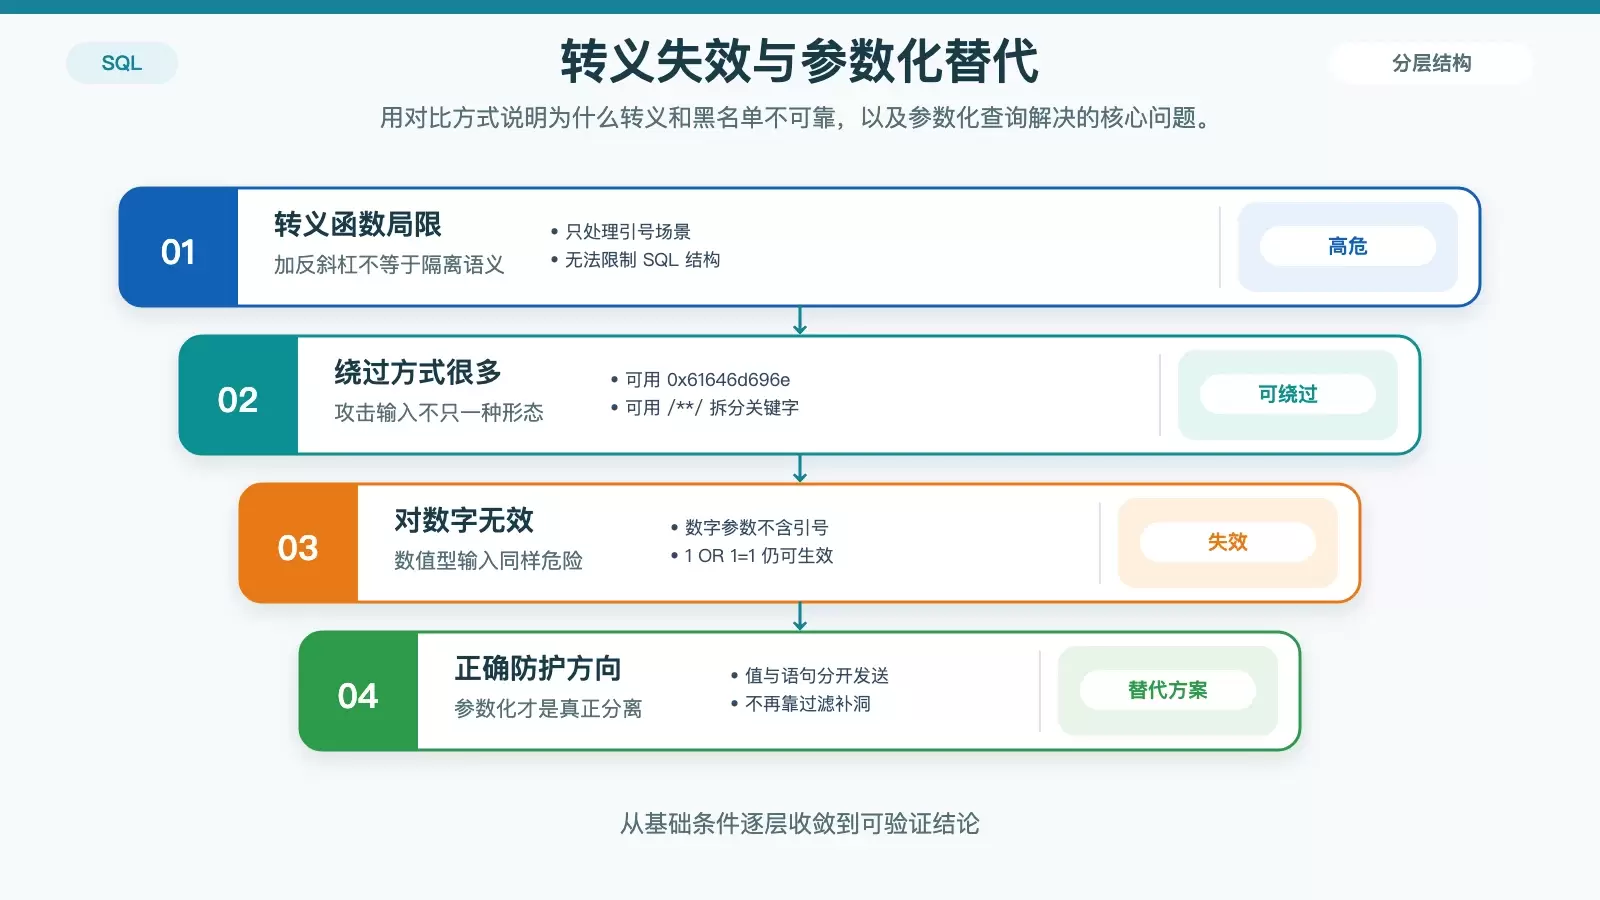
避免 SQL 注入,关键不在转义技巧,而在彻底停止把用户输入拼进语句。文章从转义函数失效原因讲起,说明 PHP 与 Python 中参数化查询的正确姿势,并给出动态表名、列名和排序字段的白名单处理办法。
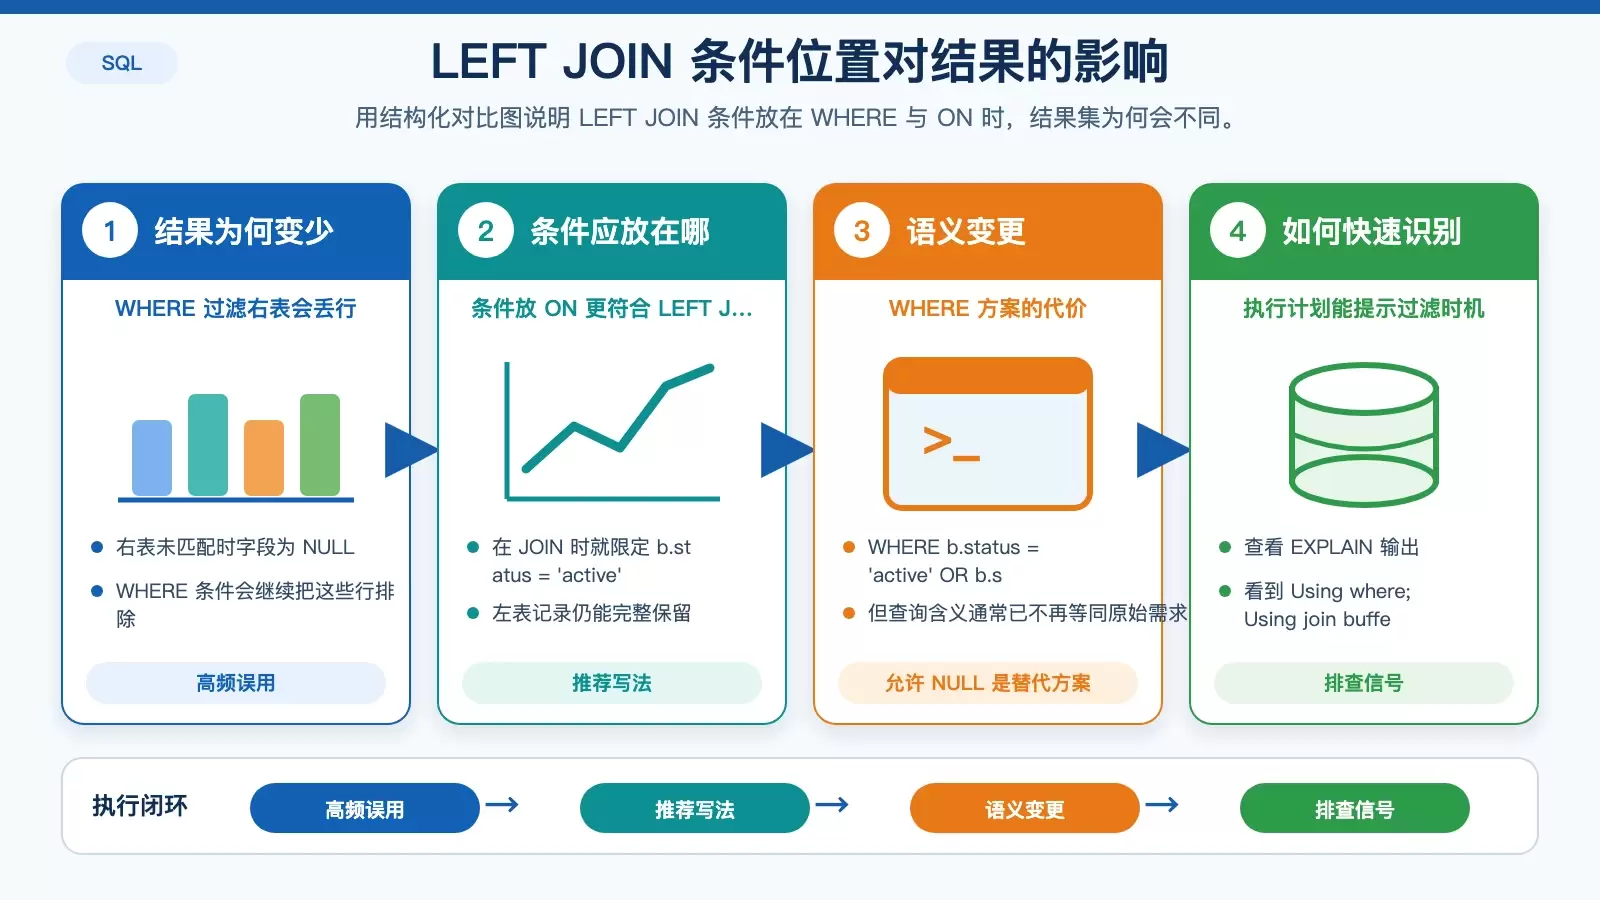
SQL 的 SELECT 查不出结果,很多时候不是数据没了,而是查询条件把目标行悄悄排除了。本文围绕 MySQL 中最常见的 4 类原因展开:NULL 比较、LEFT JOIN 过滤、隐形字符以及字段名与别名误用,并给出可直接套用的排查写法。
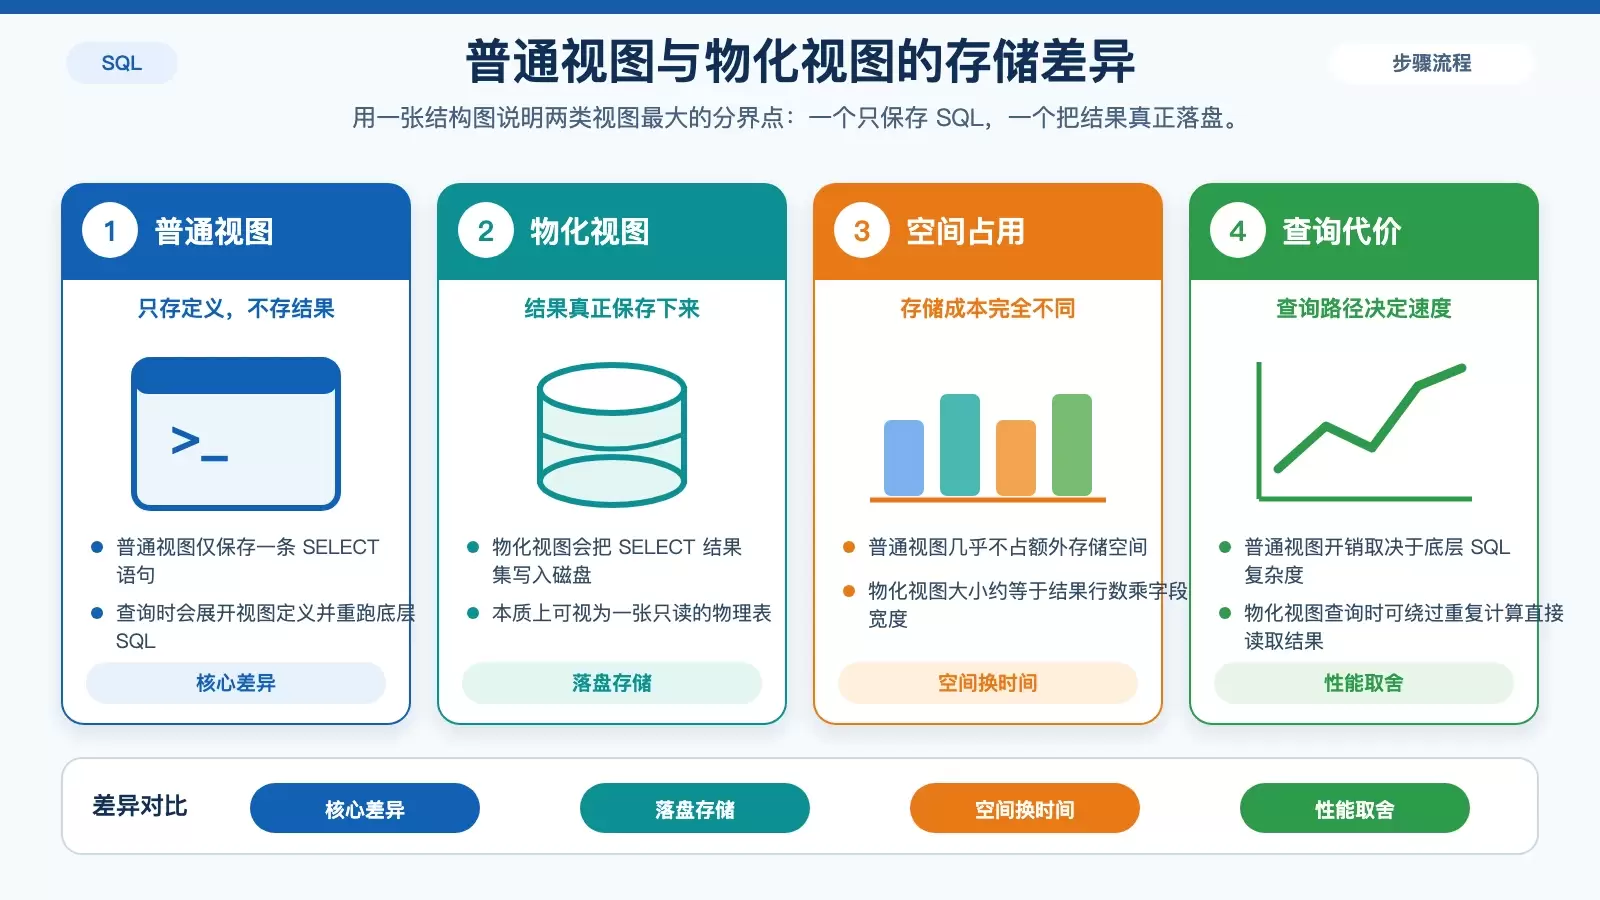
物化视图和普通视图最核心的差别,不在语法,而在“结果是否落盘”。前者拿空间换性能、靠刷新维持数据新鲜度;后者零存储成本,但每次查询都要重跑底层 SQL。理解这几点,基本就能判断两者各自适合什么场景。
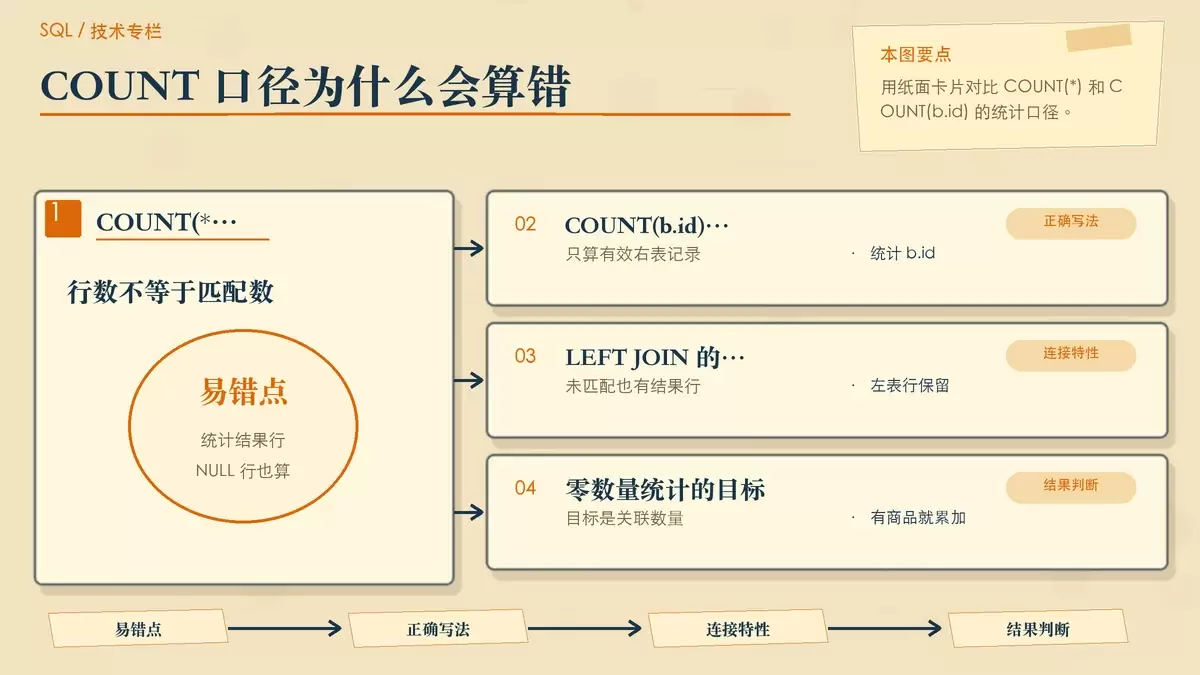
用 LEFT JOIN 做“零数量统计”时,最常见的坑有三个:把 COUNT(*) 当作关联记录数、GROUP BY 写错分组键、以及把左表过滤条件误塞进 ON 子句。本文用订单与商品示例拆开说明这些问题,并给出在 MySQL、PostgreSQL 等数据库里更稳妥的写法与性能判断依据。
向 SQL 视图执行 INSERT 时,报错通常不是权限配置偶发失误,而是数据库在语义层面认定该视图不可更新。本文梳理常见报错、哪些定义会让视图失去可插入能力,以及单表视图仍失败的几个细节,最后说明 INSTEAD OF 触发器能做什么、又不能替代什么。
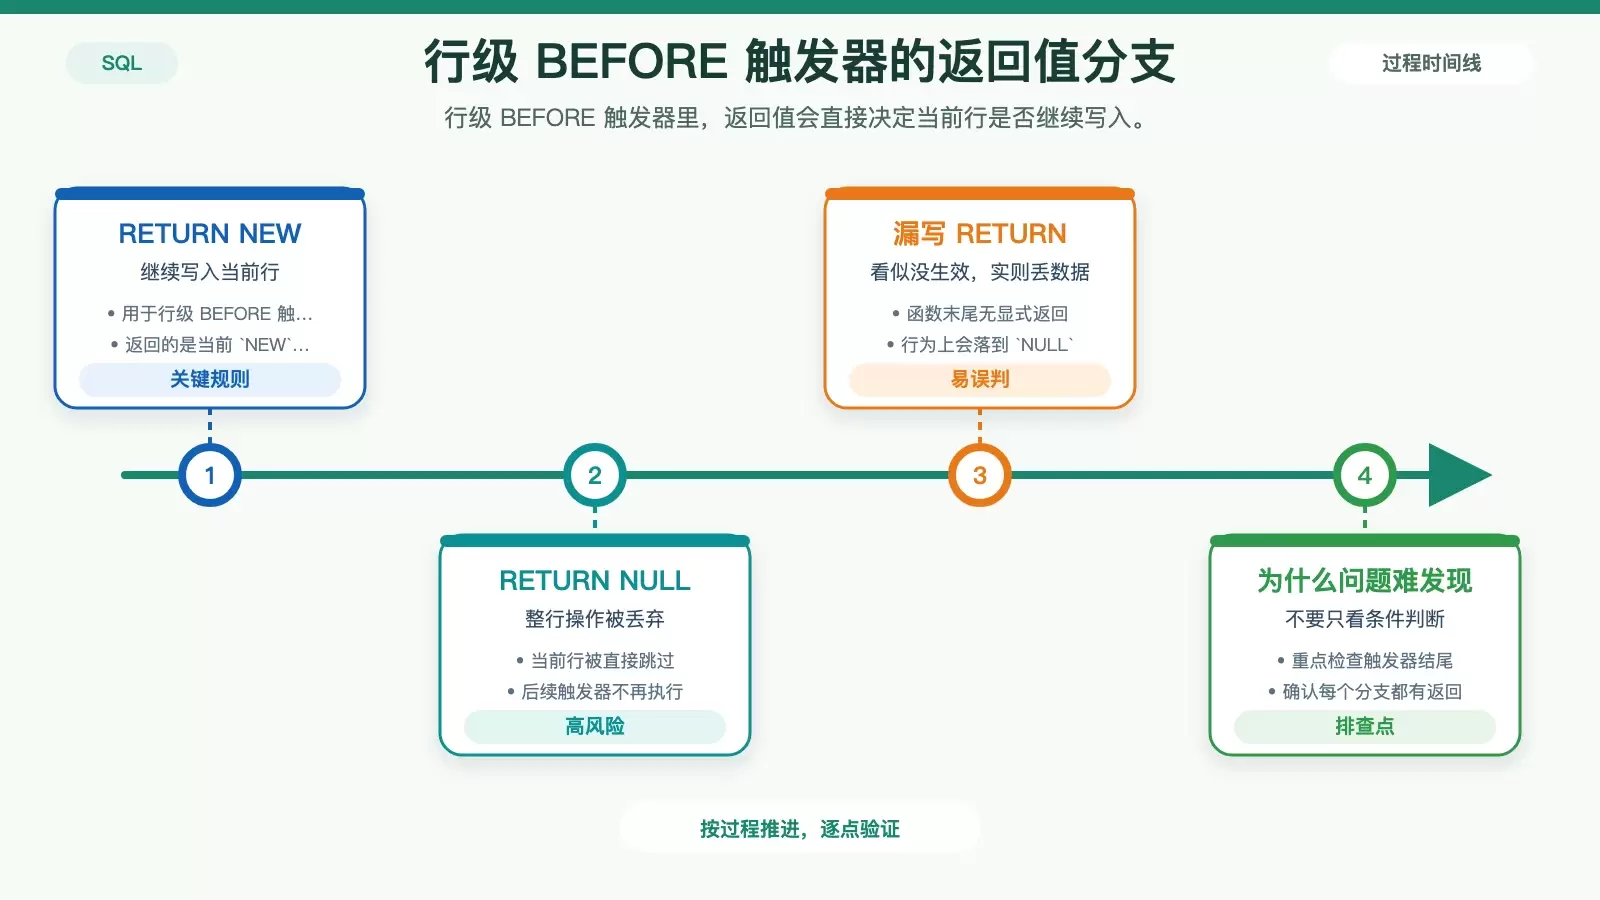
在 PostgreSQL 15 里,SQL 触发器函数的返回值不是形式问题,而是直接决定数据是否继续写入。本文按行级、语句级、`TRUNCATE` 与 `INSTEAD OF` 几类场景,梳理 `RETURN NEW`、`RETURN NULL` 的实际含义、常见报错和最容易被忽略的静默丢行风险。 写 PostgreSQL 15 触发器时,很多“数据没进去”并不是 SQL 本身的问题,而是触发器函数最后一行返回值写错了。
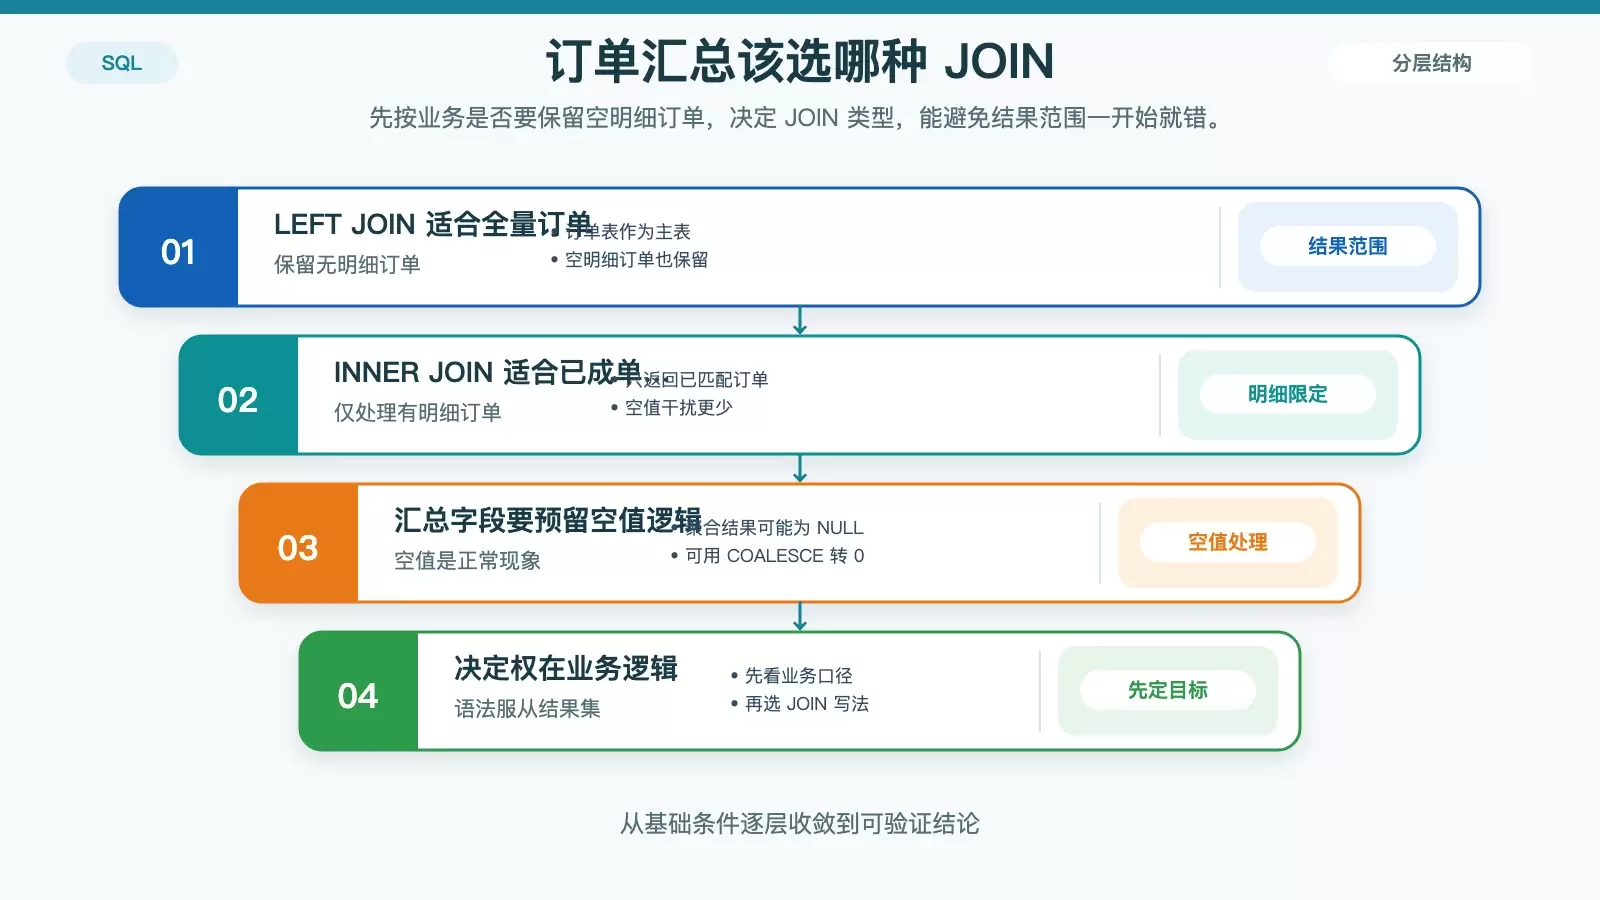
订单表和明细表做汇总时,难点通常不在 `SUM()` 本身,而在 JOIN 选择、`GROUP BY` 写法、重复关联放大和索引是否到位。本文按订单汇总的常见问题拆解,给出可直接落地的判断方式、排查 SQL 与性能优化重点。
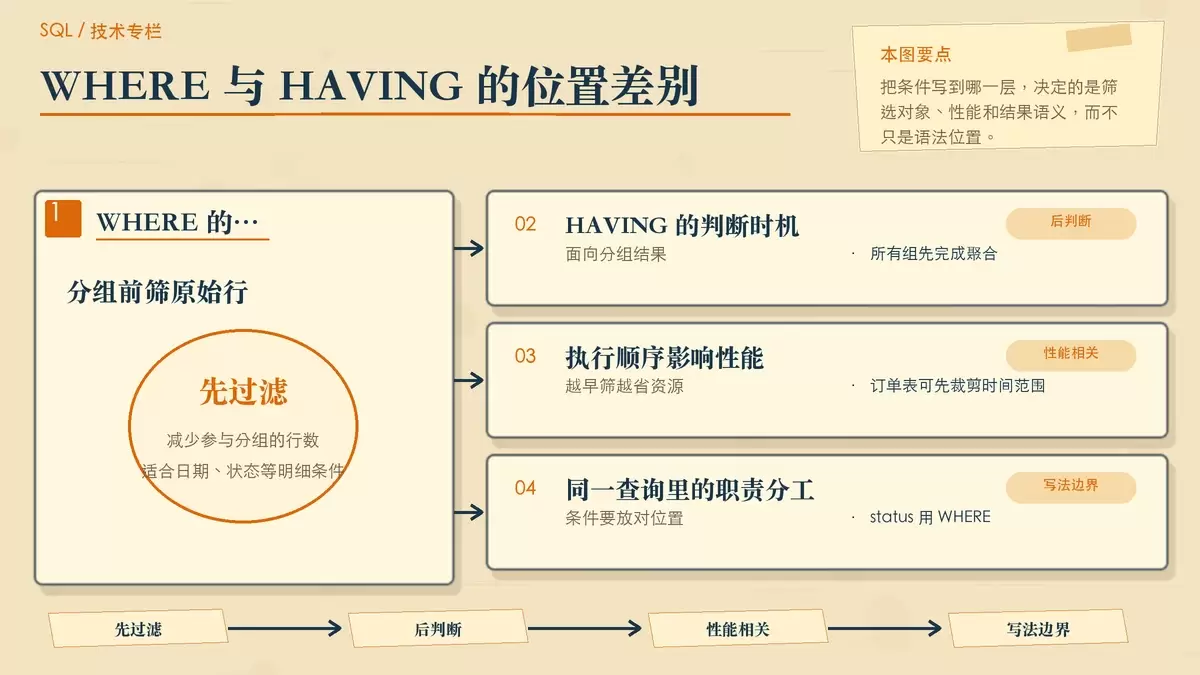
在 SQL 里,`WHERE` 和 `HAVING` 都能“筛选”,但作用阶段完全不同:一个面向原始行,一个面向聚合后的分组结果。本文结合 MySQL 5.7+ 的 `ONLY_FULL_GROUP_BY` 规则、常见报错和 `NULL` 场景,梳理 `GROUP BY` 后筛选结果时最容易写错的边界。 写分组统计时,最容易混淆的不是聚合函数本身,而是条件到底该放在 WHERE 还是 HAVING 。
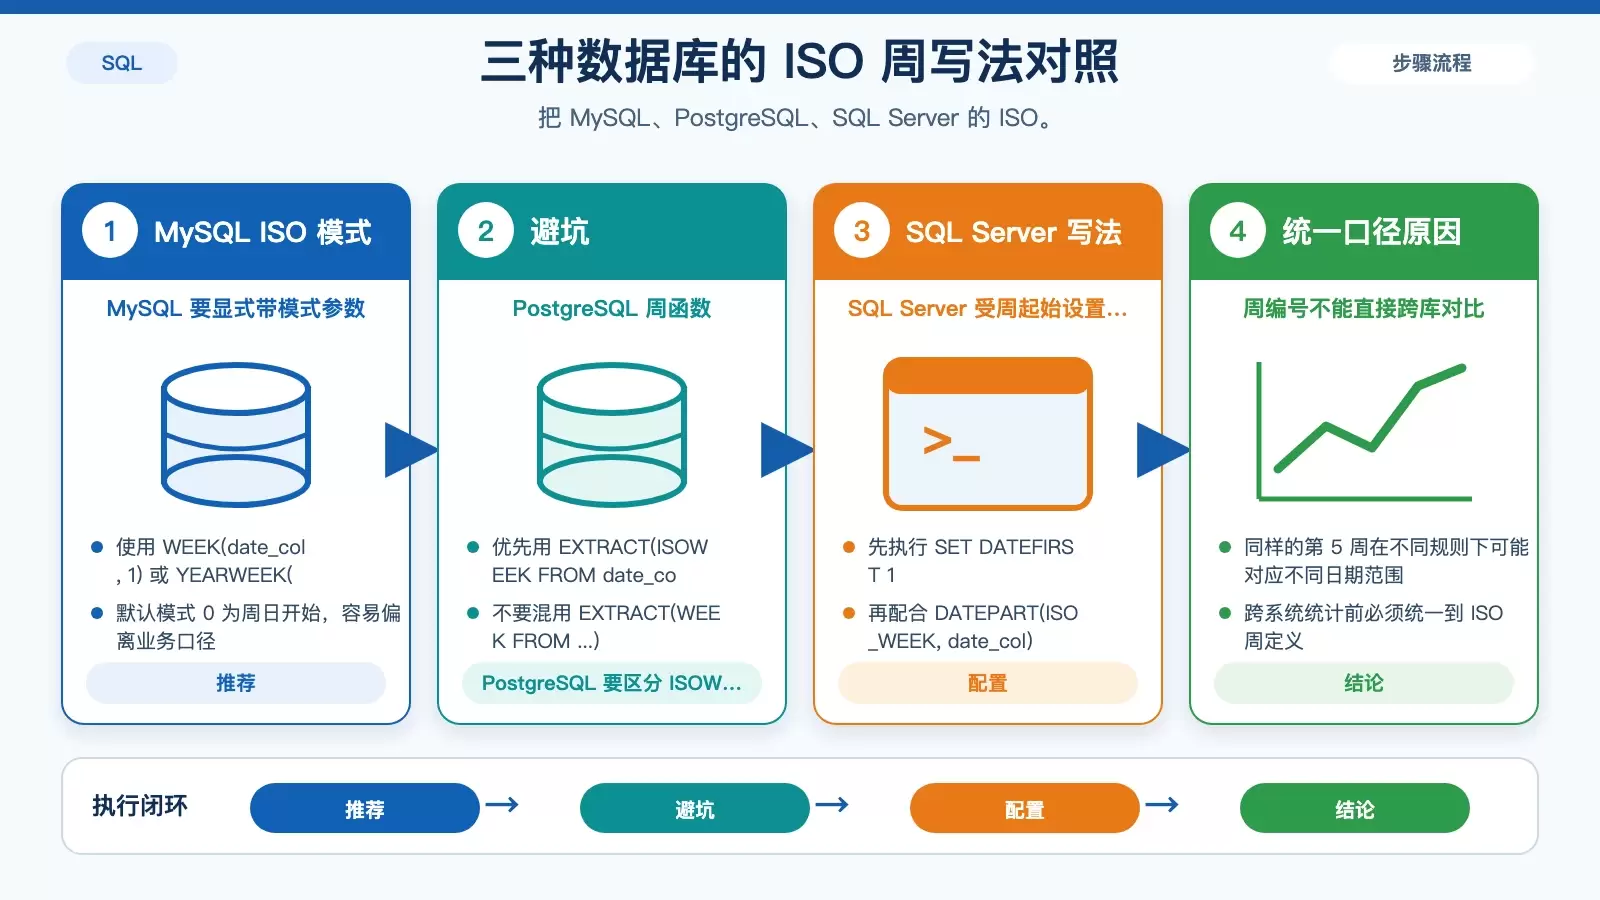
统计“每周新增用户”时,真正容易出错的不是 SQL 语法,而是周定义、首活口径和跨年分组。本文按 MySQL、PostgreSQL、SQL Server 分别说明 ISO 周写法,并给出新增用户统计、跨年周处理与索引优化的实操要点。 很多人写“每周新增用户”统计时,都会直接对时间字段套上 WEEK() ,但这一步很可能已经把结果做偏了。