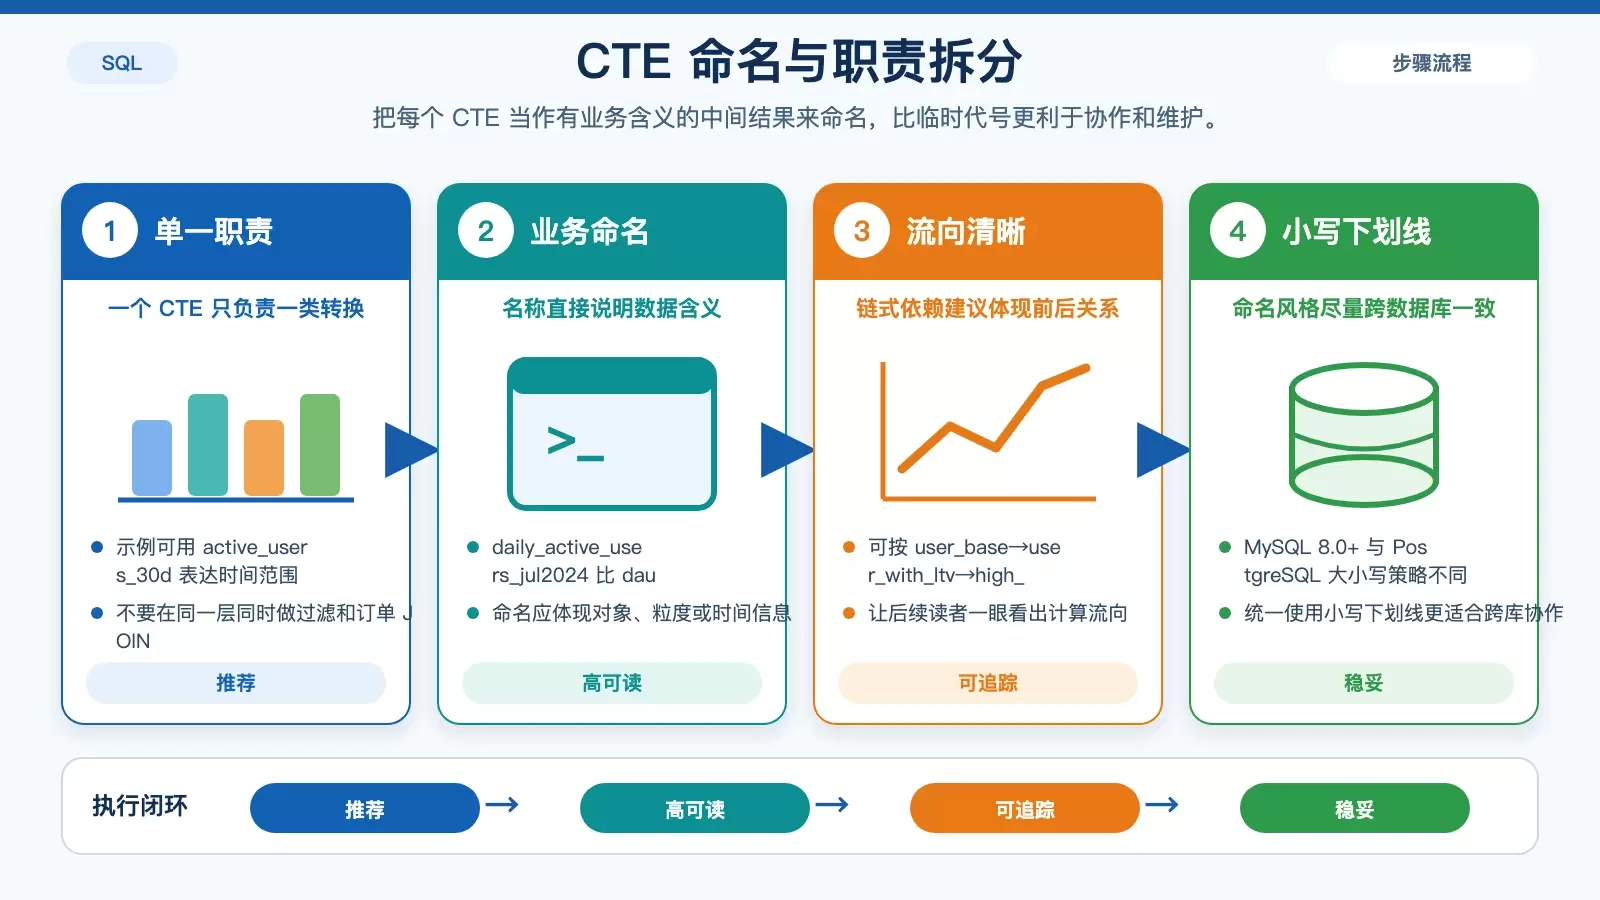
如何用 SQL WITH 语句把复杂查询写得更清楚
SQL 的 `WITH` 子句不只是把长查询拆成多行,更适合承担“分步命名、逐层计算”的职责。本文围绕命名、定义顺序、显式列名与递归使用边界,整理出一套更利于协作和维护的 CTE 写法。 很多人把 SQL 的 WITH 当作“把长查询拆开写”的语法糖,但真正决定可维护性的,往往是每个 CTE 的职责是否单一、命名是否直观、引用顺序是否可。
2026-08-23
75

SQL 的 `WITH` 子句不只是把长查询拆成多行,更适合承担“分步命名、逐层计算”的职责。本文围绕命名、定义顺序、显式列名与递归使用边界,整理出一套更利于协作和维护的 CTE 写法。 很多人把 SQL 的 WITH 当作“把长查询拆开写”的语法糖,但真正决定可维护性的,往往是每个 CTE 的职责是否单一、命名是否直观、引用顺序是否可。
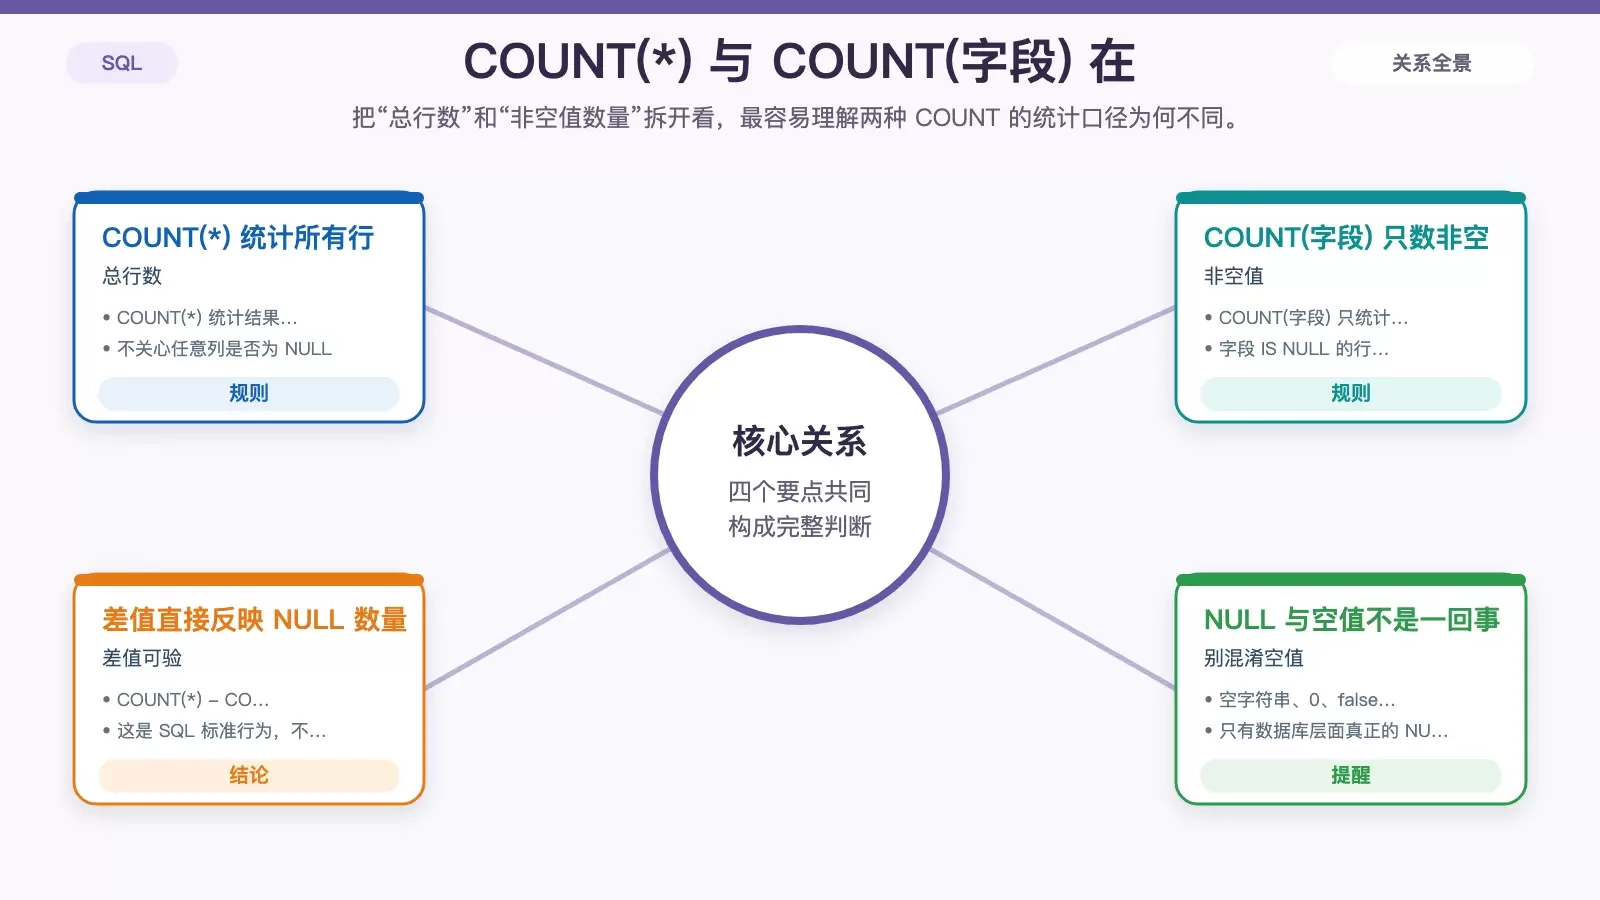
`COUNT(*)` 统计结果集中的全部行,`COUNT(字段)` 只统计该字段非 `NULL` 的行,因此前者一定大于等于后者。真正容易出错的地方不在函数名字,而在 `LEFT JOIN`、`WHERE`、`GROUP BY` 改写结果集后,很多人把“当前结果集计数”误当成“原表行数”。
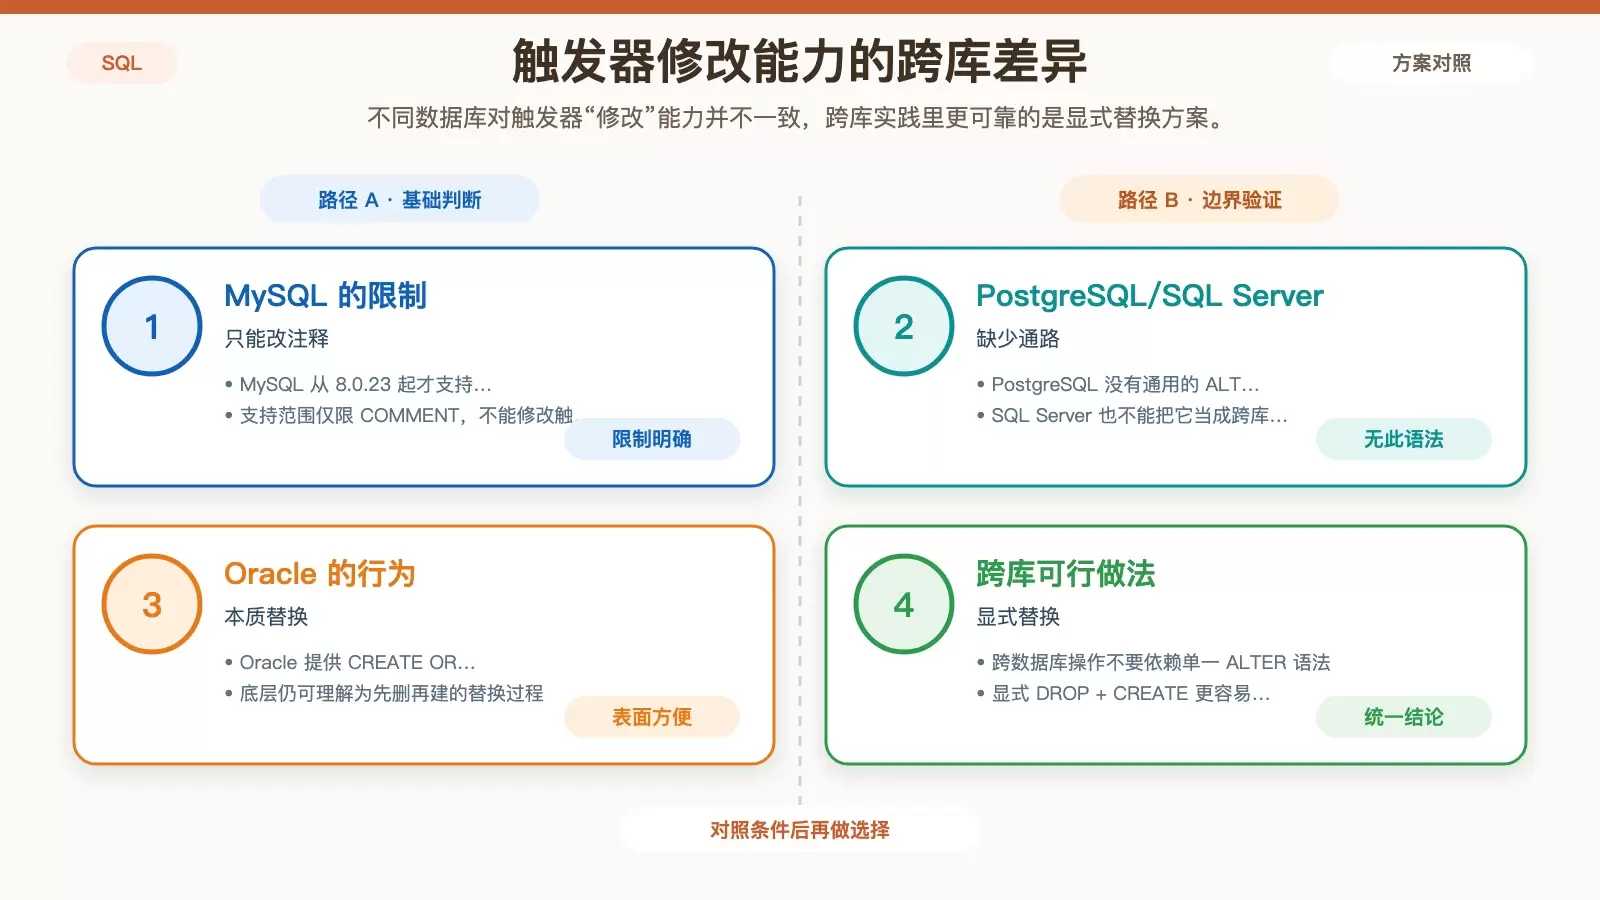
跨数据库环境里,触发器几乎都不能直接“原地修改”。想在不停机前提下更新逻辑,可靠办法是把它当成一次受控的原子替换:先确认原定义,再在合适的会话和并发条件下执行 `DROP + CREATE`,最后用行为验证确认新逻辑已生效。
Sequelize 的模型方法确实会自动做参数绑定,但这只覆盖“值”,并不覆盖列名、表名、排序字段这类 SQL 结构位。本文把几种最容易误判的场景拆开讲清:模型方法何时安全、`sequelize.query()` 为什么必须配合 `replacements`、`literal()` 与 `fn()` 为什么会绕过防护,以及动态字段该怎样用白名单收口。
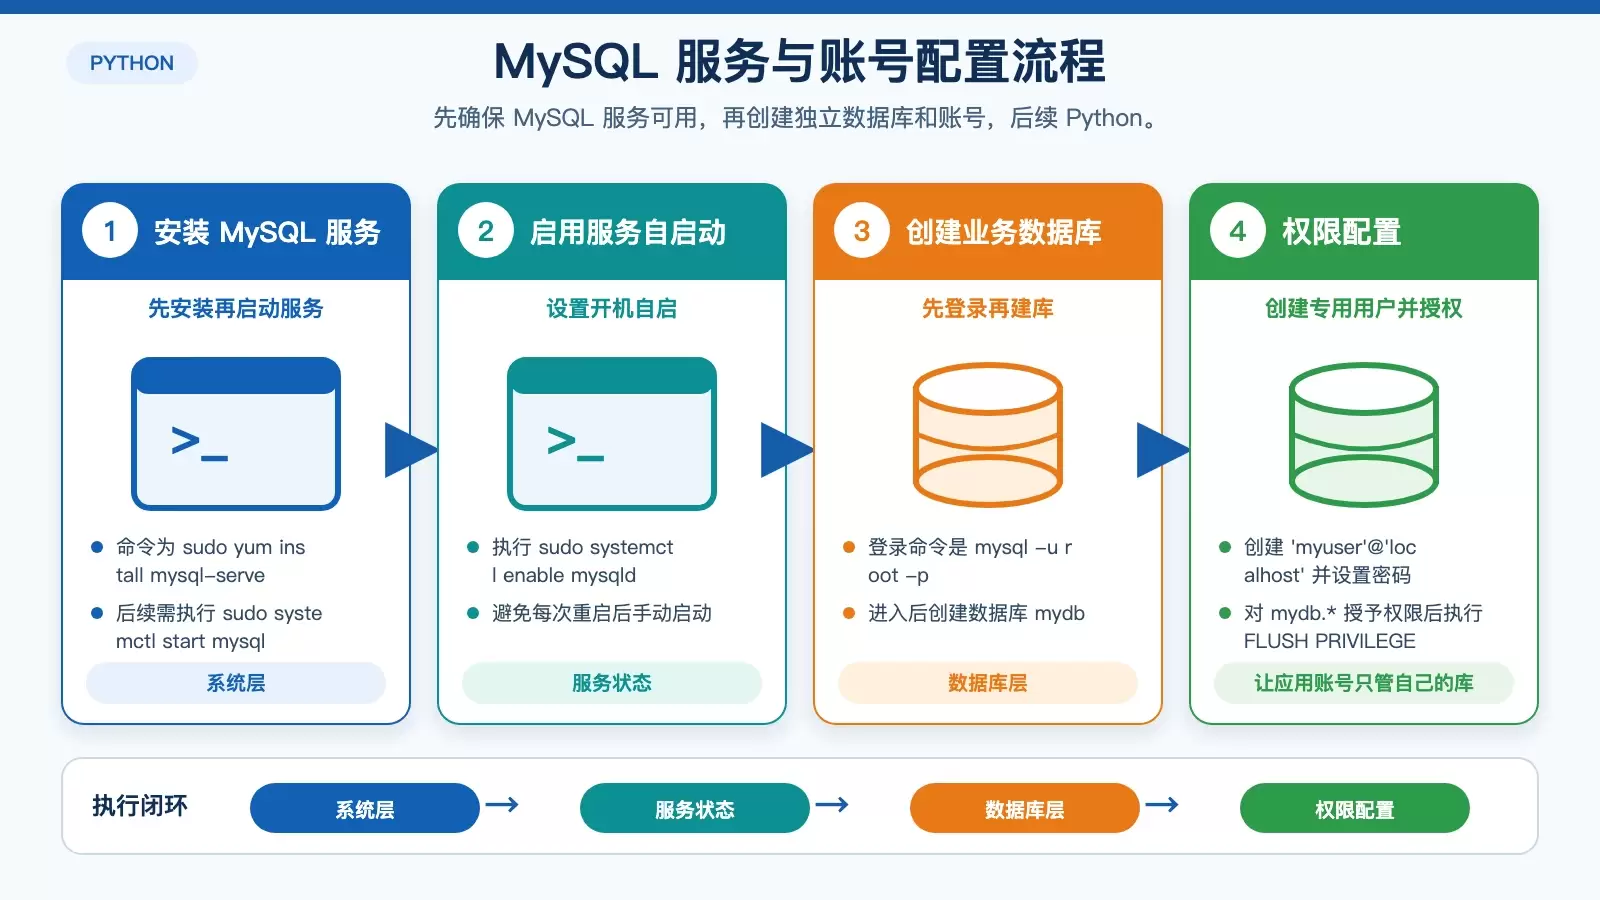
这篇文章用 MySQL 为例,梳理了在 CentOS 中让 Python 成功连上数据库的基础流程:安装服务、创建专用库和用户、安装驱动、编写测试脚本并排查常见报错。适合本地开发或测试环境快速搭建。 在 CentOS 上配置 Python 连接数据库,真正容易卡住的往往不是代码本身,而是服务状态、账号权限和连接参数没有对齐。
用户能查 SQL 视图却查不了原表,并不是权限漏配,而是数据库把“视图”和“基表”当成两类独立对象分别校验。本文结合 MySQL、SQL Server 与 PostgreSQL 的典型报错,说明权限为何不会自动继承,以及在 MySQL 中如何真正实现“只开放视图、不开放原表”。
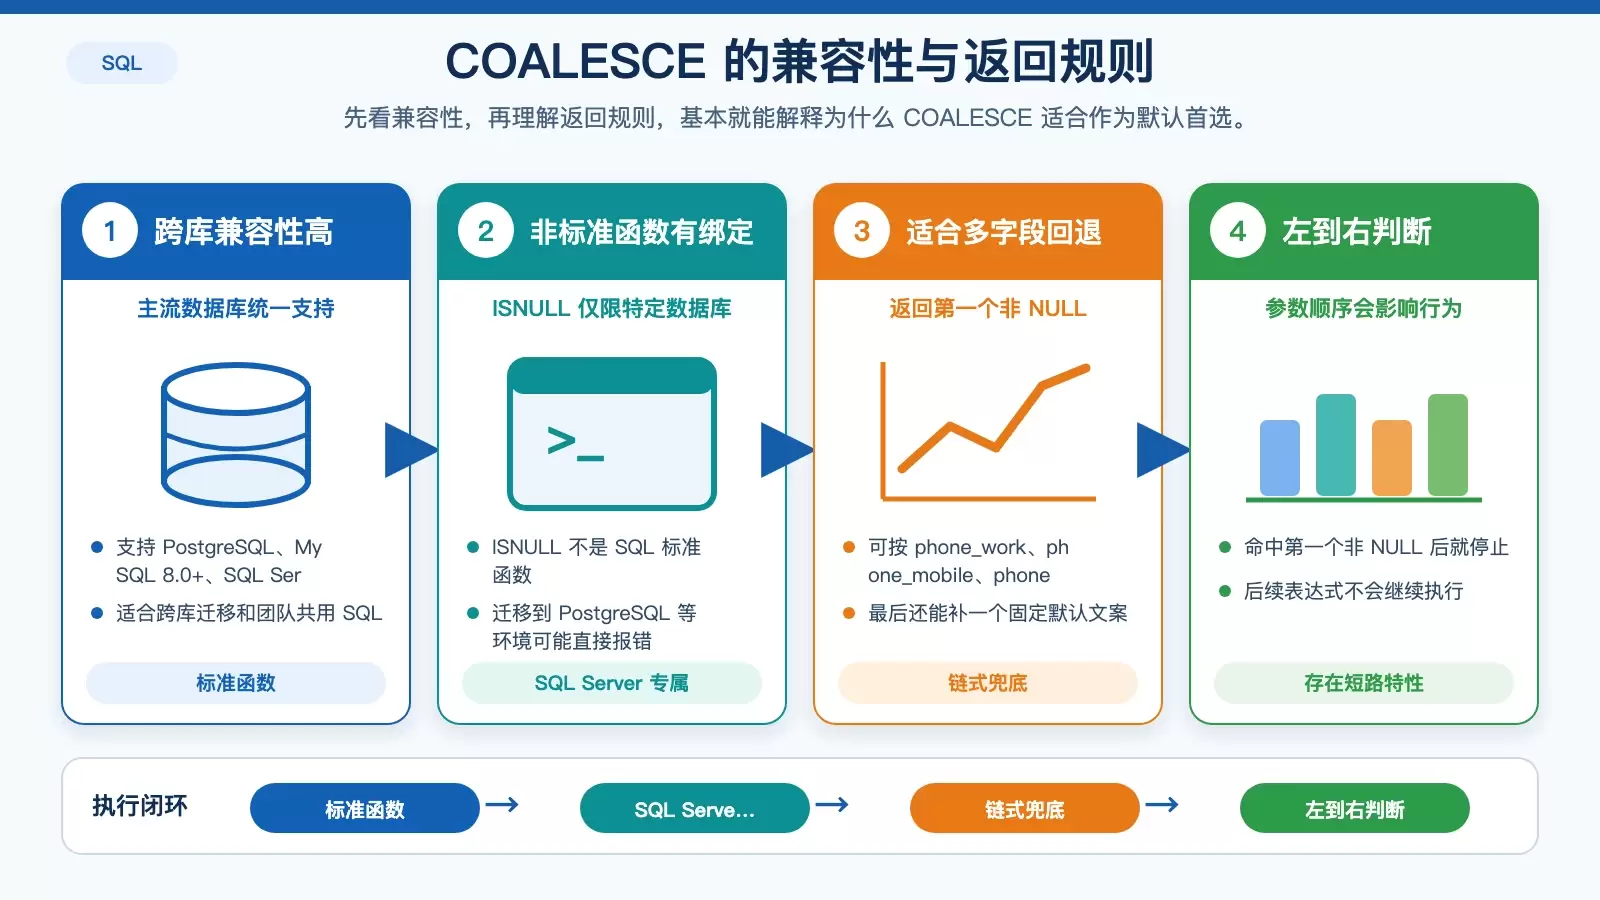
COALESCE 是处理 NULL 的常用函数,但真正写进生产 SQL 时,兼容性、类型推导和索引命中往往比语法本身更关键。本文从跨库支持、类型陷阱、WHERE/JOIN 性能影响到 CASE 的替代场景,整理一套更稳妥的使用方法。
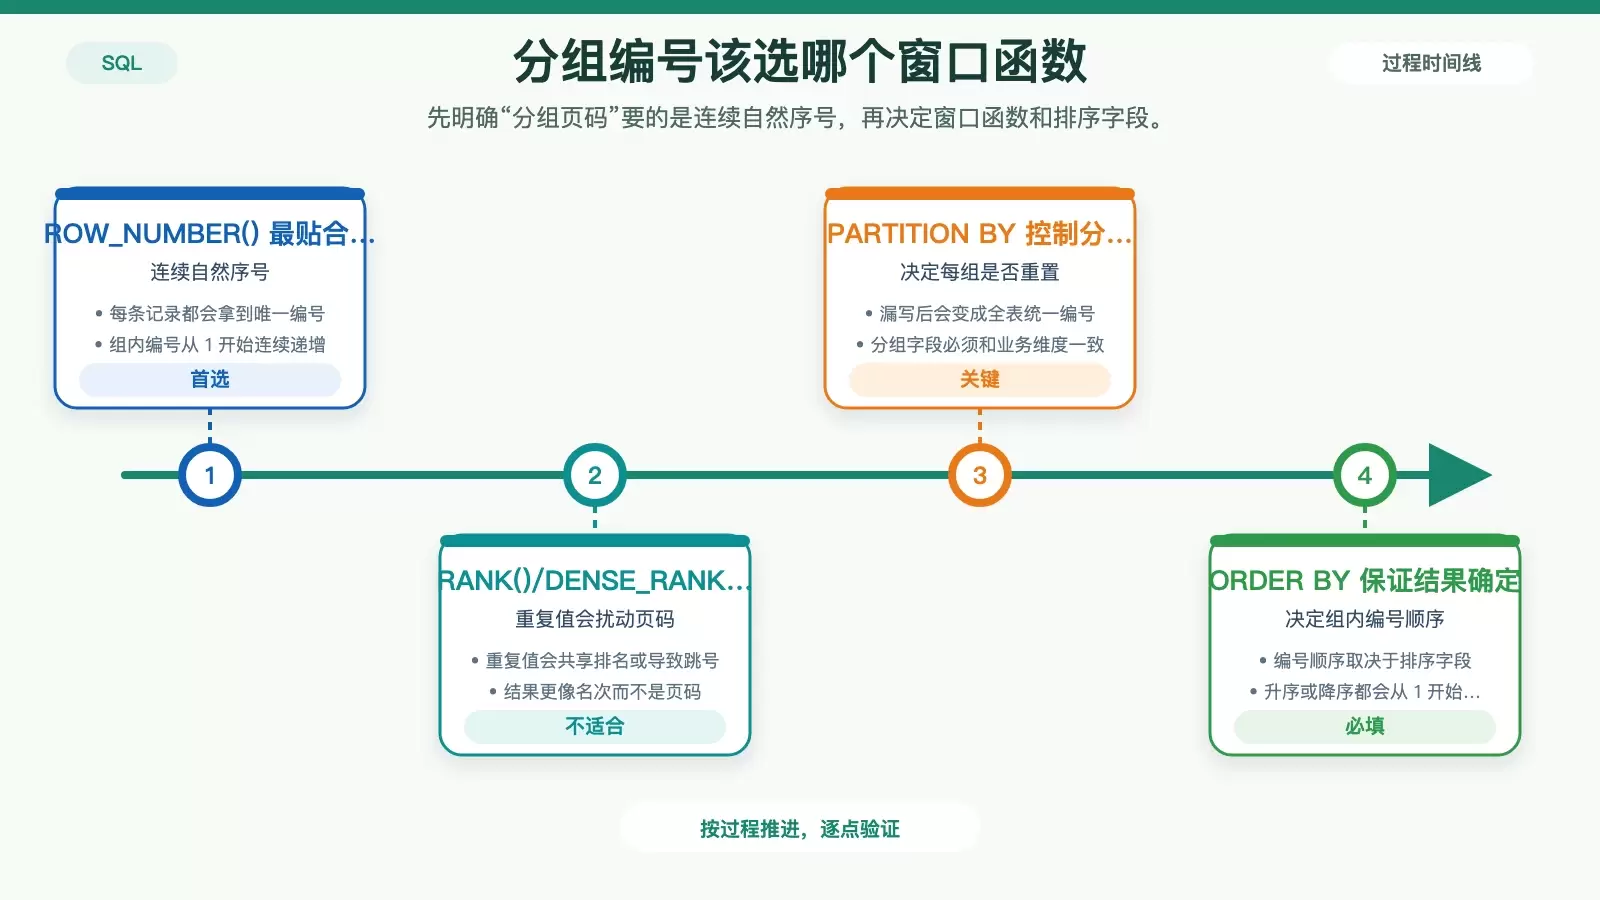
用 SQL 生成“按组分页”的页码,关键不是选哪个排名函数,而是先用 `ROW_NUMBER()` 在组内生成连续行号,再把行号换算成页码。本文整理了常见误区、跨数据库差异,以及什么时候该用窗口函数、什么时候该直接用 `OFFSET`/`LIMIT`。
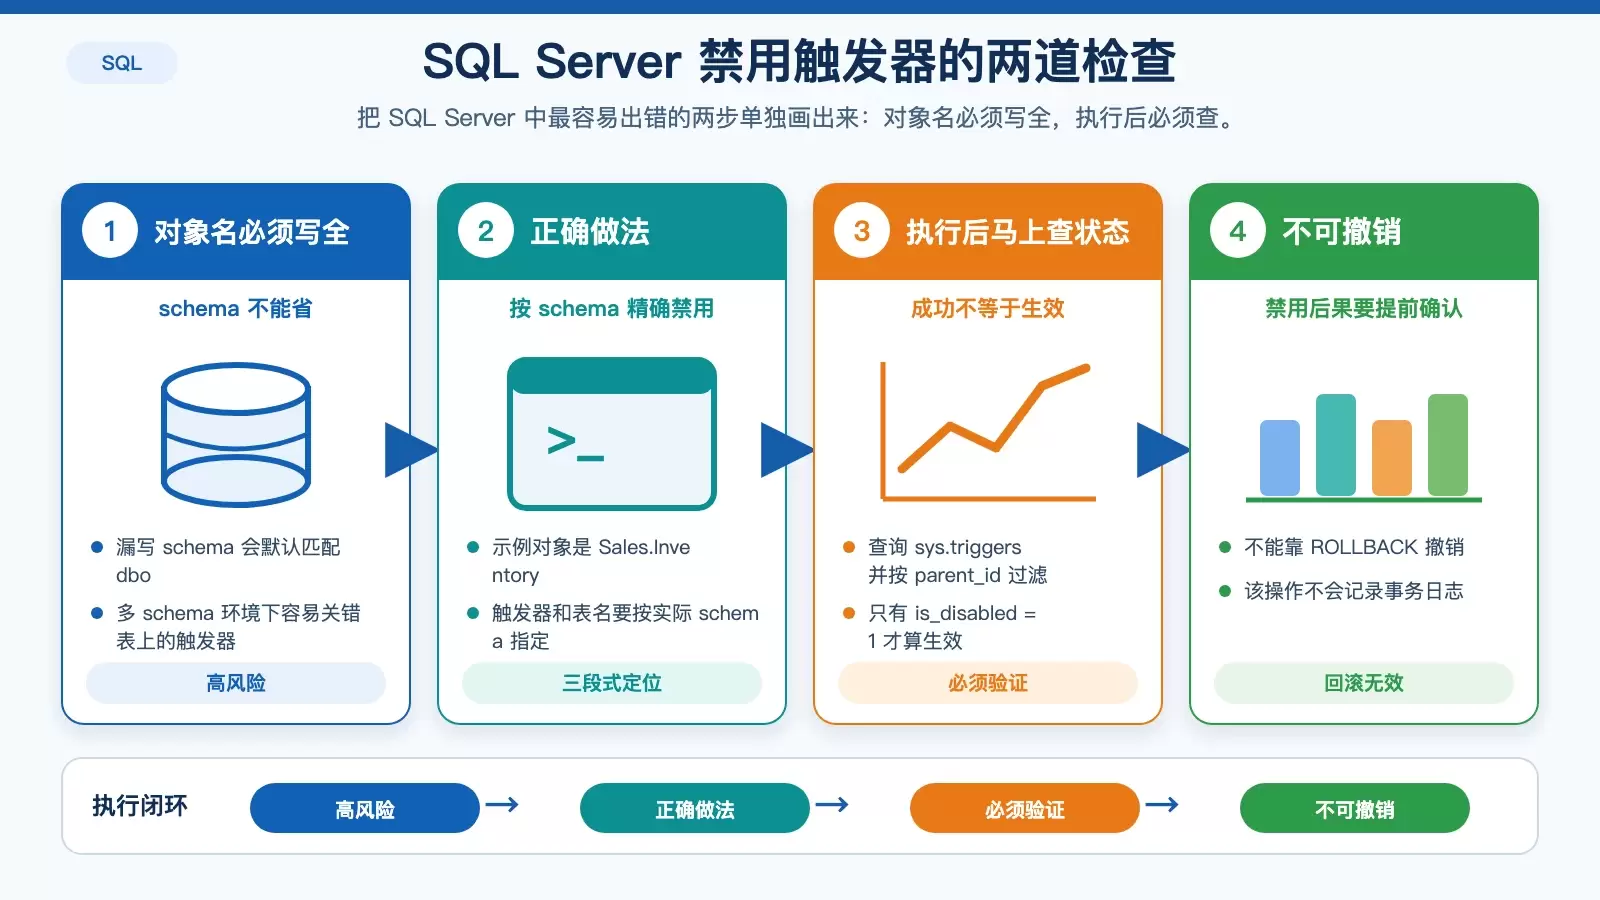
临时关闭触发器做数据修复,风险往往不在语法本身,而在误关对象、会话范围和修复后的验证。本文按 SQL Server、MySQL、PostgreSQL 三类场景梳理可执行写法、限制条件与恢复检查点,帮助你判断哪些做法能在生产环境真正落地。
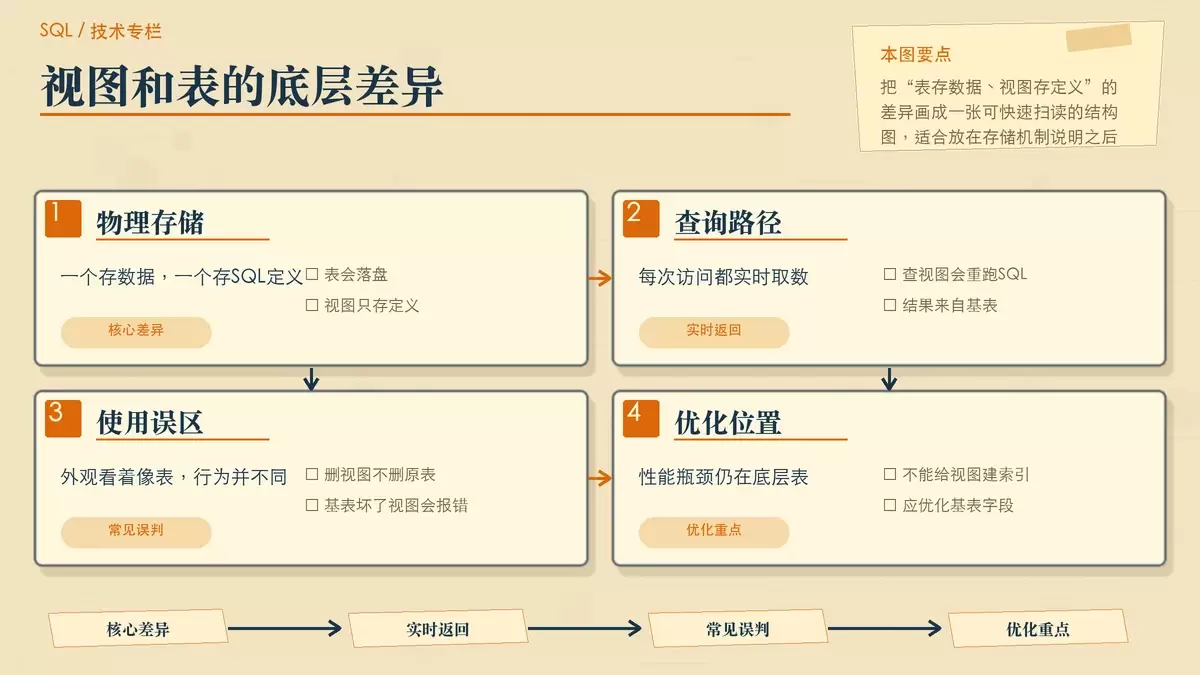
视图和普通表在查询结果上看似相同,但底层职责完全不同:表负责真实存储,视图只保存查询定义。理解两者在存储、写入限制、权限隔离和性能上的差异,才能判断该用表落地数据,还是用视图做封装与接口层。
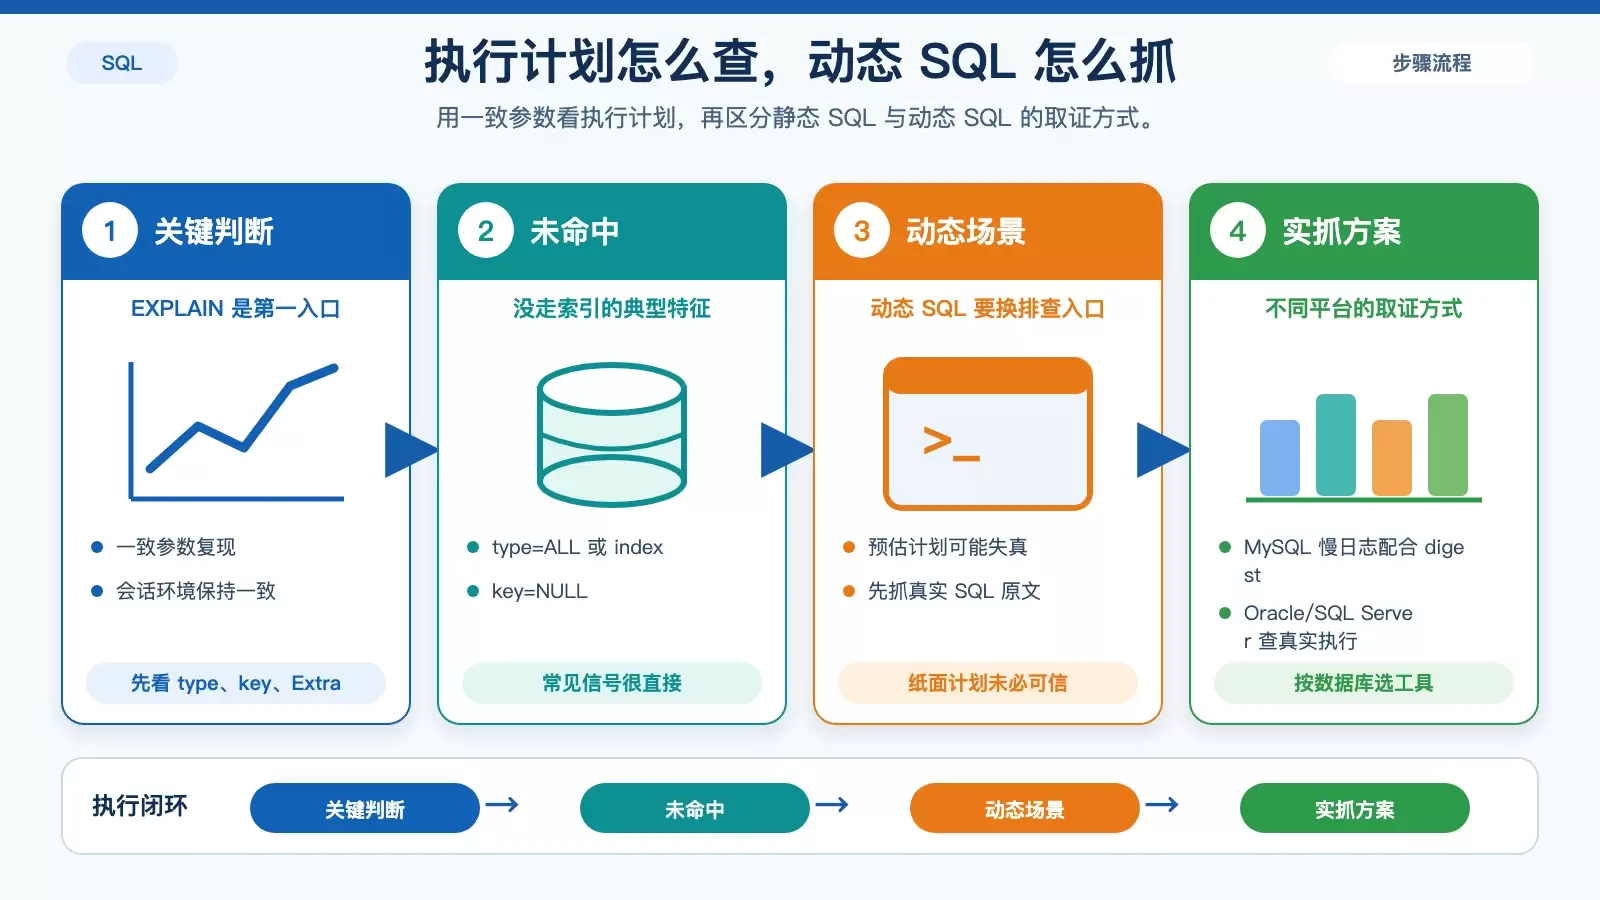
存储过程是否走索引,关键不在“过程”本身,而在其中具体 SQL 被优化器怎样执行。判断时要先用一致参数和会话环境复现,再重点排查隐式转换、复合索引顺序、动态 SQL 与统计信息失真这些高频原因。
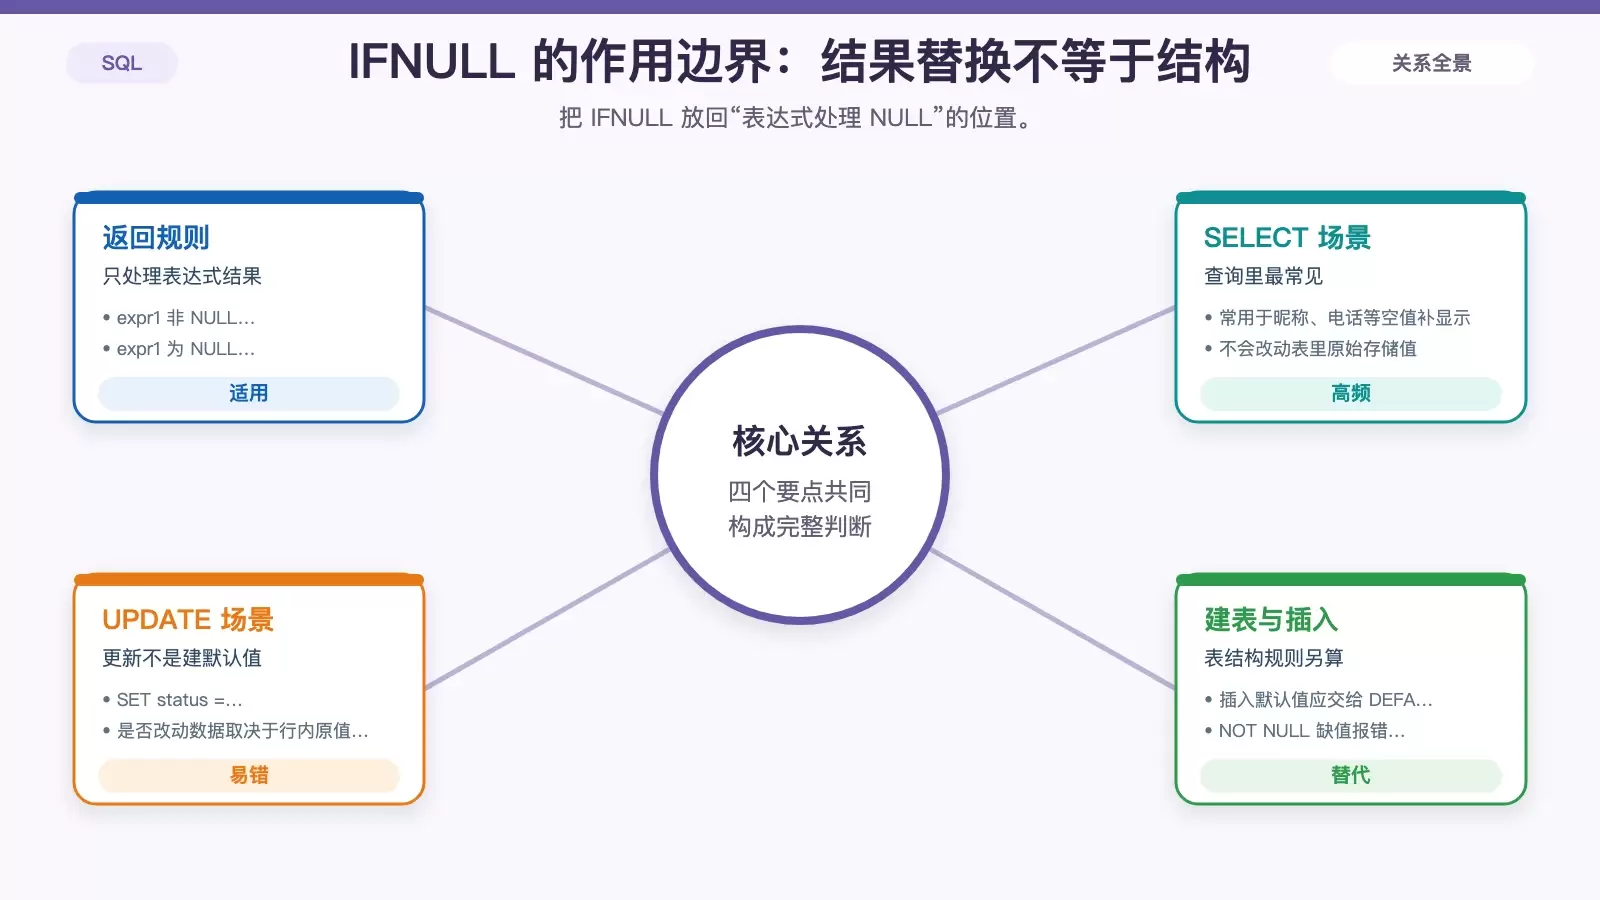
IFNULL 是 MySQL 里处理 NULL 的常用函数,但它只改表达式结果,不会替你补写表里的真实数据。本文按 SELECT、UPDATE 和跨库兼容三个场景梳理它的正确用法、常见误区,以及何时该改用 COALESCE、DEFAULT 或约束。 很多教程会把 IFNULL() 说成“给字段设默认值”,但这句话只说对了一半:它能处理查询或表达式里的 NULL ,却不等于真正的表字段默认值。