


把查询结果直接灌进另一张表,是 SQL 里很常见的一类操作,迁移数据、汇总结果、批量落库都会用到。问题在于,INSERT INTO ... SELECT 看起来简单,真正出错时往往不是语法本身,而是列对应关系、数据库方言差异、并发锁行为,或者子查询结果与目标表约束不一致。
这篇文章就围绕这几个最容易误判的点展开:先说明为什么应该用 INSERT INTO ... SELECT,再看 MySQL、PostgreSQL、SQL Server、Oracle 的细节差异,最后补上性能和排错判断。看完之后,你可以快速判断一条语句是“能执行”,还是“适合在线上执行”。
为什么插入子查询结果要用 INSERT INTO ... SELECT
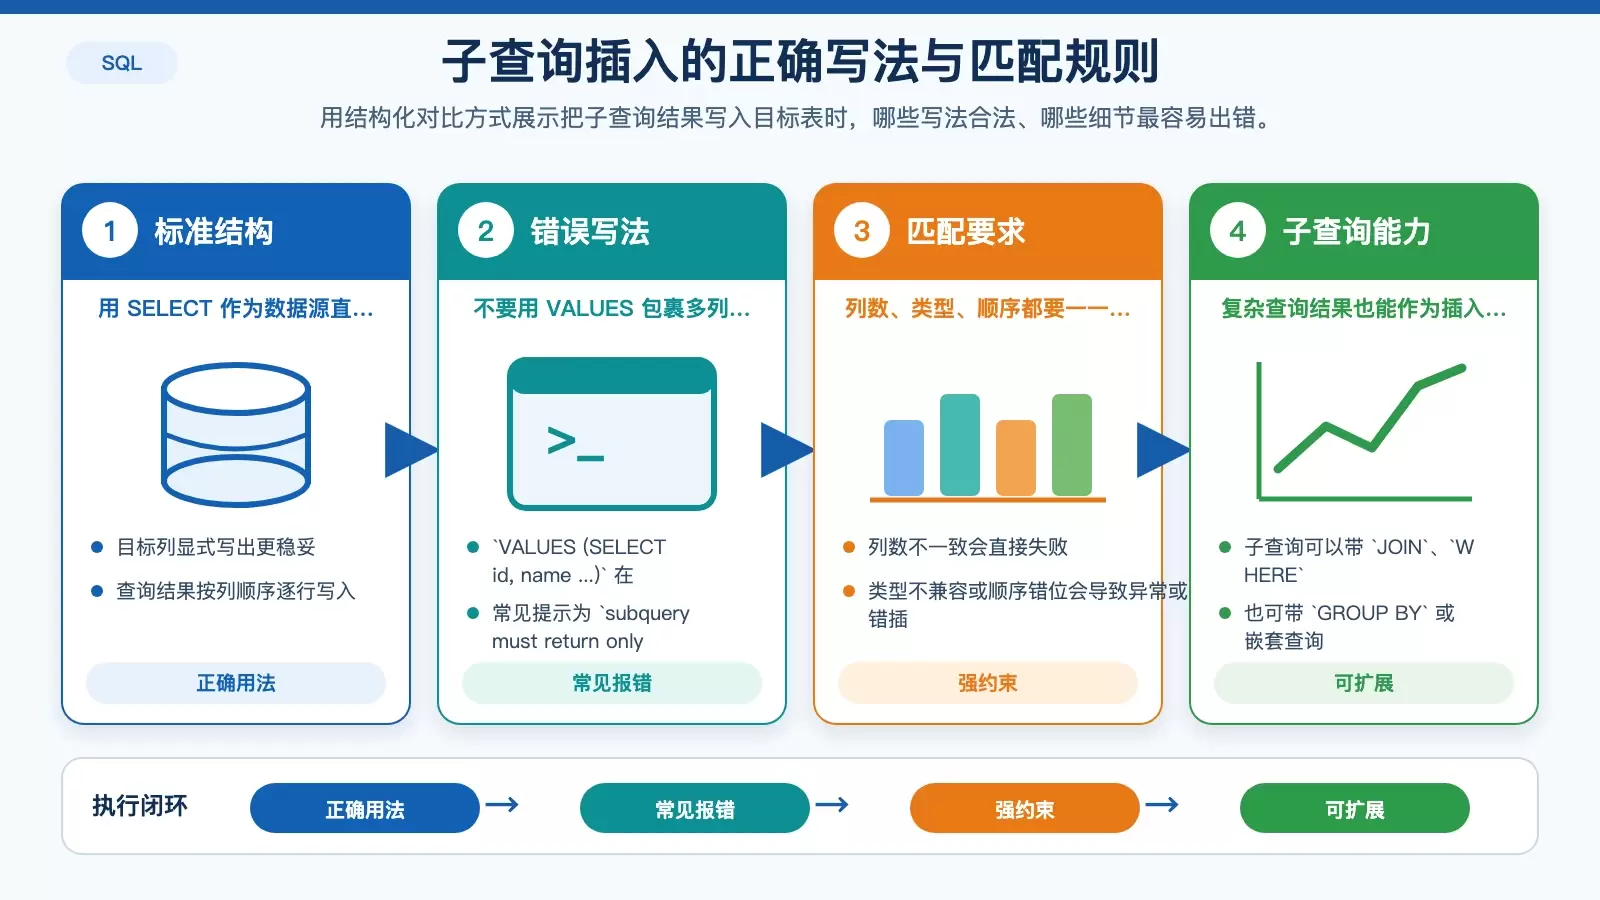
把子查询结果插入目标表,最常用也最直接的方法,就是使用 INSERT INTO ... SELECT。它会把查询结果当作数据源,再按结果集逐行写入目标表。
标准写法如下:
INSERT INTO target_table (col1, col2)
SELECT col_a, col_b
FROM source_table
WHERE ...
这里有一个常见误区:不能用 VALUES 去包裹一个多列子查询。下面这种写法在 PostgreSQL、MySQL、SQL Server 等主流 SQL 引擎里都属于非法写法:
INSERT INTO users VALUES (SELECT id, name FROM temp_users)
这类语句通常会报出类似 ERROR: subquery must return only one column 的错误,本质原因不是子查询不能用,而是 VALUES 语法不接受这种多列结果集作为整行数据源。
列数、类型、顺序为什么必须严格匹配
INSERT INTO ... SELECT 是否能稳定执行,关键在于目标列与查询结果之间的对应关系。要特别注意三件事:
- 列数必须一致。
- 类型必须兼容,最好不要依赖模糊的隐式转换。
- 列顺序必须一一对应,不能只看列名“差不多”。
目标表字段列表在语法上可以省略,但前提是子查询返回列要与目标表定义完全一致,包括顺序也一致。实际使用中并不推荐省略,因为表结构一旦调整,就很容易把数据插错列。
子查询可以有多复杂
很多人会把它理解成“只能复制一张表的数据”,其实远不止如此。只要最终返回的是可插入的二维结果集,子查询里可以带:
JOINWHEREGROUP BY- 嵌套子查询
也就是说,它既能做简单搬运,也能做筛选、聚合、关联后的结果入表。
不同数据库的兼容性差异
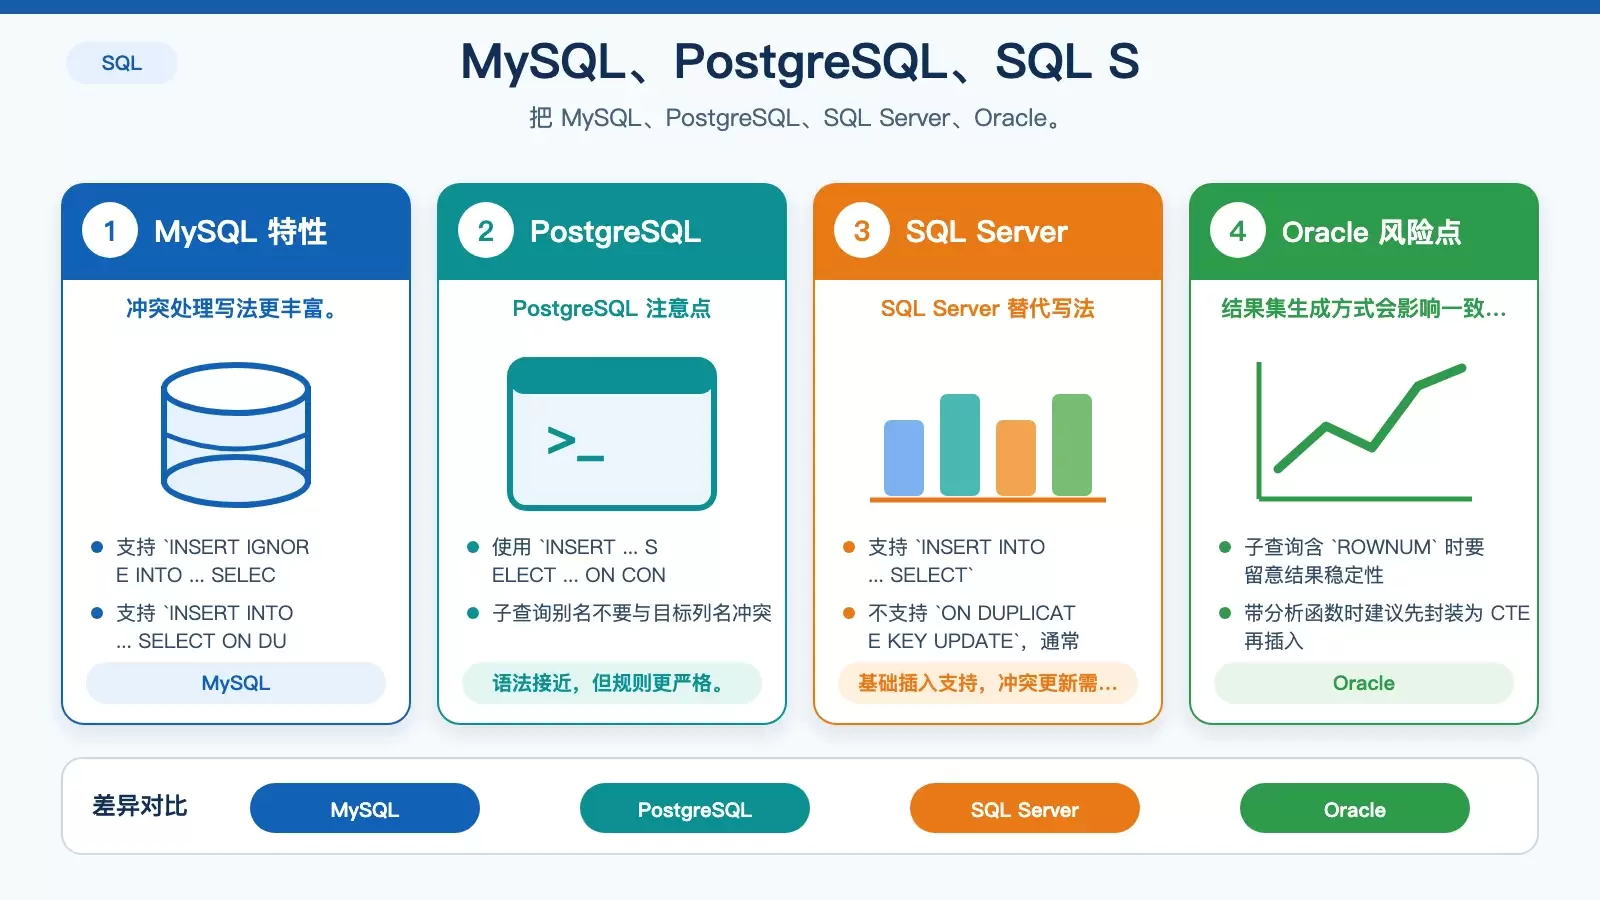
INSERT INTO ... SELECT 的基础语法在多种数据库中都能用,但一旦涉及冲突处理、别名规则或替代写法,差异就会开始出现。
MySQL 和 PostgreSQL 的差别
- MySQL 支持
INSERT IGNORE INTO ... SELECT。 - MySQL 还支持
INSERT INTO ... SELECT ON DUPLICATE KEY UPDATE ...。 - PostgreSQL 对应的冲突处理方式是
INSERT ... SELECT ... ON CONFLICT DO UPDATE。 - PostgreSQL 对子查询别名更敏感,如果使用了
AS,别名不要与目标列名冲突;MySQL 在这方面更宽松。
SQL Server 和 Oracle 要注意什么
- SQL Server 同样支持
INSERT INTO ... SELECT,但不支持ON DUPLICATE KEY UPDATE,通常要改用MERGE。 - Oracle 如果子查询里包含
ROWNUM或分析函数,可能影响结果一致性,更稳妥的做法是先封装成 CTE,再执行插入。
所以,如果你的 SQL 需要跨数据库迁移,不能只看“主语法能跑”,还要核对冲突处理和结果集生成细节。
性能与锁:它不是轻量操作
虽然语法很短,但 INSERT ... SELECT 并不是轻量级语句。它往往意味着一次读取加一次写入,还可能附带约束校验、索引维护和日志写入,表越大、并发越高,影响越明显。
不同数据库中的锁行为
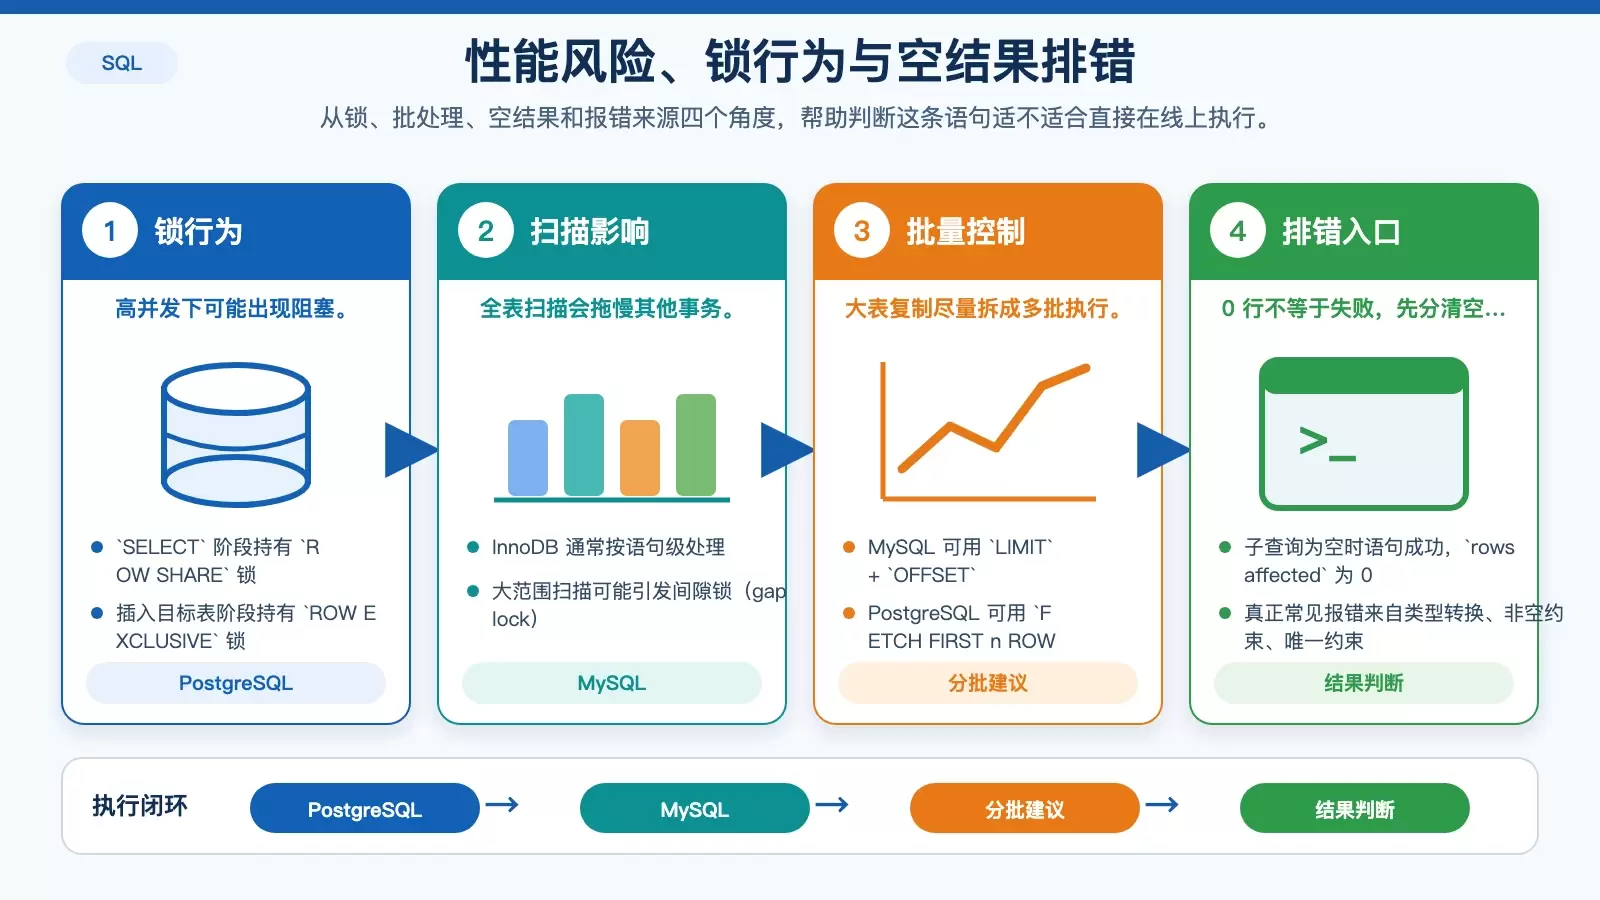
- 在 PostgreSQL 中,整个
SELECT阶段会持有ROW SHARE锁,目标表插入过程中持有ROW EXCLUSIVE锁;高并发下更容易出现阻塞。 - 在 MySQL(InnoDB)中,通常是语句级加锁;如果子查询扫描大范围数据甚至全表,可能引发间隙锁(gap lock),进而拖慢其他事务。
大表场景下怎么控制风险
如果是在生产环境里跨大表复制数据,尽量避开业务高峰期执行。更常见的做法是分批插入,把一次大事务拆成多次小事务。
- MySQL 可用
LIMIT+OFFSET控制批次大小。 - PostgreSQL 可用
FETCH FIRST n ROWS ONLY分批处理。
另外,在“目标表本来就不存在”的场景下,CREATE TABLE AS SELECT 有时比 INSERT ... SELECT 更快,因为它不需要承担约束校验和索引维护开销。不过这只适用于新建表,不适合向已有业务表补数据。
子查询为空会不会报错,真正会报错的又是什么
子查询返回空结果集时,INSERT ... SELECT 不会报错。语句仍然是成功执行的,只是没有任何行被插入,此时 rows affected 会返回 0。
这也是实际排查里很容易误判的一点:很多人看到“插入了 0 行”就以为语句没生效,但从 SQL 逻辑上看,这通常只是筛选条件没有命中数据。
真正常见的报错来源
更需要警惕的,其实是这些情况:
- 字段类型隐式转换失败,比如把字符串插入
INT列。 NULL被插入到非空列。- 违反唯一约束。
这类错误通常会直接指向 INSERT 语句本身,而不是把问题标记在子查询内部,所以排查时不能只盯着报错位置看字面提示。
实用排错方法
- 先单独运行子查询,确认返回列名、类型以及
NULL性是否符合目标表定义。 - PostgreSQL 可以用
set VERBOSITY verbose查看更详细的错误上下文。 - MySQL 可考虑开启
log_warnings = 2,用于捕获隐式转换相关告警。 - 如果子查询里用了聚合函数,例如
COUNT(*),要确认外层没有遗漏GROUP BY,否则可能只返回一行结果,却和预期插入结构不一致。
实操时可以直接记住的判断规则
如果你只想快速判断一条 SQL 是否写对,优先检查这几项:
- 是否使用了正确的
INSERT INTO ... SELECT结构,而不是把子查询塞进VALUES。 - 目标列和子查询输出列的列数、类型、顺序是否完全对齐。
- 当前数据库对冲突处理语法的支持是否一致,例如
ON DUPLICATE KEY UPDATE、ON CONFLICT DO UPDATE、MERGE的差异。 - 是否会因为大表扫描、锁竞争和日志写入影响线上性能。
- 如果插入了 0 行,先确认子查询是否为空结果,而不是默认判断语句失败。
把这些点理顺之后,INSERT INTO ... SELECT 其实是非常稳定、非常高效的一类 SQL 写法,尤其适合批量写入和表间数据转换场景。









