


查重复数据时,很多人第一反应是上 GROUP BY + COUNT(*),但真正落到业务里,往往还要继续回答两个问题:重复的是哪几行、后续能不能安全删除。嵌套查询正适合处理这类场景,不过 IN、EXISTS、多字段匹配和 MySQL 的同表删除限制,都会直接影响结果是否可靠。下面按常见问题拆开讲,顺着“先找出来,再判断怎么删”的路径,把几种高频写法和容易踩的坑一次理清。
用 IN 子查询把重复记录完整找出来
最常用、兼容性也最好的思路,是先在子查询里找出重复字段组合,再由外层 WHERE ... IN 把对应原始记录全部查出来。这样做的重点不在于 COUNT(*) 本身,而在于子查询必须返回一个能让外层匹配的值,通常是分组字段,或者能映射回原表的主键。
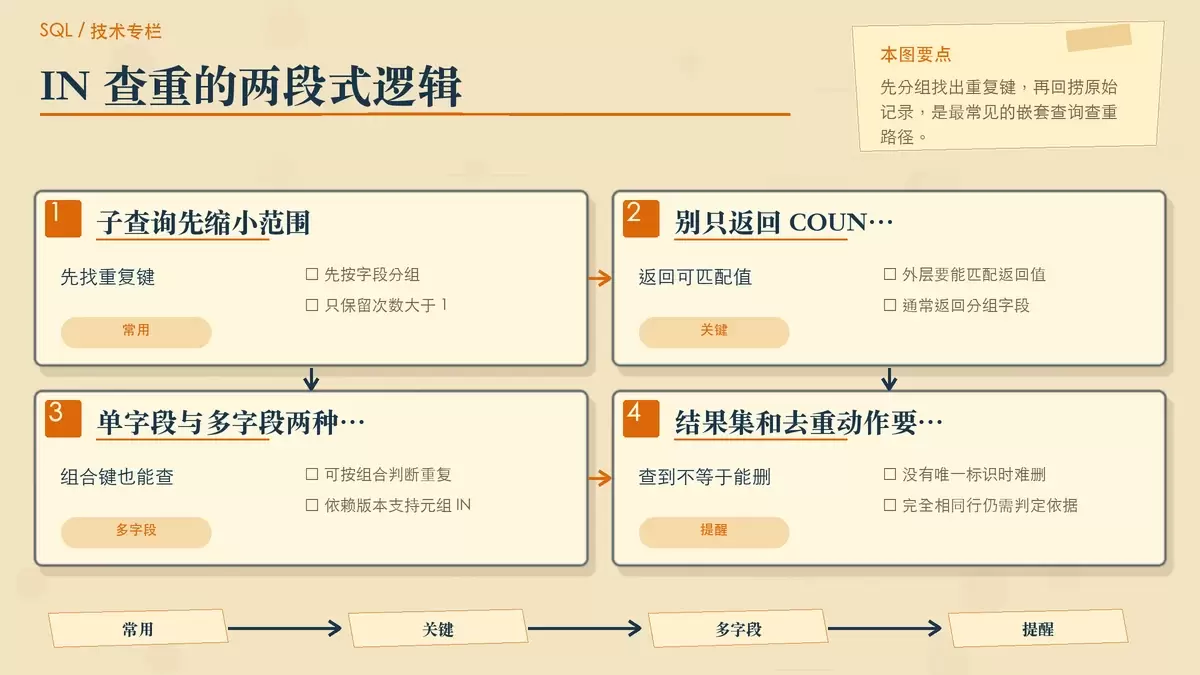
常见误区有两个。第一,子查询只返回 COUNT(*),外层却试图拿某个字段去 IN 它,结果逻辑根本对不上。第二,漏掉 HAVING COUNT(*) > 1,这样分组后的所有值都会被返回,最后查出来的就不再是“重复数据”,而是整批普通数据。
按单字段判断重复
如果要找 users 表里 email 重复的所有记录,写法可以直接分成两层:
SELECT * FROM users WHERE email IN (SELECT email FROM users GROUP BY email HAVING COUNT(*) > 1);这条语句的执行顺序很明确:先由子查询筛出出现次数大于 1 的 email,再由外层把这些 email 对应的原始行全部拉出来。它适合“我先要看到所有重复记录,再决定保留哪条”的场景。
按多字段组合判断重复
有些表不能只看一个字段,比如只有当 username 和 email 同时相同,才算重复。这时可以让子查询返回字段组合:
SELECT * FROM users WHERE (username, email) IN (SELECT username, email FROM users GROUP BY username, email HAVING COUNT(*) > 1);这里要特别注意版本差异:MySQL 8.0+ 支持这种元组 IN 写法,低版本则不一定可用。遇到老版本环境,通常要改成 JOIN 实现;把多个字段拼接成字符串再比较虽然能绕过去,但可读性、可维护性和边界处理都比较差,一般不推荐。
另外,如果表里没有主键或其他唯一标识,单靠 IN 只能告诉你“哪些记录重复了”,却不容易进一步区分“哪条该留、哪条该删”。特别是两行内容完全一致时,查询会把它们一起找出来,但去重动作仍然需要一个稳定的判定依据,比如 id 或创建时间。
字段可能为空时,优先考虑 EXISTS
IN 看起来直观,但在子查询结果可能带有 NULL 的场景里,它很容易变得不可靠。原文里给出的判断是:当子查询结果含 NULL 时,IN 条件会失效,导致查不到预期数据。遇到这种情况,换成 EXISTS 更稳,也更贴近“只要存在另一条满足条件的记录,就说明当前行重复了”这层语义。
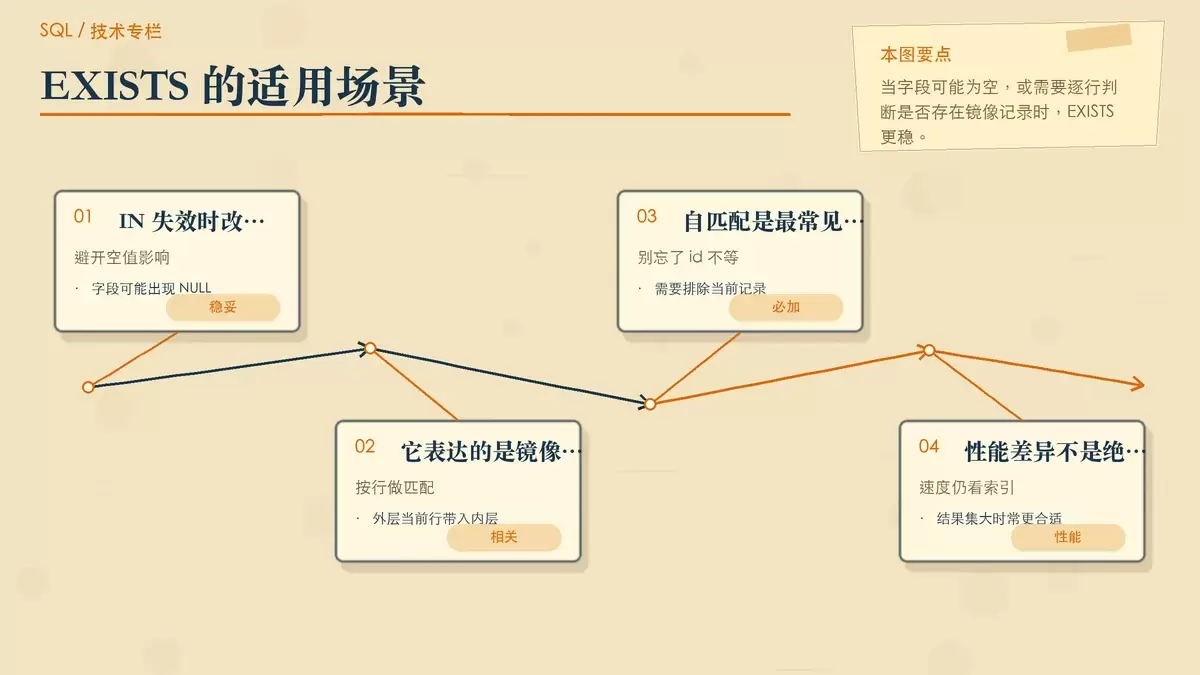
EXISTS 也适合你明确想表达“存在镜像行”关系的场景,因为它不是先收集一批值再匹配,而是逐行判断有没有对应记录存在。
一个典型的 EXISTS 重复查询
例如,要找 orders 表中 customer_id 与 order_date 相同的重复订单,可以这样写:
SELECT * FROM orders o1 WHERE EXISTS (SELECT 1 FROM orders o2 WHERE o2.customer_id = o1.customer_id AND o2.order_date = o1.order_date AND o2.id <> o1.id);这类相关子查询的关键,是外层当前行 o1 会逐条带入内层条件中,再看内层是否能找到“另一条”满足同样业务键的记录。
其中最不能漏的是 o2.id <> o1.id。如果少了这句,每一行都会和自己匹配成功,结果整张表都会被判定为重复数据,查询就失去意义了。
什么时候它比 IN 更合适
从可读性上说,EXISTS 更适合“是否存在重复行”的表达;从性能上说,原文的结论是:当子查询结果集较大时,EXISTS 通常比 IN 更快一些。不过这一点并不是绝对规则,真正决定速度的还是索引。如果相关字段走不到索引,不管是 IN 还是 EXISTS,都会慢下来。
删除重复数据时,先避开 MySQL 的同表子查询限制
查出来只是第一步,很多人接着就会想直接删除重复记录。但在 MySQL 里,这一步经常卡在一条经典报错上:
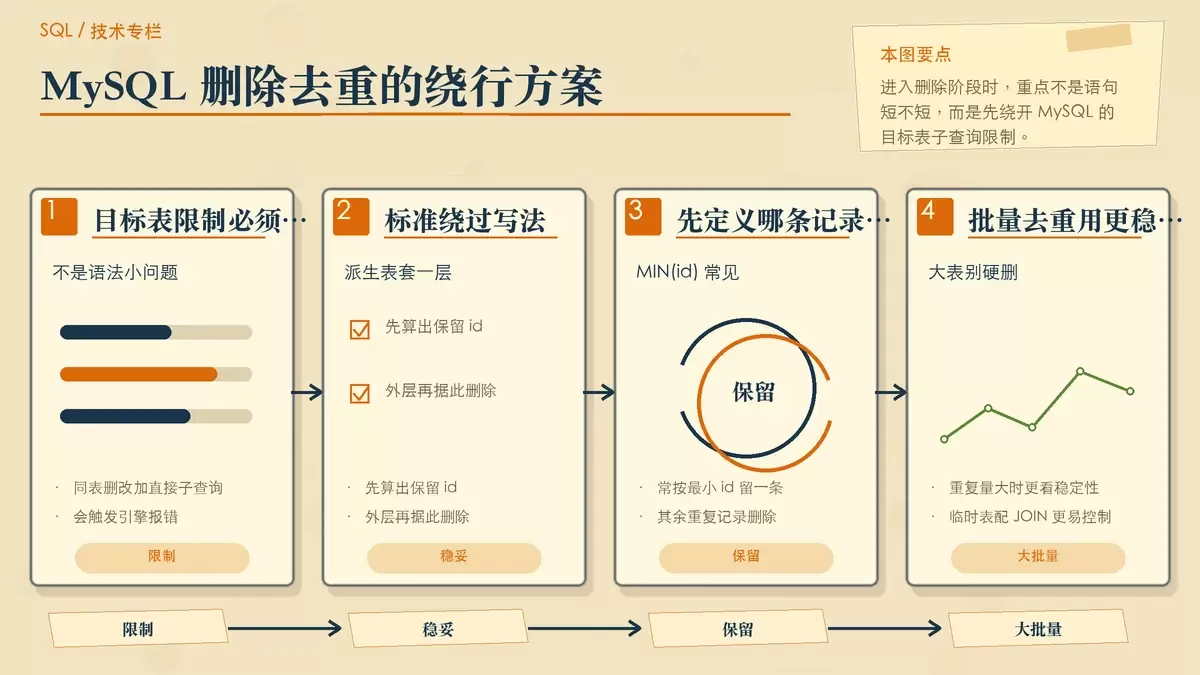
You can't specify target table 'X' for update in FROM clause这不是简单的语法问题,而是 MySQL 不允许你在 DELETE 语句中,一边修改某张表,一边又直接从这张表的子查询结果里取值来决定删谁。也就是说,同一张表既当目标表又当直接子查询来源,会触发引擎限制。
用派生表套一层是最稳的写法
处理方式通常是加一层派生表,把“应该保留哪些记录”的结果先包起来,再交给外层删除:
DELETE FROM users WHERE id NOT IN (SELECT min_id FROM (SELECT MIN(id) AS min_id FROM users GROUP BY email) AS t);这条语句的思路是:按 email 分组时,每组保留最小的 id,其余的都删掉。中间额外包一层 SELECT,就是为了绕开 MySQL 对同表直接子查询删除的限制。
因此,下面这种看起来更短的写法,反而会直接报错:
DELETE FROM users WHERE id NOT IN (SELECT MIN(id) FROM users GROUP BY email)重复数据很多时,临时表或 JOIN 往往更稳
如果重复数据量很大,嵌套查询虽然能写出来,但未必是最稳定的执行方案。原文给出的建议是:先建临时表存放去重后保留的 id,再通过 JOIN 删除多余记录。这种做法在大批量去重时通常更容易控制,也更方便拆分验证过程。
为什么窗口函数不算这类问题里的嵌套查询
很多人一看到“查重复并保留一条”,就会想到 ROW_NUMBER() OVER(...)。它当然是处理重复数据的常见工具,但它属于窗口函数方案,不是本文讨论的嵌套查询写法。
即使它经常和 WITH CTE 一起出现,也不能把两者等同于子查询:CTE 只是一个命名结果集,窗口函数也有自己独立的执行方式,和这里依赖内外层查询关系的嵌套写法不是一回事。
还有一个很现实的边界条件:如果你的 MySQL 版本低于 8.0,本来就不能用窗口函数。这也是为什么在很多兼容旧环境的场景里,IN、EXISTS、派生表这些嵌套查询方案仍然很常见。
真正容易被忽略的,是嵌套查询的执行顺序。一般情况下,子查询会先执行,结果确定后外层再继续跑;只有相关子查询才会在外层逐行参与判断。搞混这一点,就容易写出依赖关系错误的 SQL,比如把外层列错误地拿到普通子查询里使用,最终得到不可控的结果。
实际选型时,可以这样判断
如果你只是要把重复记录找出来,而且字段本身不涉及空值,单字段或多字段的 IN 子查询通常最直观;如果字段可能为 NULL,或者你更想表达“是否存在另一条相同记录”,就优先考虑 EXISTS。一旦进入删除阶段,尤其是在 MySQL 里操作同一张表时,先确认是否会触发目标表子查询限制,再决定是用派生表、临时表,还是改成 JOIN 方案。
换句话说,查重 SQL 的核心不只是“能不能查出来”,还包括三件事:匹配条件是否准确、版本是否支持、删除动作是否受引擎限制。把这三个判断放在前面,很多重复数据问题其实不会走到返工那一步。









