

Scrapy框架爬取西刺代理网免费高匿代理的实现代码

发布时间:2026-10-13| 3人浏览过
本文详细介绍如何使用Scrapy框架爬取西刺代理网的免费高匿IP数据,并将结果保存至MySQL数据库。教程涵盖项目创建、Item定义、Spider编写、Pipeline配置及Settings设置等完整步骤,代码示例仅展示前10页数据抓取逻辑,适合Python初学者参考学习。
分析
需求:
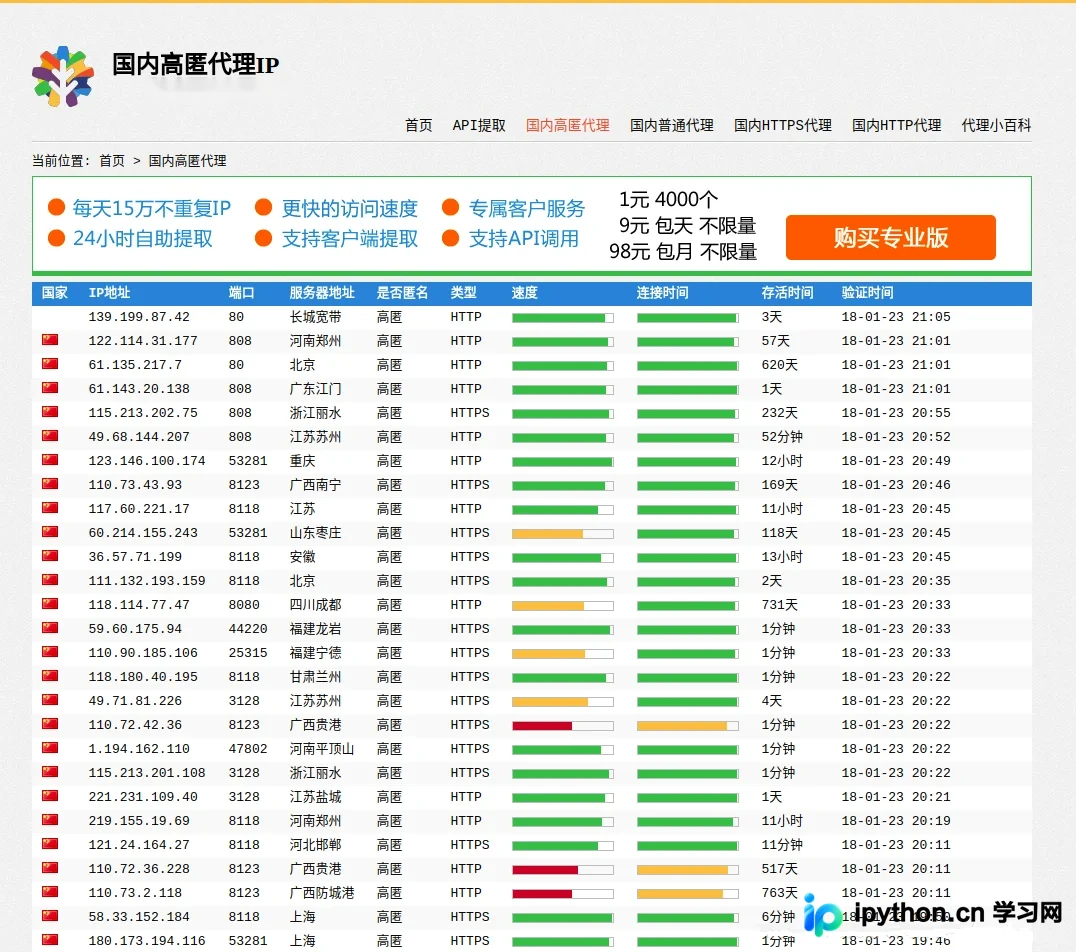
目标是爬取西刺代理网站上的免费高匿代理IP信息,并将抓取到的数据持久化保存到MySQL数据库中。
为控制数据量,本次示例仅抓取网站前10页的内容。
思路:
- 首先分析目标网页的DOM结构,确定提取IP、端口等关键字段的CSS或XPath规则。
- 接着使用Scrapy命令行工具创建一个新的爬虫项目。
- 在items.py中定义XicidailiItem,明确需要采集的数据字段结构。
- 编写xicidaili_spider.py,实现页面请求发送与数据解析逻辑。
- 编写XicidailiPipeline,负责将解析后的Item数据写入MySQL数据库。
- 修改settings.py配置文件,启用Pipeline并设置相关参数。
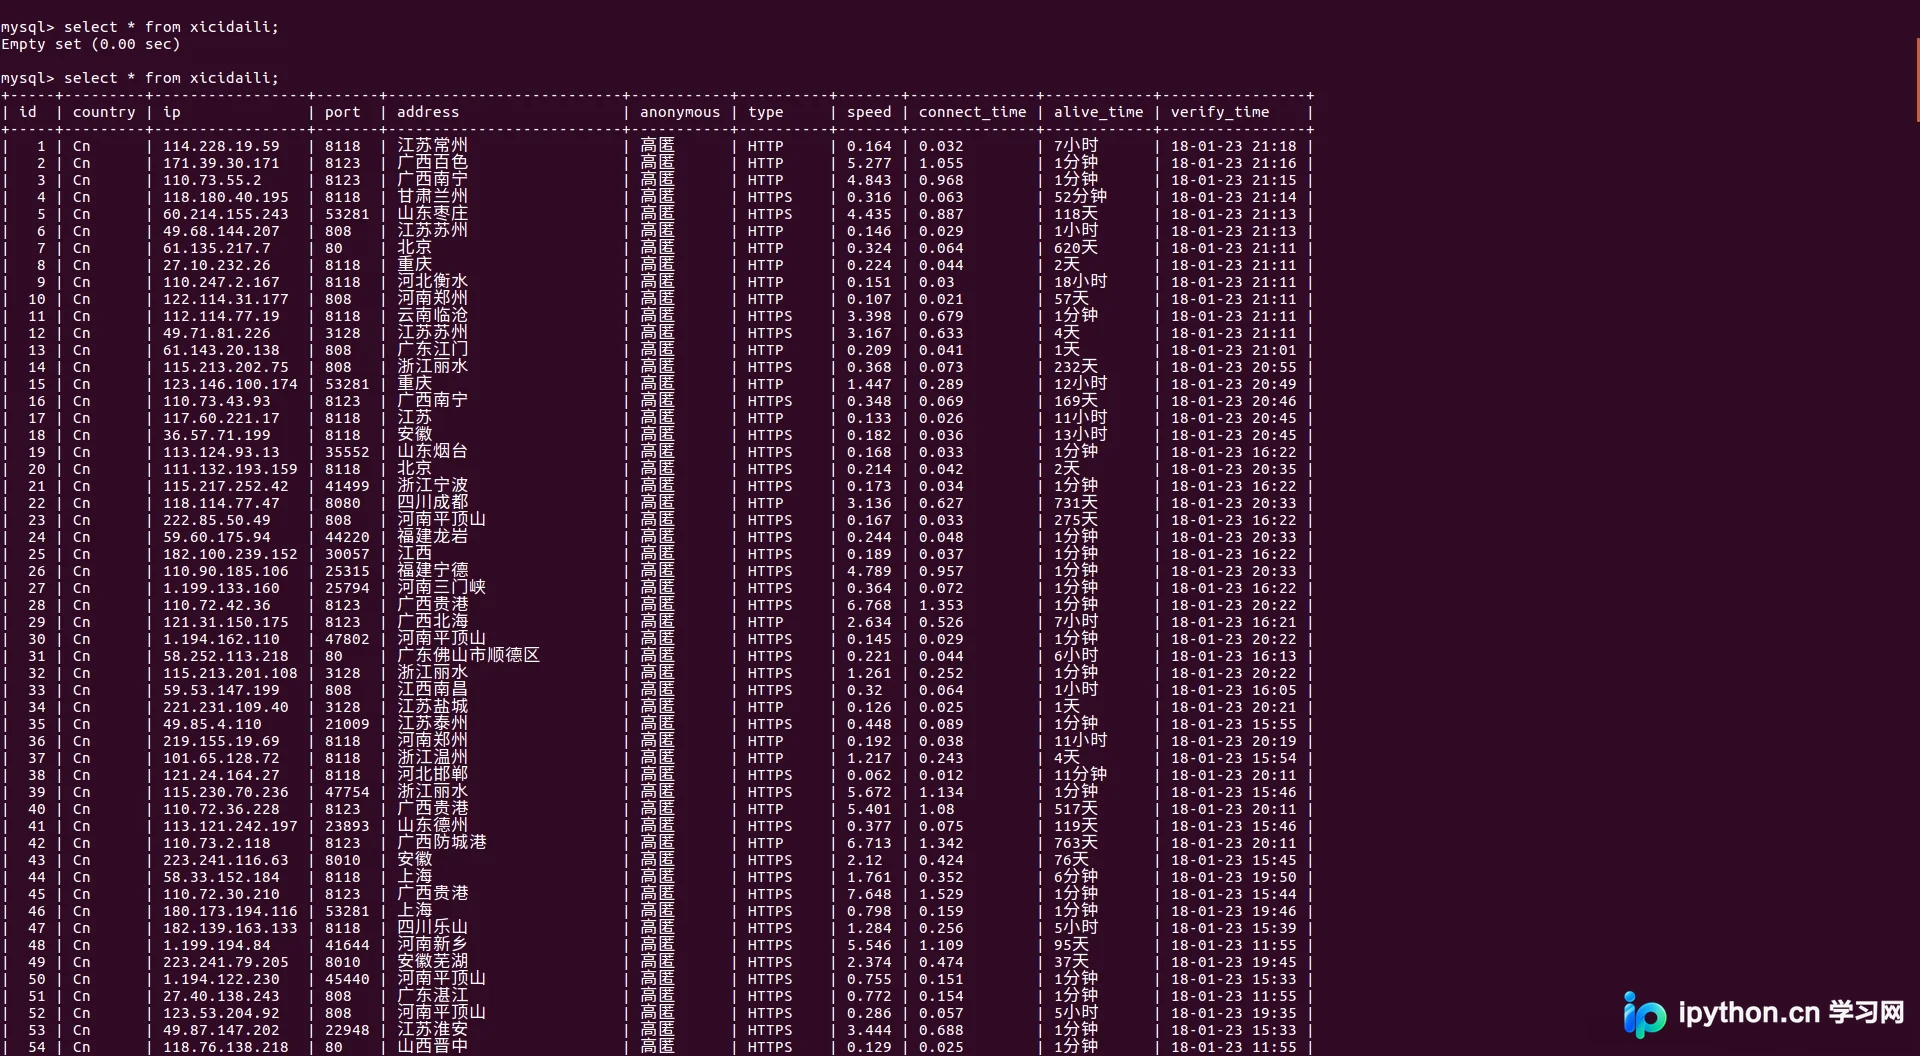
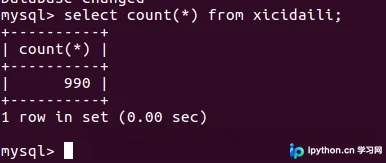
- 最后运行爬虫命令,执行数据抓取与存储任务。
代码实现
items.py
import scrapy
class XicidailiItem(scrapy.Item):
  # 国家
  country=scrapy.Field()
  # IP地址
  ip=scrapy.Field()
  # 端口号
  port=scrapy.Field()
  # 服务器地址
  address=scrapy.Field()
  # 是否匿名
  anonymous=scrapy.Field()
  # 类型
  type=scrapy.Field()
  # 速度
  speed=scrapy.Field()
  # 连接时间
  connect_time=scrapy.Field()
  # 存活时间
  alive_time=scrapy.Field()
  # 验证时间
  verify_time=scrapy.Field()
xicidaili_spider.py
# !/usr/bin/env python
# -*- coding:utf-8 -*-
import scrapy
from myscrapy.items import XicidailiItem
class XicidailiSpider(scrapy.Spider):
  name = 'xicidaili'
  allowed_domains=['www.xicidaili.com']
  # start_urls=['http://www.xicidaili.com/nn/1']
  def start_requests(self):
    urls=[]
    for i in range(1,11):
      urls.append('http://www.xicidaili.com/nn/'+str(i))
    for url in urls:
      yield scrapy.Request(url,callback=self.parse,method='GET')
  def parse(self, response):
    tr_list=response.xpath('//table[@id="ip_list"]/tr')
    for tr in tr_list[1:]: # 过滤掉表头行
      item=XicidailiItem()
      item['country']=tr.xpath('./td[1]/img/@alt').extract_first()
      item['ip']=tr.xpath('./td[2]/text()').extract_first()
      item['port']=tr.xpath('./td[3]/text()').extract_first()
      item['address']=tr.xpath('./td[4]/a/text()').extract_first()
      item['anonymous']=tr.xpath('./td[5]/text()').extract_first()
      item['type']=tr.xpath('./td[6]/text()').extract_first()
      item['speed']=tr.xpath('./td[7]/div/@title').re(r'\d{1,3}\.\d{0,}')[0]
      item['connect_time']=tr.xpath('./td[8]/div/@title').re(r'\d{1,3}\.\d{0,}')[0]
      item['alive_time']=tr.xpath('./td[9]/text()').extract_first()
      item['verify_time']=tr.xpath('./td[10]/text()').extract_first()
      yield item
pipelines.py
class XicidailiPipeline(object):
  """
  西刺代理爬虫 item Pipeline
  create table xicidaili(
    id int primary key auto_increment,
    country varchar(10) not null,
    ip varchar(30) not null,
    port varchar(10) not null,
    address varchar(30) not null,
    anonymous varchar(10) not null,
    type varchar(20) not null,
    speed varchar(10) not null,
    connect_time varchar(20) not null,
    alive_time varchar(20) not null,
    verify_time varchar(20) not null);
  """
  def __init__(self):
    self.connection = pymysql.connect(host='localhost',
                     user='root',
                     password='123456',
                     db='mydb',
                     charset='utf8', # 不能用utf-8
                     cursorclass=pymysql.cursors.DictCursor)
  def process_item(self,item,spider):
    with self.connection.cursor() as cursor:
      sql='insert into xicidaili' \
        '(country,ip,port,address,anonymous,type,speed,connect_time,alive_time,verify_time) values' \
        '(%s,%s,%s,%s,%s,%s,%s,%s,%s,%s);'
      args=(item['country'],item['ip'],item['port'],item['address'],item['anonymous'],item['type'],item['speed'],item['connect_time'],item['alive_time'],item['verify_time'])
      spider.logger.info(args)
      cursor.execute(sql,args)
    self.connection.commit()
  def close_spider(self,spider):
    self.connection.close()
settings.py
ITEM_PIPELINES = {
  'myscrapy.pipelines.XicidailiPipeline': 300,
}
结果
总结
以上就是本文关于使用Scrapy爬取西刺代理并存储MySQL的全部内容,希望能为读者的学习或工作提供有价值的参考。感谢支持,如需了解更多技术细节,请查阅相关链接。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









