Python实现知乎高颜值图片自动化爬取与人脸检测
本文详细介绍如何使用Python编写爬虫程序,通过知乎开放API获取话题下的回答列表,并利用百度云人脸检测接口对图片进行颜值评分。教程涵盖环境配置、API调用、反爬策略处理及图片保存逻辑,帮助开发者实现自动化筛选高颜值图片的功能。
2026-10-13
6

本文详细介绍如何使用Python编写爬虫程序,通过知乎开放API获取话题下的回答列表,并利用百度云人脸检测接口对图片进行颜值评分。教程涵盖环境配置、API调用、反爬策略处理及图片保存逻辑,帮助开发者实现自动化筛选高颜值图片的功能。
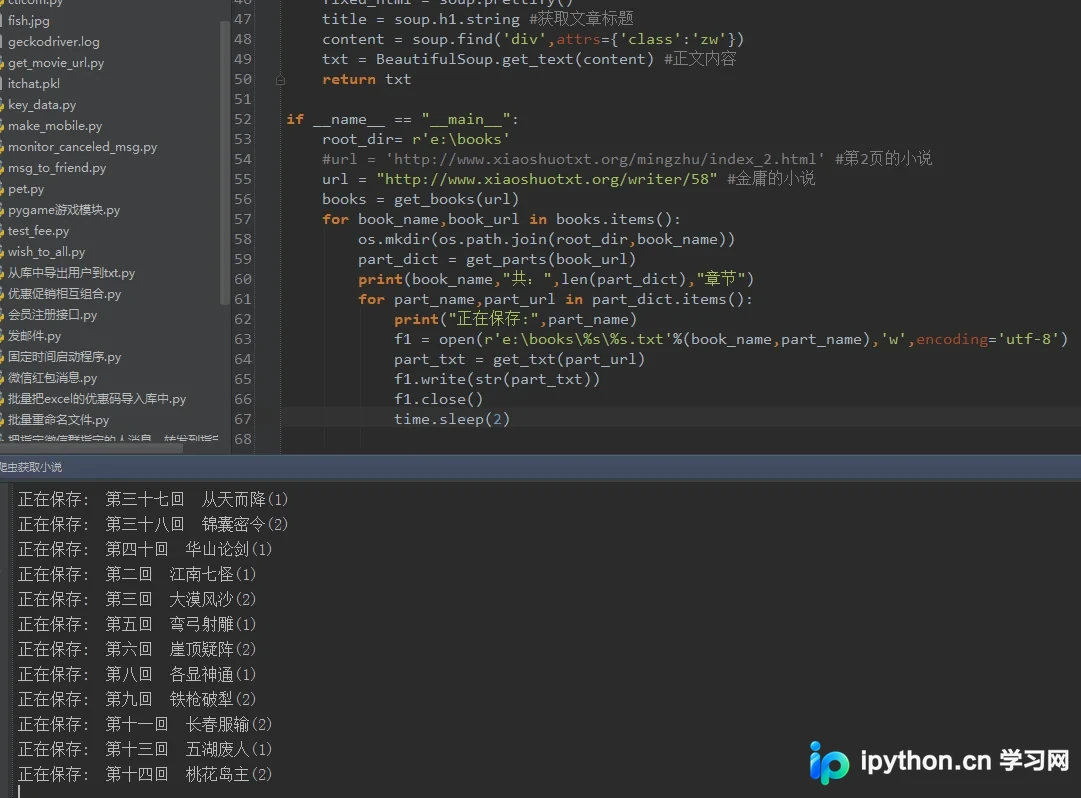
本文提供基于Python的完整爬虫示例,演示如何自动抓取金庸小说全集。通过BeautifulSoup解析网页结构,遍历章节列表并逐章下载保存为本地文本文件。代码包含URL请求、HTML解析及文件写入逻辑,适合Python初学者学习网络数据采集与文件处理实战。
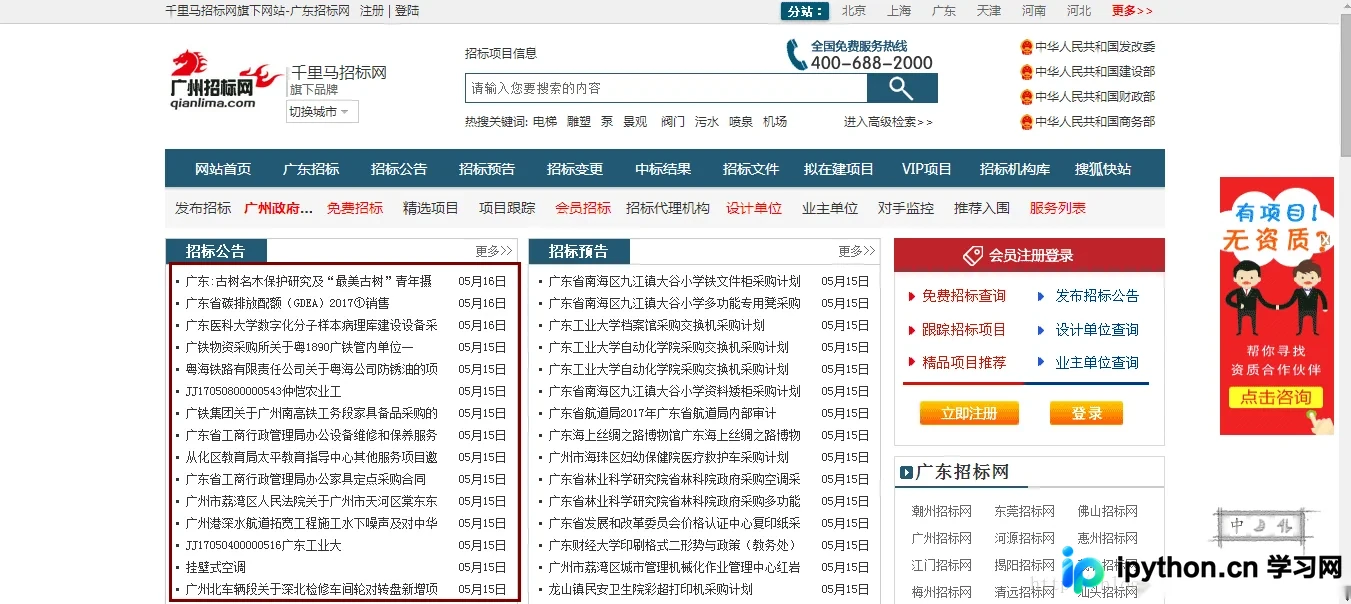
本文详细介绍如何使用Python的requests库发起HTTP请求,并结合BeautifulSoup解析HTML页面,从指定的招投标网站中提取链接、标题及时间等关键信息。文章提供了完整的代码示例及运行结果分析,适合希望学习基础网络爬虫开发的开发者参考。
本文探讨Python爬虫在抓取需验证码页面时遇到的验证码同步难题,并提供三种解决方案:利用Session保持会话、通过Cookie传递凭证以及使用Selenium结合手动构造Cookie。重点解析了Selenium中Cookie的增删改查API,并指出识别加密Cookie键名的难点,旨在帮助开发者绕过验证码识别的高成本或低成功率限制。
本文介绍如何在Python爬虫项目中实现中断重连与断点续爬功能,以应对网站验证或IP封禁导致的程序中断。通过维护新URL与已爬取URL集合,并将数据持久化至文件,避免内存溢出。文中提供了基于文件操作的URL管理器类及获取最后一行数据的详细代码实现,帮助开发者快速集成该功能。
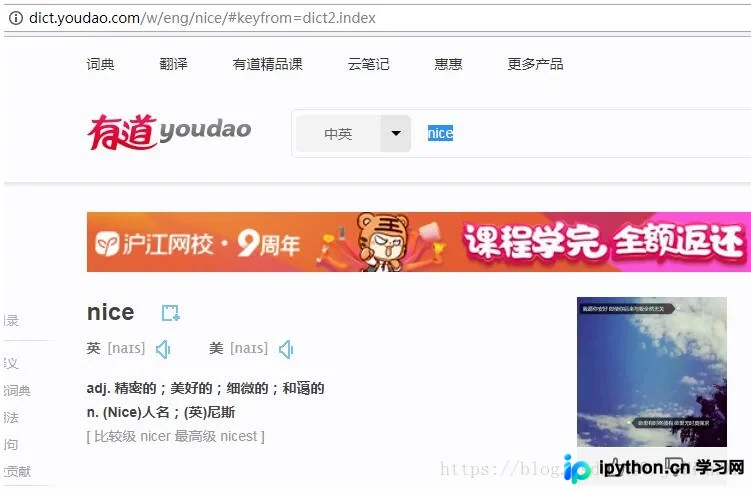
本文演示如何使用Python requests和BeautifulSoup库抓取有道词典网页数据,实现英汉互译功能。通过ctypes模块实现Windows控制台彩色文字输出,并利用PyInstaller将脚本打包为独立的EXE文件,方便在CMD中直接运行。
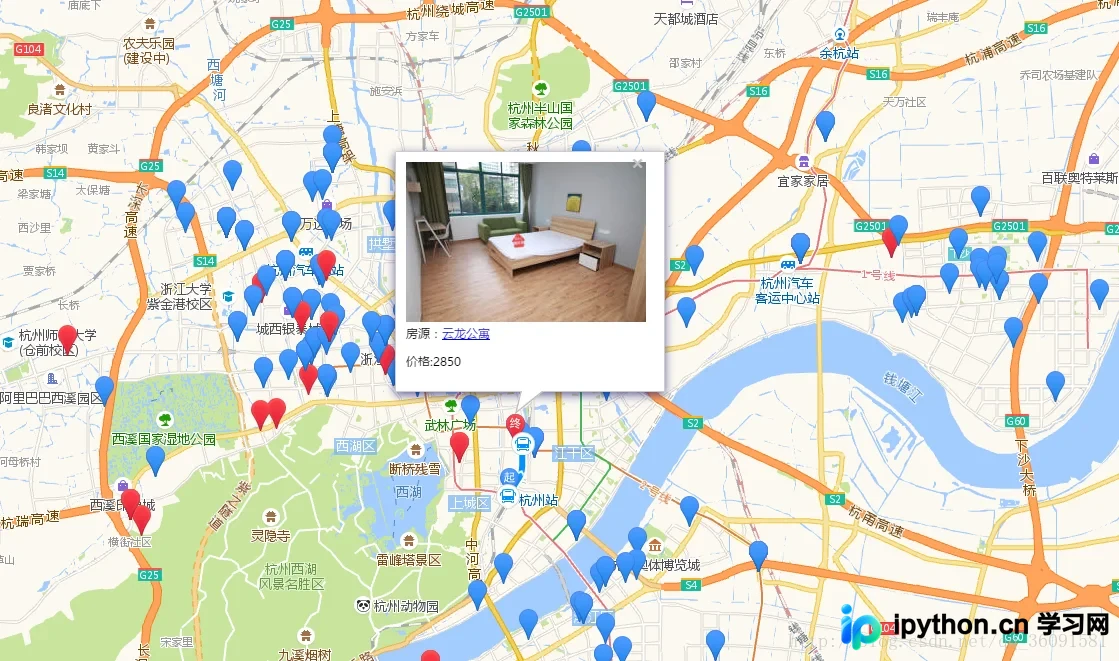
本文介绍使用Python爬虫技术抓取58同城杭州地区特定价格段的公寓房源数据,并通过高德地图API将房源位置、价格等信息可视化展示在地图上。文章包含Python后端抓取逻辑与前端HTML/JS交互代码,支持工作地点筛选及通勤方式计算,帮助开发者快速实现房源地图展示功能。
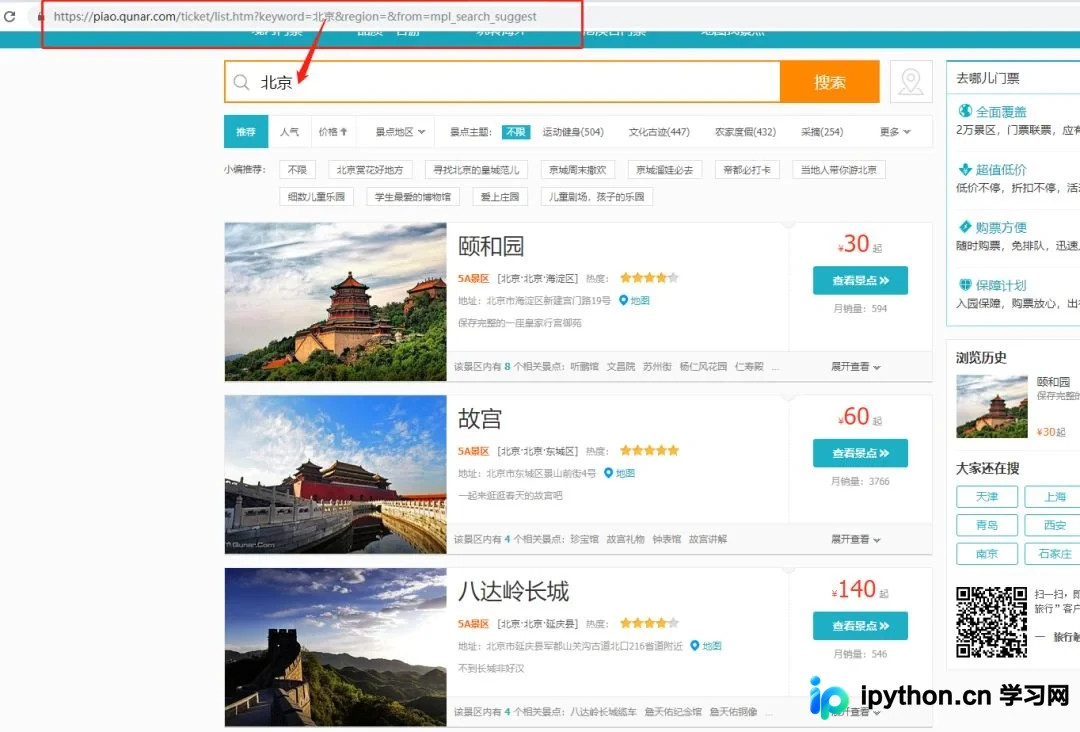
本文利用Python爬虫技术,从去哪儿网抓取北京、上海等13个热门城市的景区门票数据。通过统计销量与价格分布,分析五一假期最受欢迎的景区及票价区间,为后续出行规划提供参考。
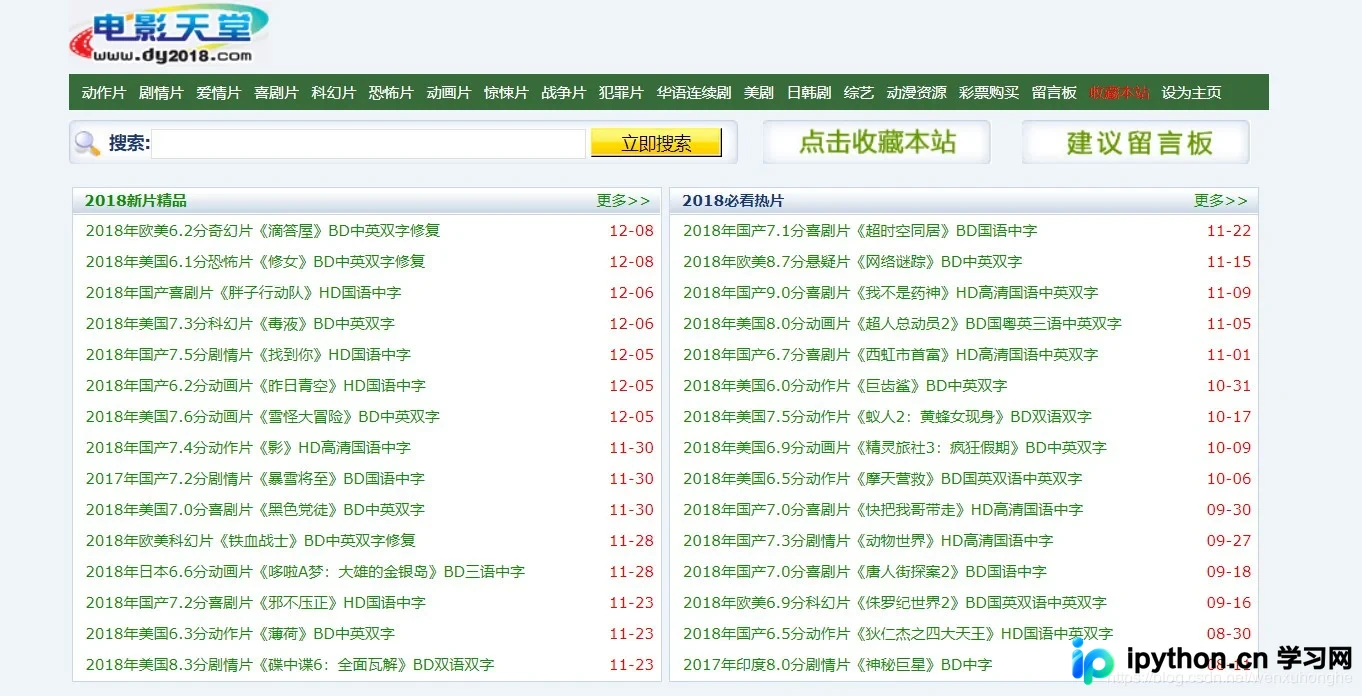
本文详细解析使用Python爬取《电影天堂》动作片板块的全过程。从URL结构分析、页面HTML解析到数据存储,逐步讲解如何构建爬虫程序。重点介绍利用BeautifulSoup提取电影名称与磁力链接,并通过优化代码仅保留magnet协议链接。此外,分享了结合pyperclip与迅雷实现批量下载的技巧,帮助读者掌握基础爬虫原理及实用数据处理方法。
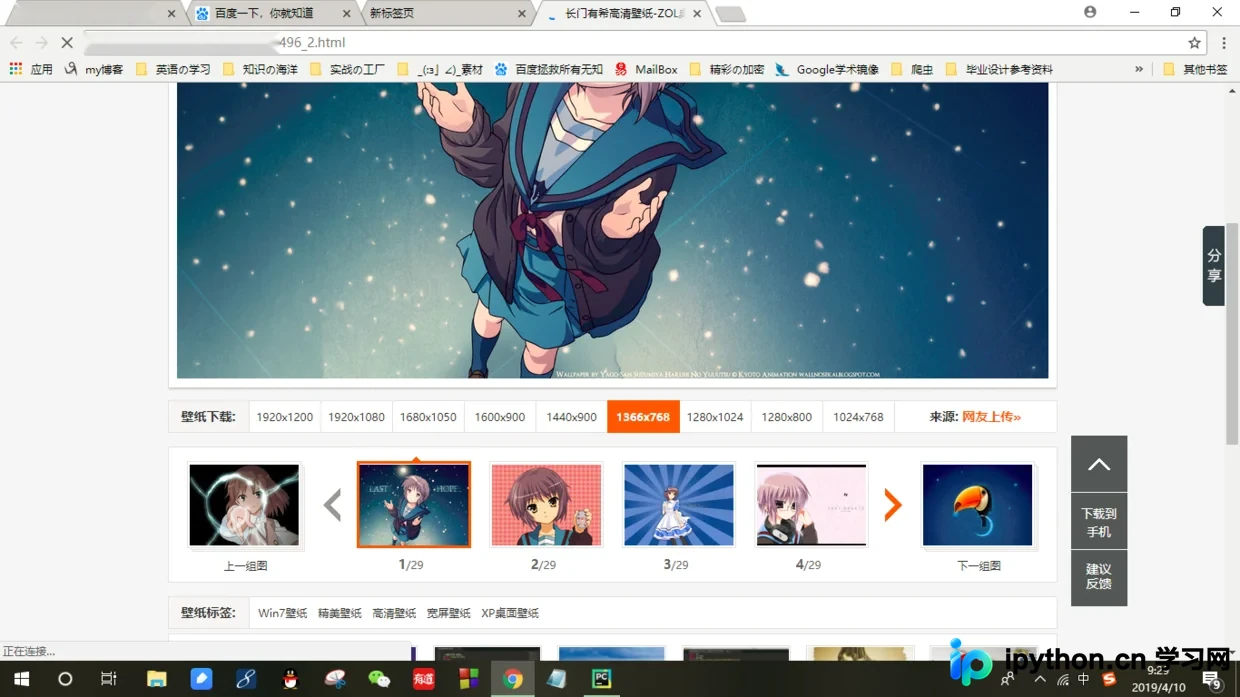
本文详解使用Python爬取高清壁纸的完整流程。通过模拟人工浏览步骤,包括访问列表页、解析源码获取子页面链接、进入详情页选择分辨率及最终下载图片,实现自动化批量获取。文中结合具体案例与代码注释,解析如何构造请求地址及处理中间链接,帮助开发者掌握静态网页图片抓取的核心技巧。
本文详解如何使用Python的requests库模拟豆瓣6.0新版网站的登录过程。通过开发者工具分析POST请求接口与数据格式,利用Session保持Cookie状态,成功获取个人首页内容。针对新版反爬策略,提供了完整的代码示例与关键步骤解析,帮助开发者解决登录失败问题。
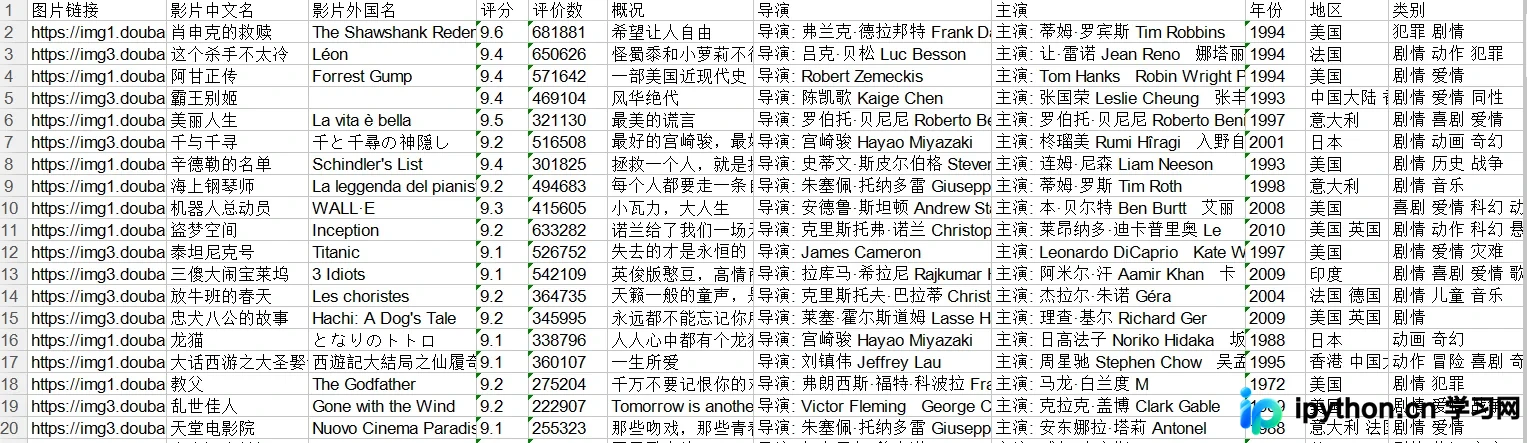
本文详细演示如何使用Python爬取豆瓣电影Top250的12项关键信息,包括链接、评分、主演及年份等。通过正则表达式解析HTML,利用BeautifulSoup和xlwt库将数据整理并写入Excel文件,提供完整代码供参考。