

Python爬虫实现GitHub模拟登录并提取数据
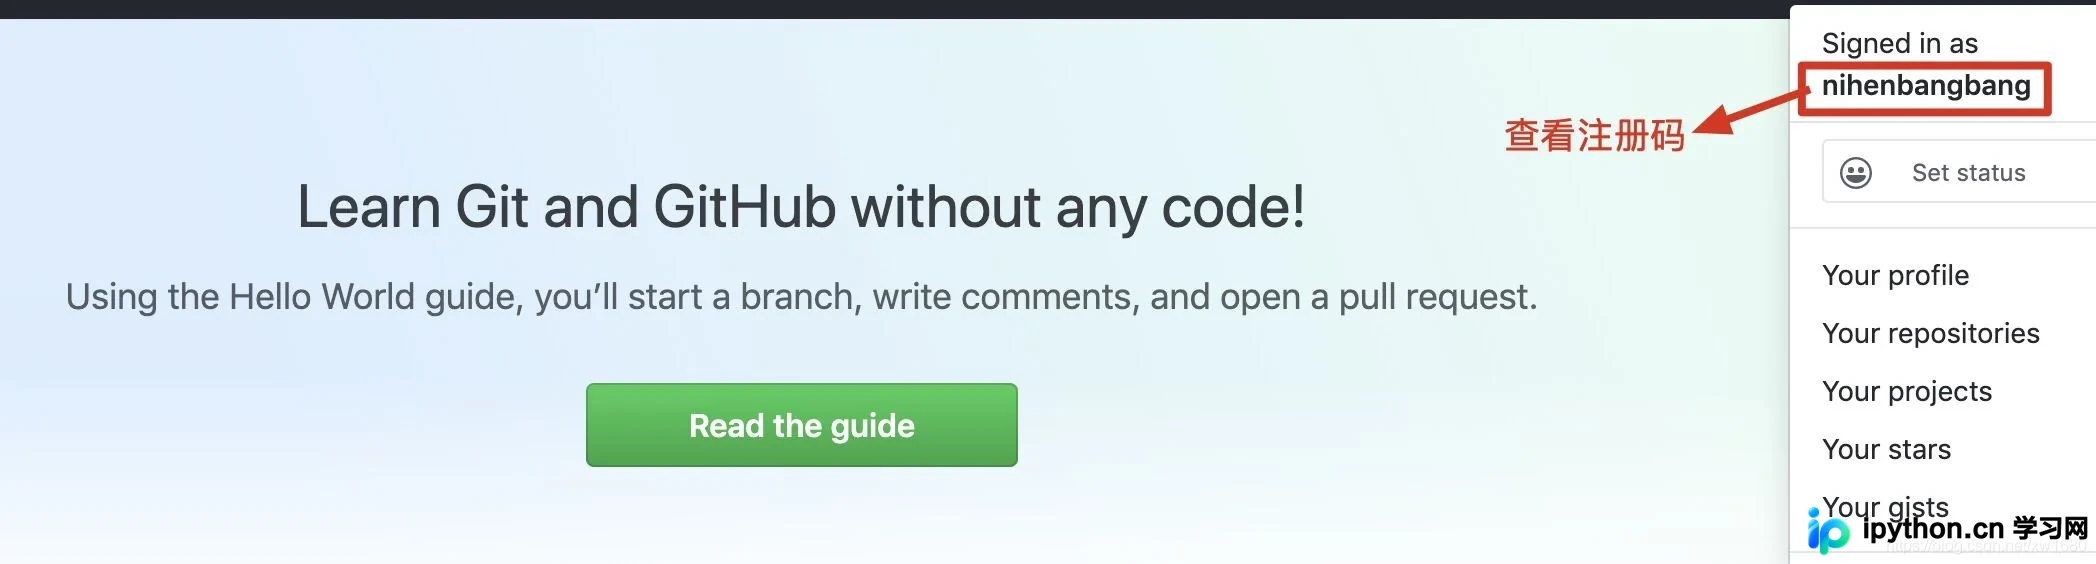
本文详解如何使用Python爬虫实现GitHub网页的模拟登录。通过浏览器开发者工具分析登录请求,提取Form Data中的动态参数authenticity_token、login及password,利用requests.Session保持会话状态,发送POST请求完成登录,并成功提取登录后的页面信息如注册号码。
2026-10-14
5

本文详解如何使用Python爬虫实现GitHub网页的模拟登录。通过浏览器开发者工具分析登录请求,提取Form Data中的动态参数authenticity_token、login及password,利用requests.Session保持会话状态,发送POST请求完成登录,并成功提取登录后的页面信息如注册号码。
针对办公环境网络隔离导致VBA开发不便的问题,本文介绍如何利用Python结合Selenium与Requests库,从微软官方文档网站抓取VBA API数据。通过遍历导航树获取链接,下载主体页面内容,并基于jstree构建本地离线查询工具,实现无网环境下的VBA参考查阅。
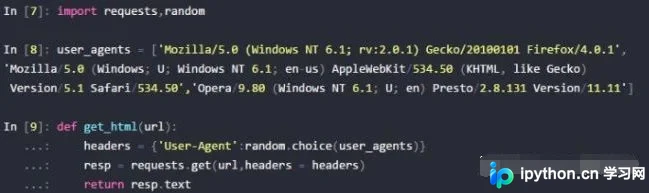
本文详解Python爬虫应对网站反爬机制的多种策略。通过随机化User-Agent、设置随机请求间隔、复用浏览器Cookie以及轮换代理IP,可有效降低被封禁风险。文中提供具体代码示例及GitHub相关项目参考,帮助开发者在大数据量爬取时保持连接稳定。
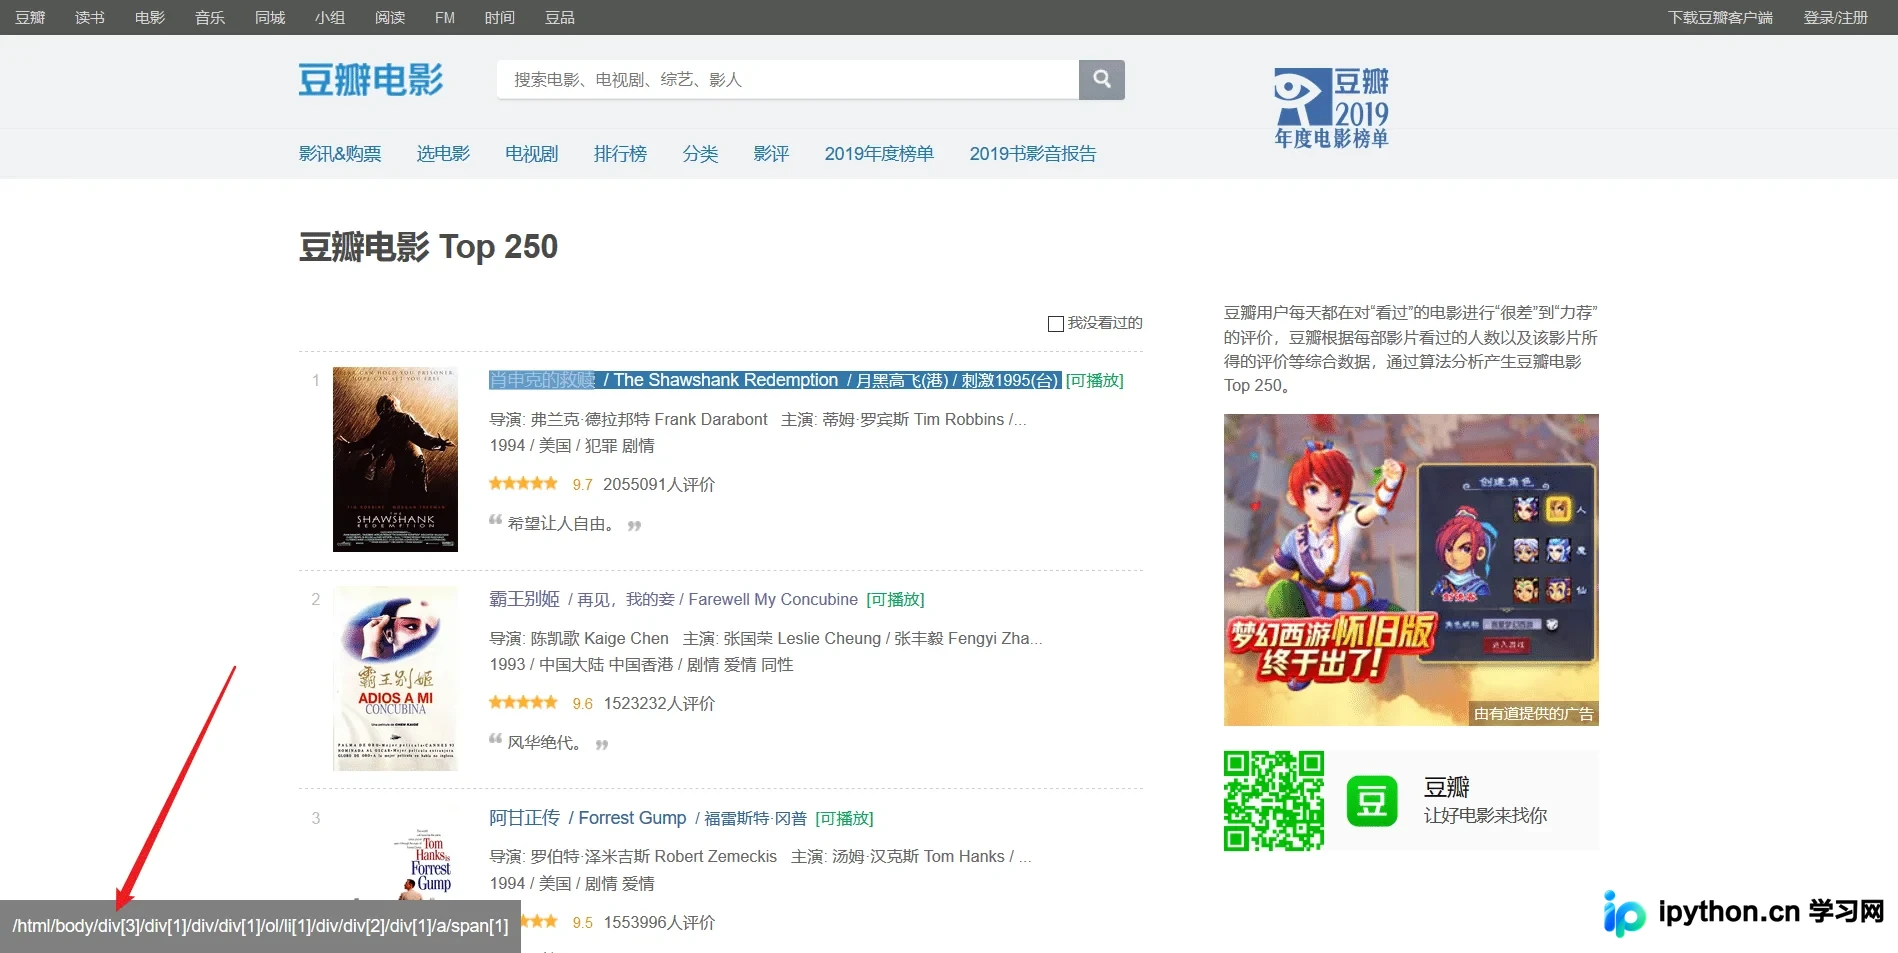
本文详解如何使用Python爬虫技术抓取豆瓣电影Top250榜单数据。通过requests库处理反爬机制,利用lxml进行XPath解析,并结合xlwt库将电影名称、评分及简介等信息批量写入Excel文件。文中包含完整的代码示例及异常处理方案,适合Python初学者参考学习。
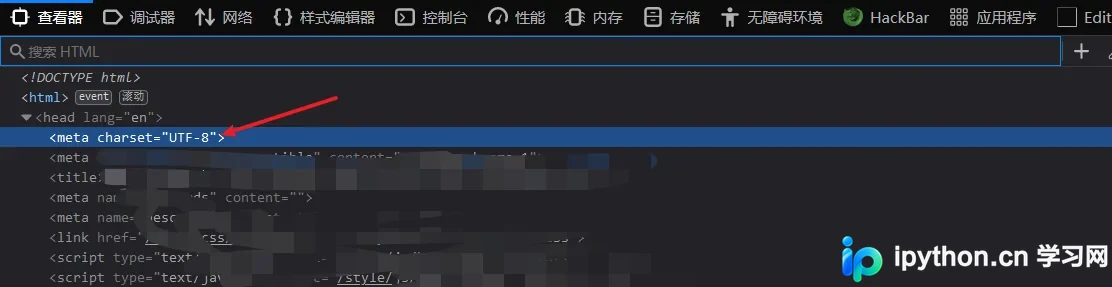
在使用Python lxml库解析HTML数据时,常因网页编码与程序解码不一致导致中文显示为乱码。本文介绍通过XPath定位节点后,利用encode('ISO-8859-1').decode('UTF-8')方法进行编码转换的技巧,有效解决数据抓取中的字符显示异常问题。
本文介绍在Python爬虫中遇到Cloudflare邮箱加密时的解决方案。通过分析前端JS代码,提取基于异或运算的解密逻辑,并使用Python的execjs库加载并调用该JS函数,成功还原加密后的邮箱地址,实现自动化采集。
本文详解Python爬虫可获取的数据类型,涵盖电商、房产、招聘及社交平台案例。针对初学者常遇的学习误区,提供从基础包使用到分布式爬虫的六步平滑学习路径,帮助零基础上手高效采集数据。
本文介绍如何使用Python网络爬虫结合BeautifulSoup库,从绿色呼吸网实时采集天气与空气质量数据。教程涵盖目标网站分析、网页源码定位、关键代码实现及异常处理机制,重点解决部分城市无污染物数据显示时的空值问题。通过PyCharm运行程序,用户可输入城市拼音获取实时AQI、首要污染物及温馨提示,实现便捷的天气信息监控。
本文详细解析Python爬虫开发中涉及的HTTP请求方法,重点对比GET与POST在参数传递、数据长度及安全性上的核心差异。通过典型请求示例,帮助开发者理解HEAD、PUT、DELETE等方法的适用场景,为构建高效稳定的网络爬虫提供基础理论支持。
本文解答Python爬虫是否容易学习的问题,解析网络爬虫的基本概念与工作原理。详细介绍企业数据、购买渠道及公开数据等来源,阐述基于URL、HTML和HTTP协议的抓取流程,并提供使用urllib库获取视频链接的Python代码示例,帮助初学者掌握基础爬虫技能。
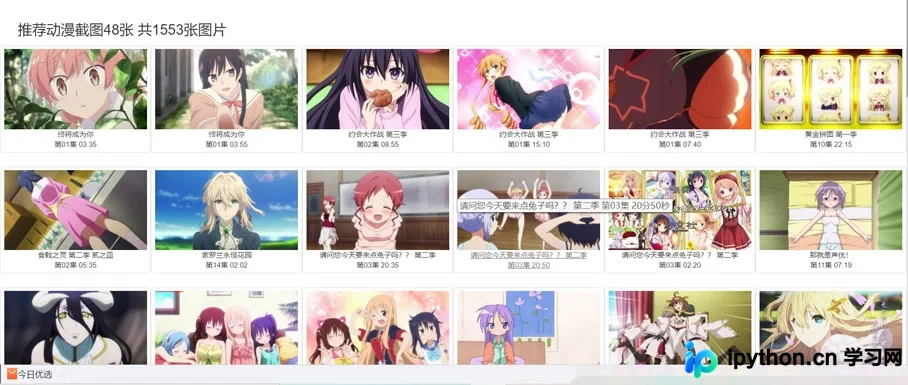
本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。
本文详细讲解Python中requests库的多种实用技巧。内容涵盖库的安装、GET与POST请求的参数及头部设置、代理IP的配置方法,以及通过获取Cookie和使用Session对象实现自动登录和状态保持。适合希望提升爬虫效率与稳定性的开发者参考。