

Python爬虫实战:详解爬取《电影天堂》3000+动作片及磁力链接下载

本文详细解析使用Python爬取《电影天堂》动作片板块的全过程。从URL结构分析、页面HTML解析到数据存储,逐步讲解如何构建爬虫程序。重点介绍利用BeautifulSoup提取电影名称与磁力链接,并通过优化代码仅保留magnet协议链接。此外,分享了结合pyperclip与迅雷实现批量下载的技巧,帮助读者掌握基础爬虫原理及实用数据处理方法。
Python爬虫入门与《电影天堂》实战概述
不知不觉,进行爬虫开发已有一个多月。
我愈发体会到,爬虫并非高深莫测的技术。其核心价值不在于使用了多么先进的框架或复杂的技术栈,而是作为一种自动化工具,能够高效获取所需数据。只要能准确获取目标数据,便是爬虫最大的价值所在。
我的爬虫课程老师常强调,学习爬虫的关键不在于掌握具体技术,因为前端技术不断演进,爬虫技术也会随之变化。更重要的是理解其核心原理,做到万变不离其宗。
爬虫的本质是为了解决实际需求,便利生活。若能在日常生活中发现并应用爬虫解决实际问题,便真正发挥了爬虫的意义。
以上仅为个人感悟。
近期因片荒,难以找到合适的电影资源,且部分电影在网上久寻不得。偶然了解到《电影天堂》网站,发现其中收录了大量优质电影资源(此处暂不讨论其来源的合规性)。
因此,本次目标网站确定为《电影天堂》,旨在囤积电影资源,供闲暇时观看消遣。
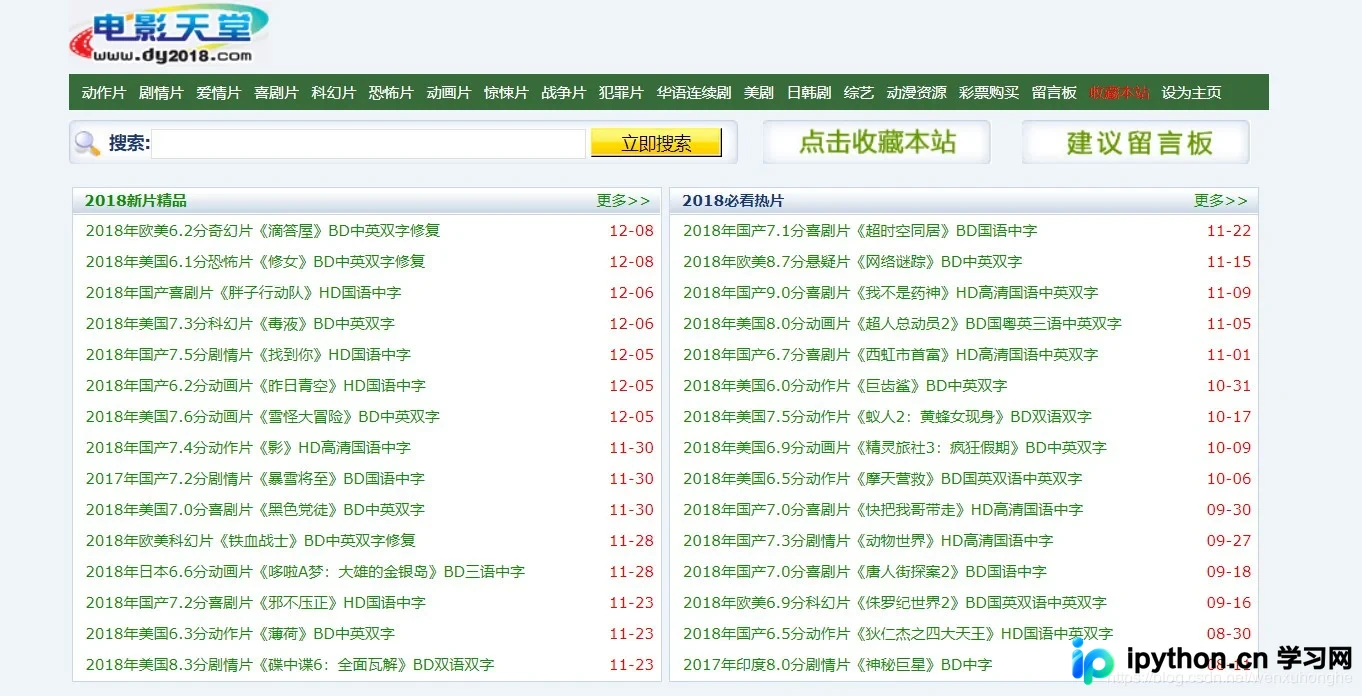
从技术角度看,该网站爬取难度较低,甚至可称为简单。但其实用性极强:早晨运行爬虫,晚间即可在硬盘中收获数十部最新大片,疲惫一天后躺在床上观影,体验极佳。
鉴于该爬虫较为简单,本文将尽量详尽地讲解,力求让Python初学者也能看懂,并能在此基础上修改,应用于爬取该网站其他板块或其他电影网站。
爬虫原理与思路梳理
写在前面的话
在编写代码前,先梳理整体思路。
- 爬虫的基本原理是:通过给定的URL(即网址,如 http://www.baidu.com )发起请求,访问网页并获取其源代码(即右键查看网页源代码时看到的大量代码),返回数据。
- 随后,利用特定手段(如json库、BeautifulSoup库、正则表达式等)从网页源代码中筛选出目标数据。前提是需分析网页结构,明确所需数据及其在HTML中的位置与特征。
- 最后,将获取的数据按特定格式存储至本地文件或数据库中,即完成爬虫的全部工作。
此外,还有一些进阶技巧:若嫌效率低,可开启多线程(相当于多只爬虫同时工作,效率提升数十倍);若担心频率过高被封IP,可使用IP代理(隐藏真实身份,模拟正常用户);若网站有反爬机制,也有相应策略绕过(颇具黑客攻防色彩)。这些属于后续优化内容。
《电影天堂》网站结构分析与URL构造
爬虫部分
一、分析网站结构(以动作片电影为例)
1. 分析网页的 URL 的组成结构
首先,需分析URL的组成结构,重点关注两方面:如何切换电影类型,以及如何翻页。
点击网页上的电影类型按钮,观察地址栏URL,发现网址与电影类型的对应关系如下:
| 电影类型 | 网址 |
| 剧情片 | https://www.dy2018.com/0/ |
| 喜剧片 | https://www.dy2018.com/1/ |
| 动作片 | https://www.dy2018.com/2/ |
| 爱情片 | https://www.dy2018.com/3/ |
| 科幻片 | https://www.dy2018.com/4/ |
| 动画片 | https://www.dy2018.com/5/ |
| 悬疑片 | https://www.dy2018.com/6/ |
| 惊悚片 | https://www.dy2018.com/7/ |
| 恐怖片 | https://www.dy2018.com/8/ |
| 记录片 | https://www.dy2018.com/9/ |
| ...... | ...... |
| 灾难片 | https://www.dy2018.com/18/ |
| 武侠片 | https://www.dy2018.com/19/ |
| 古装片 | https://www.dy2018.com/20/ |
规律已现:若想爬取其他类型电影,只需改变URL中的数字即可。甚至可编写循环,爬取所有板块的电影。
随意打开一个分类,滚动至页面底部,可见翻页按钮。点击翻页时,观察URL的变化。
| 页码 | URL |
| 第一页 | https://www.dy2018.com/2/index.html |
| 第二页 | https://www.dy2018.com/2/index_2.html |
| 第三页 | https://www.dy2018.com/2/index_3.html |
| 第四页 | https://www.dy2018.com/2/index_4.html |
除第一页为「index」外,其余页码均为「index_页码」的形式。
至此,基本掌握了网站URL的构成形式,可通过构造URL访问任意类型电影的任意一页。
2. 分析网站的页面结构
其次,分析网站页面结构,确定所需数据在网页中的位置(需明确所需数据)。由于目的是下载电影,故仅需两个数据:电影名称和下载磁力链接。
按F12打开开发者工具(可快速定位网页元素在HTML源代码中的位置)。
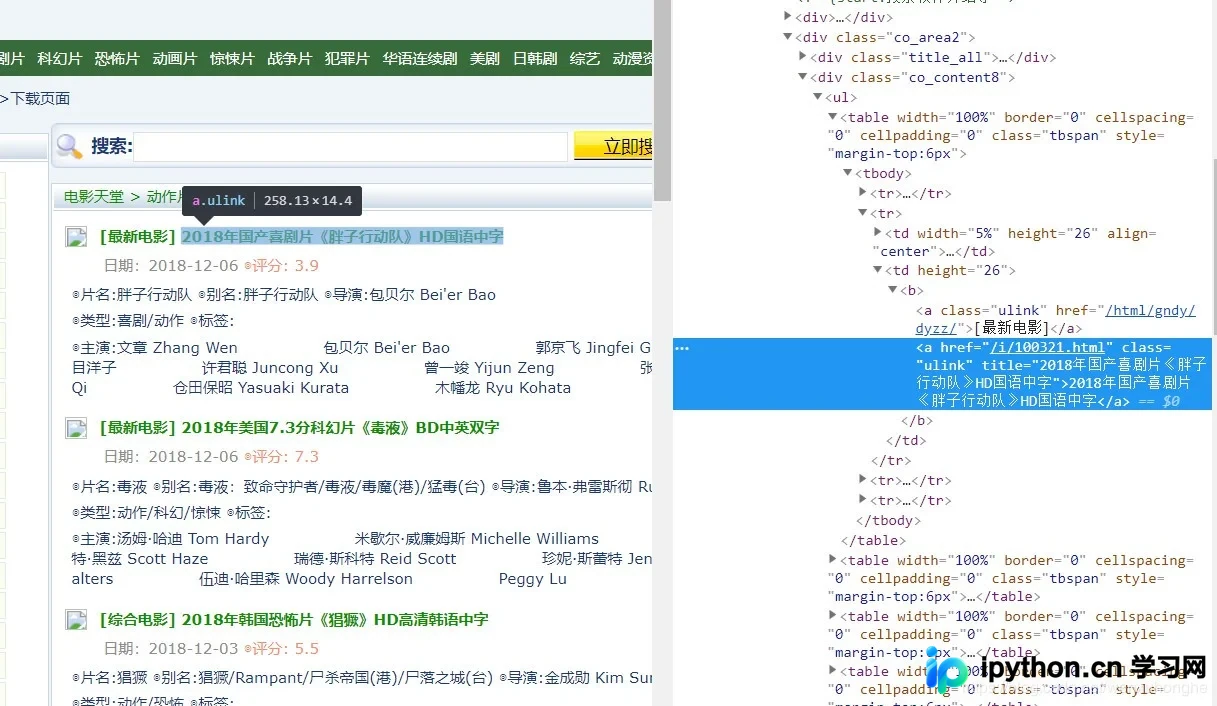
观察发现,电影列表中,每部电影信息存放于一个<table>标签内,电影名称位于其中的<a>标签中。电影下载的磁力链接位于电影详情页面,而详情页面的网址也包含在该<a>标签的href属性值中。
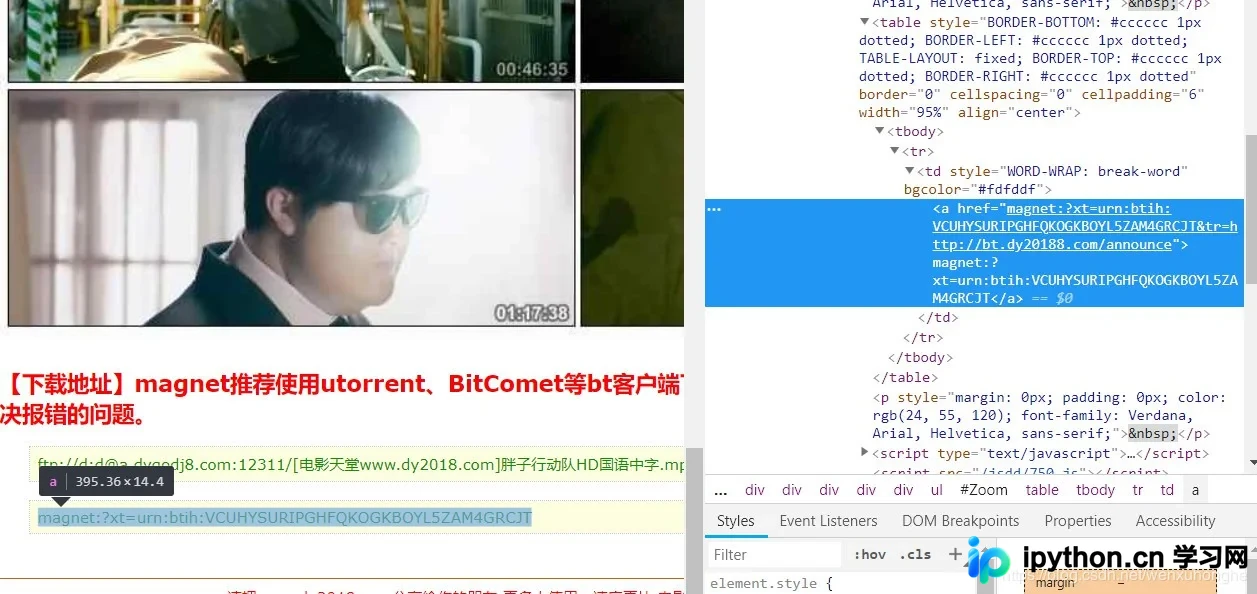
下载的磁力链接则存放于<tbody>标签下的<a>标签中,位置清晰。
最后梳理思路:通过前述URL构造规则,访问网站某一页,获取该页面所有<table>标签(存放电影数据),从每个<table>中找到存有电影名称的<a>标签(获取电影名称及详情页面网址),通过该网址访问电影详情页面,在详情页面中选取<tbody>标签下的<a>标签(获取下载链接),从而找到全部所需数据。
Python爬虫程序架构与编码实现
二、爬虫编码阶段
爬虫程序通常分为五个部分:一是主函数,作为程序入口;二是爬虫调度器;三是网络请求函数;四是网页解析函数;五是数据存储函数。
- get_data:参数为目标网页URL,该函数模拟浏览器访问URL,获取并返回网页内容。
- parse_data:参数为网页内容,主要用于解析网页内容,筛选提取关键信息,并打包成列表返回。
- save_data:参数为数据列表,用于将列表中的数据写入本地文件。
- main:该函数为爬虫调度器,可根据事先分析的URL规则,不断构造新的请求URL,并调用其他三个函数,获取数据并保存至本地,直至结束。
- if __name__ == '__main__':这是主程序的入口,在此调用main函数,启动爬虫调度器即可。
# 我们用到的库
import requests
import bs4
import re
import pandas as pd
1. 网络请求函数 :get_data (url)
负责访问指定的URL网页,并将网页内容返回。此部分功能较为固定,一般无需修改(除非需使用代理或自定义请求头等,可作相应调整)。
def get_data(url):
  '''
  功能:访问 url 的网页,获取网页内容并返回
  参数:
    url :目标网页的 url
  返回:目标网页的 html 内容
  '''
  headers = {
    'accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8',
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36',
  }

  try:
    r = requests.get(url, headers=headers)
    r.raise_for_status()
    return r.text

  except requests.HTTPError as e:
    print(e)
    print("HTTPError")
  except requests.RequestException as e:
    print(e)
  except:
    print("Unknown Error !")
2. 网页解析函数:parse_data(html)
该函数是整个爬虫程序的核心,整体思路在前一部分已讲解。此处使用的库为BeautifulSoup。
此部分的写法多种多样,发挥空间大,无固定模式。因写法需随不同网站页面结构调整:如有的网站提供数据API接口,返回JSON格式数据,只需调用json库即可完成解析;而大部分网站需从网页源代码中层层筛选(筛选手段多样,如正则表达式、BeautifulSoup等)。
此处需根据数据形式选择不同筛选策略,故了解原理即可,习惯何种方法便使用何种方法,最终能获取数据即可。
def parse_data(html):
  '''
  功能:提取 html 页面信息中的关键信息,并整合一个数组并返回
  参数:html 根据 url 获取到的网页内容
  返回:存储有 html 中提取出的关键信息的数组
  '''
  bsobj = bs4.BeautifulSoup(html,'html.parser')
  info = []

  # 获取电影列表
  tbList = bsobj.find_all('table', attrs = {'class': 'tbspan'})

  # 对电影列表中的每一部电影单独处理
  for item in tbList:

    movie = []
    link = item.b.find_all('a')[1]

    # 获取电影的名称
    name = link["title"]

    # 获取详情页面的 url
    url = 'https://www.dy2018.com' + link["href"]

    # 将数据存放到电影信息列表里
    movie.append(name)
    movie.append(url)

    try:
      # 访问电影的详情页面,查找电影下载的磁力链接
      temp = bs4.BeautifulSoup(get_data(url),'html.parser')
      tbody = temp.find_all('tbody')

      # 下载链接有多个(也可能没有),这里将所有链接都放进来
      for i in tbody:
        download = i.a.text
        movie.append(download)

      #print(movie)

      # 将此电影的信息加入到电影列表中
      info.append(movie)

    except Exception as e:
      print(e)

  return info
3. 数据存储函数:save_data(data)
该函数旨在将数据存储至本地文件或数据库,具体写法依实际存储形式而定。此处将数据存储于本地CSV文件中。
当然,此函数也可执行其他操作,如简单的数据处理:数据清洗、数据去重等。
def save_data(data):
  '''
  功能:将 data 中的信息输出到文件中/或数据库中。
  参数:data 将要保存的数据
  '''
  filename = 'Data/电影天堂/动作片.csv'

  dataframe = pd.DataFrame(data)
  dataframe.to_csv(filename, mode='a', index=False, sep=',', header=False)
4. 爬虫调度器:main()
该函数负责根据URL生成规则,构造新的URL请求,然后依次调用网络请求函数、网页解析函数、数据存储函数,爬取并保存该页数据。
所谓爬虫调度器,即控制爬虫何时开始爬、多少只爬虫同时爬、爬哪个网页、爬多久休息一次等事宜。
def main():
  # 循环爬取多页数据
  for page in range(1, 114):
    print('正在爬取:第' + str(page) + '页......')
    # 根据之前分析的 URL 的组成结构,构造新的 url
    if page == 1:
      index = 'index'
    else:
      index = 'index_' + str(page)
    url = 'https://www.dy2018.com/2/'+ index +'.html'
    # 依次调用网络请求函数,网页解析函数,数据存储函数,爬取并保存该页数据
    html = get_data(url)
    movies = parse_data(html)
    save_data(movies)

    print('第' + str(page) + '页完成!')
5. 主函数:程序入口
主函数作为程序入口,仅负责启动爬虫调度器。
此处习惯在main()函数前后输出语句,以此判断爬虫程序是否正常启动和结束。
if __name__ == '__main__':
  print('爬虫启动成功!')
  main()
  print('爬虫执行完毕!')
程序运行结果与磁力链接下载优化技巧
三、程序运行结果
运行约两小时后,终于爬完113页,共3346部动作片电影的数据(实际数量不止这些,但因部分电影未提供下载链接,在Excel中排序后手动剔除了)。
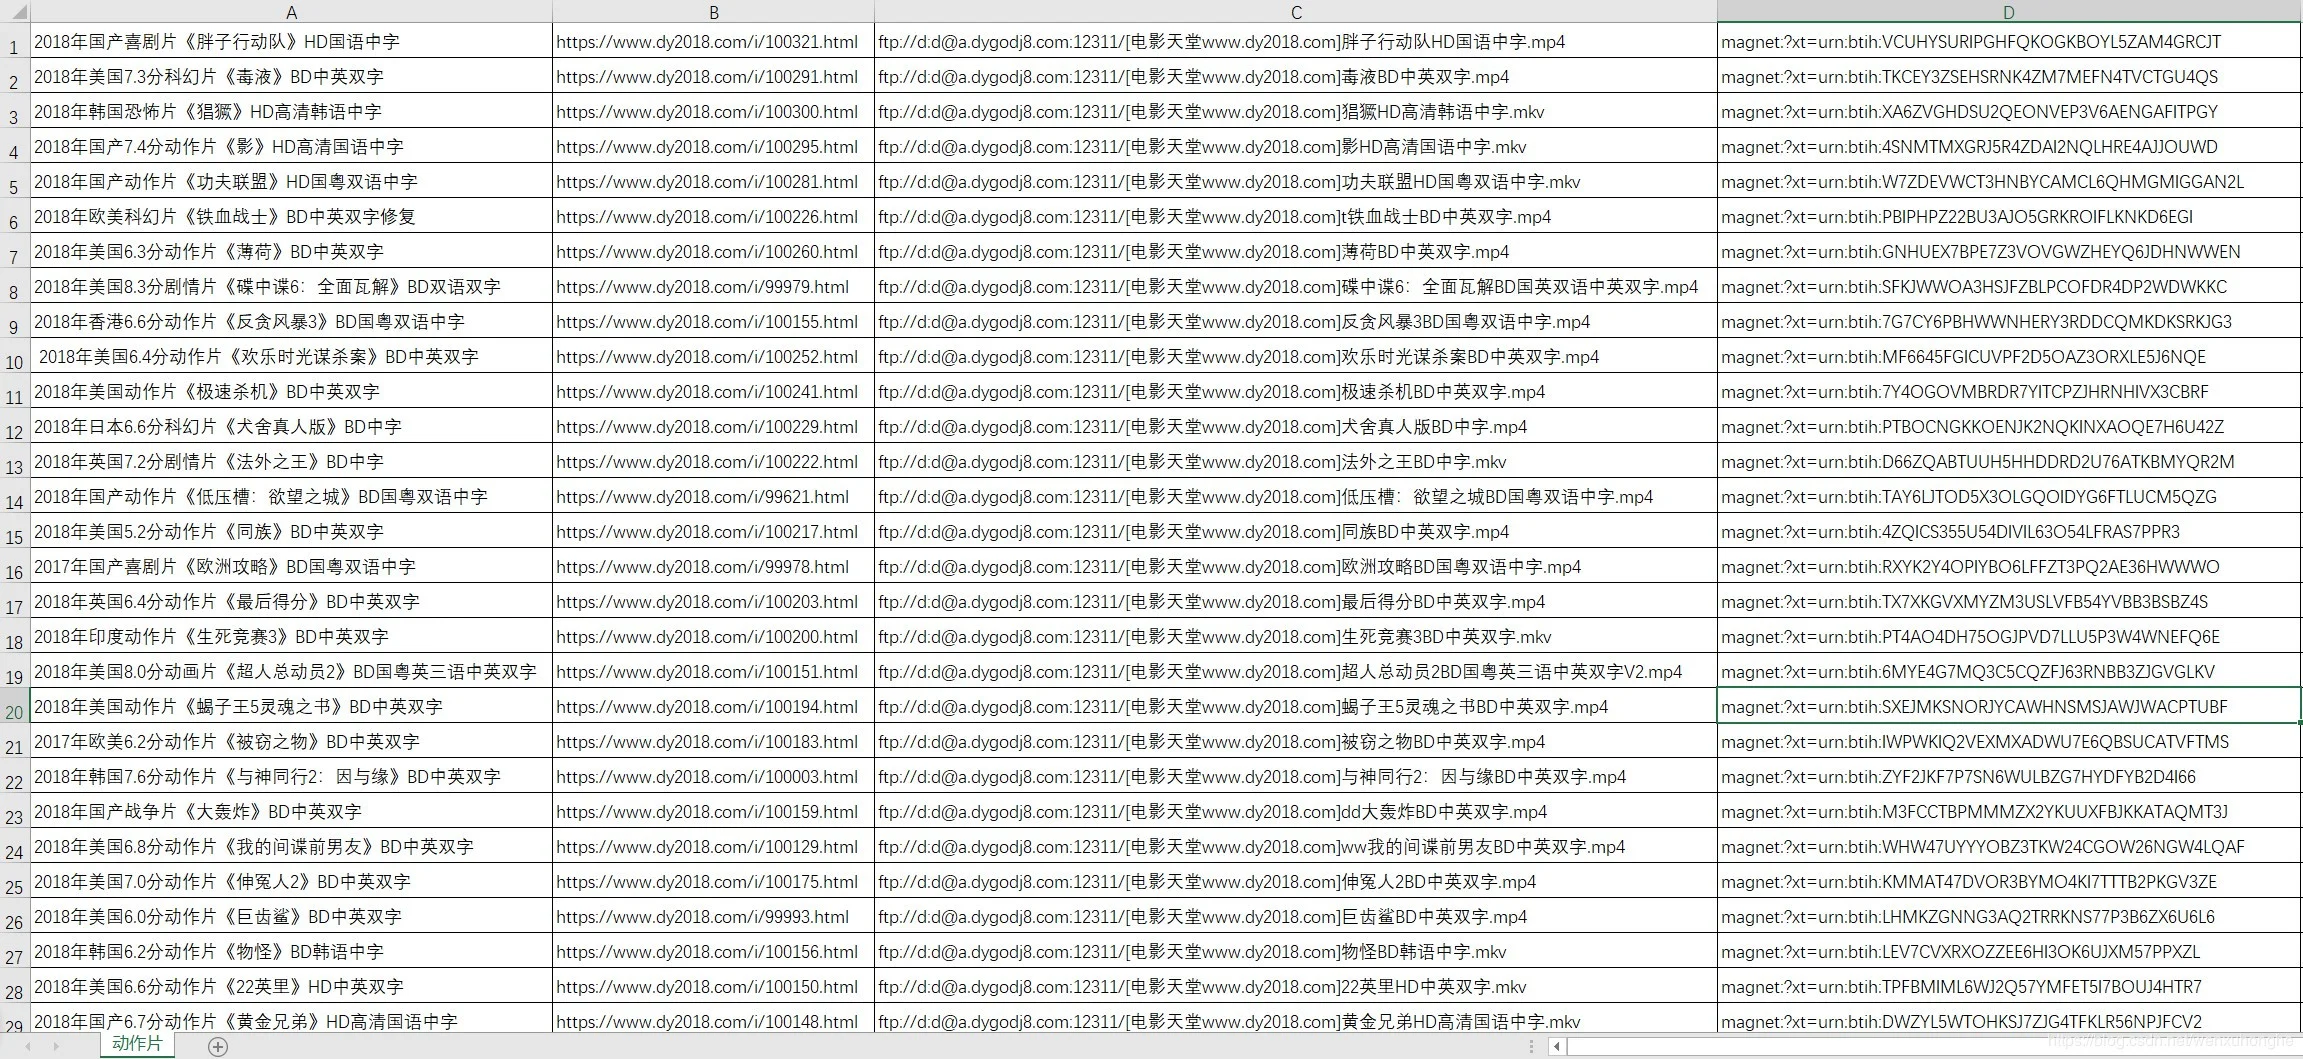
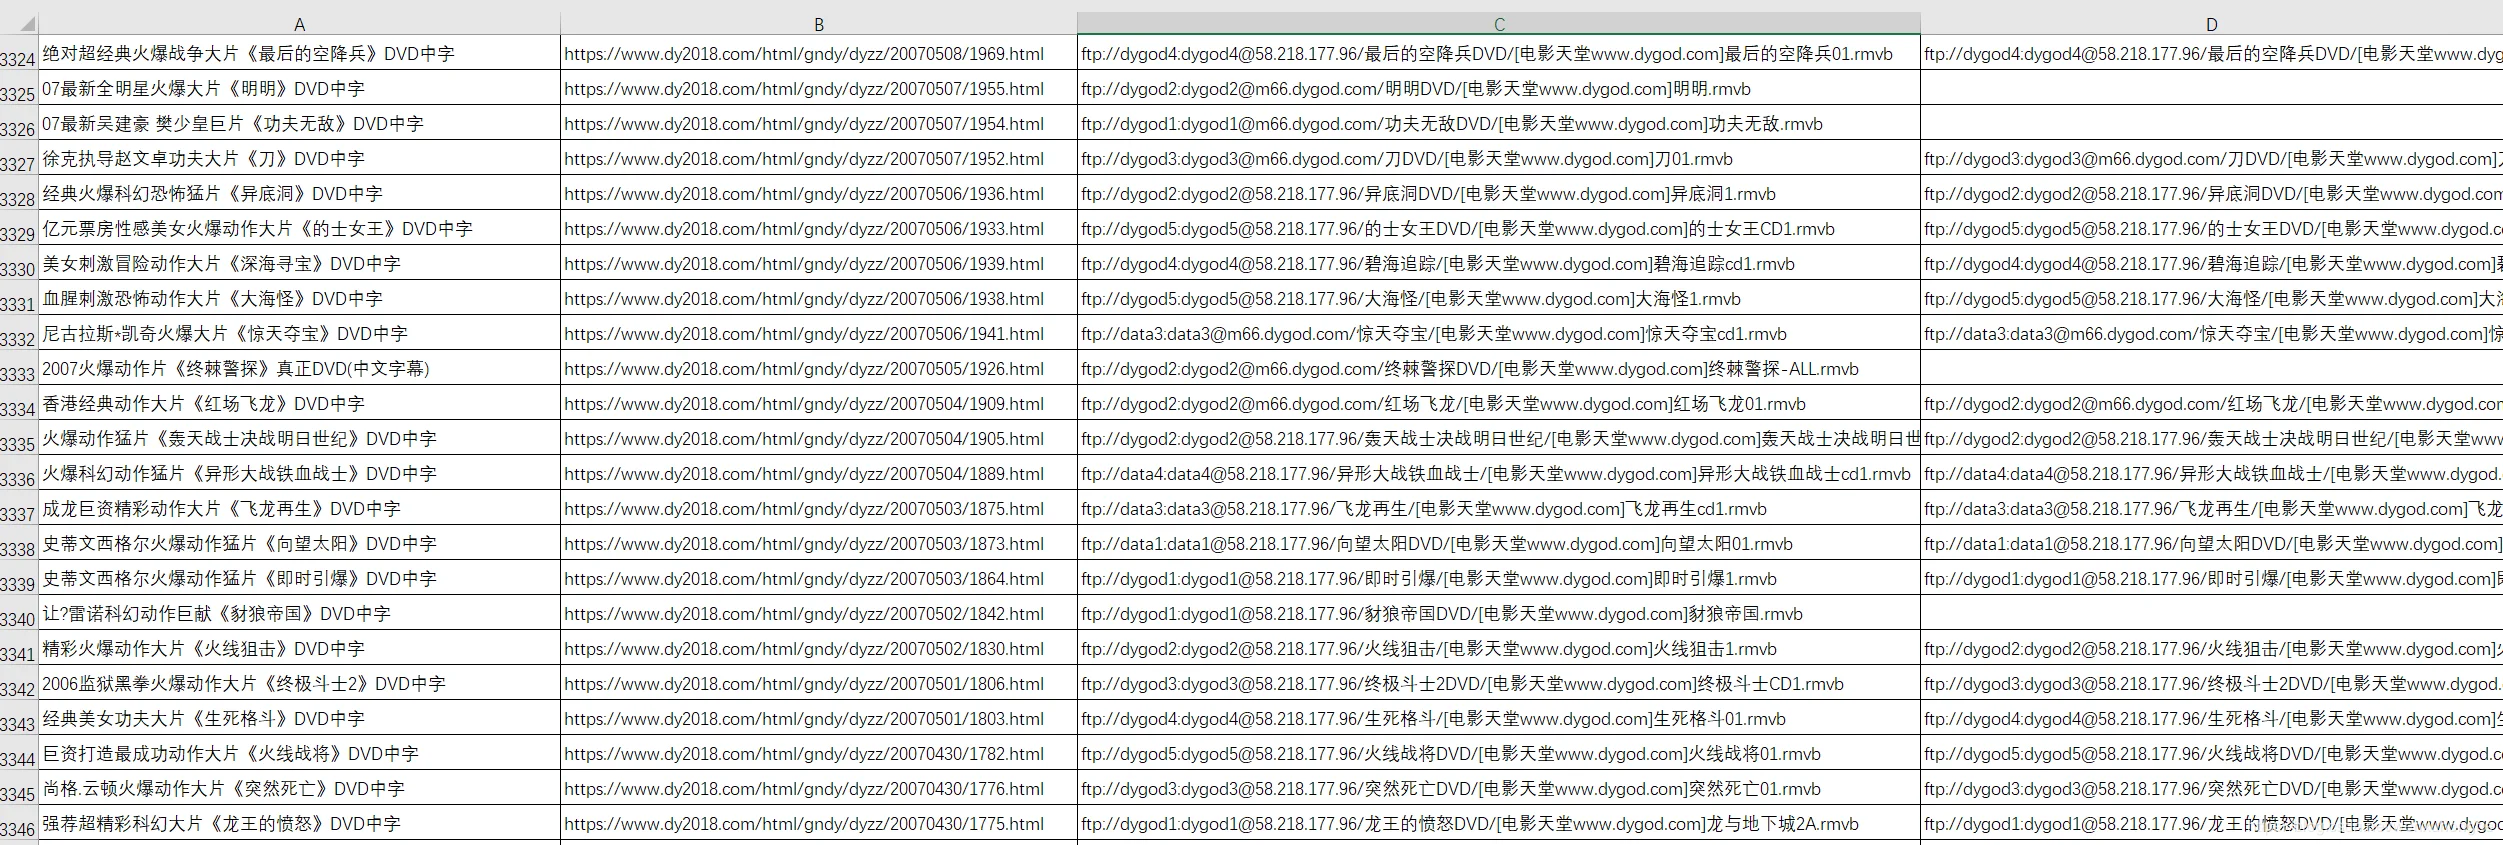
若想看某部电影,直接复制这些电影下载的磁力链接,至迅雷中下载即可。
四、爬虫程序的一些小优化
1. 在网站提供的下载链接中,经测试发现,以magnet开头的链接在迅雷中可直接下载,而以ftp开头的链接在迅雷中总显示资源获取失败(不知是否打开方式有误,反正无法下载)。因此,对程序进行了一些小调整,使其仅获取magnet类链接。
修改方式很简单,只需调整网页解析函数即可(爬虫的五个部分相对独立,修改时只需调整相应模块,其余部分无需修改)。
def parse_data(html):
  '''
  功能:提取 html 页面信息中的关键信息,并整合一个数组并返回
  参数:html 根据 url 获取到的网页内容
  返回:存储有 html 中提取出的关键信息的数组
  '''
  bsobj = bs4.BeautifulSoup(html,'html.parser')
  info = []

  # 获取表头信息
  tbList = bsobj.find_all('table', attrs = {'class': 'tbspan'})

  for item in tbList:
    movie = []
    link = item.b.find_all('a')[1]
    name = link["title"]
    url = 'https://www.dy2018.com' + link["href"]

    try:
      # 查找电影下载的磁力链接
      temp = bs4.BeautifulSoup(get_data(url),'html.parser')
      tbody = temp.find_all('tbody')

      for i in tbody:
        download = i.a.text
        if 'magnet:?xt=urn:btih' in download:
          movie.append(name)
          movie.append(url)
          movie.append(download)
          #print(movie)
          info.append(movie)
          break
    except Exception as e:
      print(e)

  return info
注意代码第26行处,增加了一个if语句判断:若下载链接中包含magnet:?xt=urn:btih字符串,则视为有效链接并下载,否则跳过。
2. 一直思考能否有办法让迅雷一键批量下载爬到的电影。使用Python操纵第三方软件其实较难。不过后来找到一种方法,也算解决了该问题。
我们发现迅雷软件启动后,会自动检测剪切板。只要复制下载链接,它便会自动弹出下载提示框。借助此思路,可使用代码将下载链接复制至剪切板,待下载框自动出现后,手动确认开始下载(这是我目前想到的最佳方案,不知各位大佬是否有更好思路,欢迎指导交流)。
import pyperclip
import os
import pandas as pd

imageData = pd.read_csv("Data/电影天堂/动作片2.csv",names=['name','link','download'],encoding = 'gbk')
# 获取电影的下载链接,并用换行符分隔
a_link = imageData['download']
links = '\n'.join(a_link)

# 复制到剪切板
pyperclip.copy(links);
print('已粘贴');

# 打开迅雷
thunder_path = r'D:\Program Files (x86)\Thunder Network\Thunder9\Program\Thunder.exe'
os.startfile(thunder_path)
亲测可行,但……不建议尝试(你能想象迅雷打开瞬间创建几百个下载任务的场景吗?我的电脑缓了好久才反应过来)。大家还是老老实实手动复制链接下载吧(CSV文件可用Excel打开,竖着选中一列,然后复制,也能达到相同效果)。这种“骚操作”太蠢,还是不要试了。
总结与Scrapy框架启示
写在后面的话
啰嗦地写了许多,不知关键问题是否讲清楚。若有未讲清或不合适之处,欢迎交流。 其实,写文章、博客、教程,都是一个知识重新熔炼内化的过程。在撰写这篇博客时,我也反复审视学习爬虫的过程,以及代码一步步的变化:从最初所有代码揉在主函数中,到后来将变动较少的功能提取出来写成单独函数,再到后来形成基本稳定的五大部分。
以至于后来学习使用Scrapy框架时,惊人地发现Scrapy框架的结构与我的爬虫结构有着异曲同工之妙。我的这个相当于是一个简易版爬虫框架,纯靠自己摸索达到此效果,感觉挺有成就感。
以上所述是小编给大家介绍的Python爬取并下载《电影天堂》3千多部电影详解整合,希望对大家有所帮助。如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









