

Python爬虫使用代理IP的实现
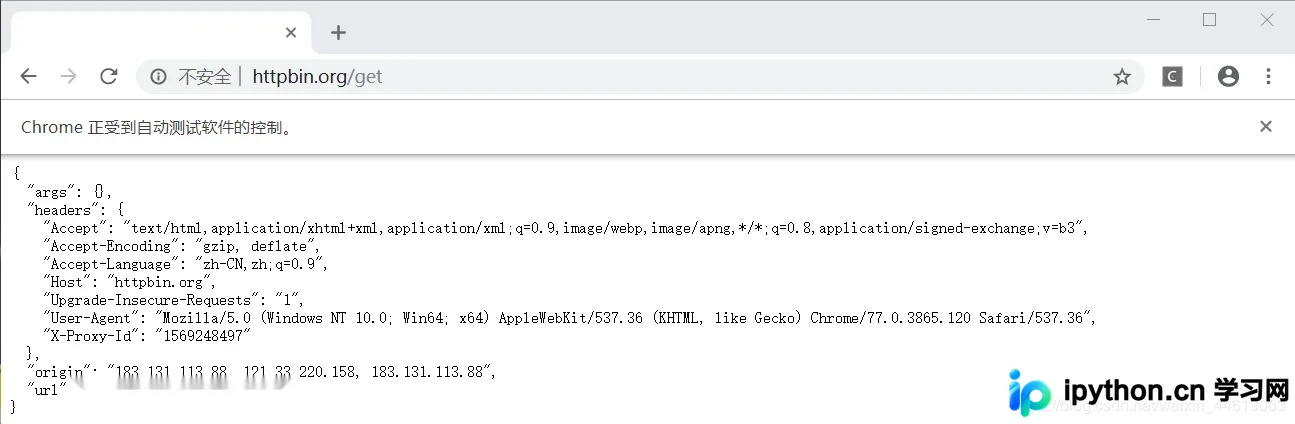
本文详解Python爬虫中代理IP的配置方法,涵盖Urllib、Requests及Selenium三种主流库的代理设置。通过搭建代理池接口获取IP,并结合httpbin.org验证IP伪装效果,帮助开发者解决IP被封禁问题,提升爬虫稳定性与效率。
2026-10-13
5

本文详解Python爬虫中代理IP的配置方法,涵盖Urllib、Requests及Selenium三种主流库的代理设置。通过搭建代理池接口获取IP,并结合httpbin.org验证IP伪装效果,帮助开发者解决IP被封禁问题,提升爬虫稳定性与效率。
本文详细介绍如何在Python中利用Selenium配合Headless Chrome进行网页内容抓取。文章涵盖Chrome及Chrome Driver的安装配置,解决国内源安装问题,并提供完整的Python代码示例,包括无头模式启动、页面加载超时设置及元素提取方法,适用于Linux环境下的自动化数据采集场景。
本文详解Python爬虫中多线程的使用,重点介绍如何利用标准库Queue解决线程间数据共享与交换的安全性问题。通过糗百图片抓取的实战案例,展示如何构建URL队列、启动多线程并发请求,并控制线程数量以优化抓取速度,确保数据一致性与程序稳定性。
本文详细解析如何使用Python的requests库进行网页请求,结合BeautifulSoup解析HTML结构,从图灵网抓取图书列表并提取详情页链接。文章通过具体代码示例,演示了如何从列表页解析链接,并从详情页提取书名、定价及电子书价格等关键信息,提供了完整的爬虫实现思路与代码片段。
本文详细介绍如何使用Python结合BeautifulSoup4库爬取名言网top10标签下的名言数据,并将包含名言、作者及标签的信息存储至MySQL数据库。代码涵盖网页解析、分页处理及数据库插入操作,适合Python初学者参考学习。
本文详解如何使用Python抓取猫眼电影TOP100榜单及电影天堂数据,涵盖静态页面分析、正则表达式提取、User-Agent随机切换及编码处理技巧。重点演示将爬取数据持久化存储至本地CSV文件、MySQL数据库(使用pymysql及executemany批量插入)及MongoDB的具体实现,并提供完整的代码框架与SQL查询示例。
本文介绍如何使用Selenium结合PhantomJS模拟浏览器行为,以绕过豆瓣读书严格的反爬机制。针对直接请求导致的数据缺失和报错问题,通过模拟浏览器加载获取完整页面信息,并解析存储书籍数据。
本文介绍如何使用Python3编写爬虫程序,自动抓取酷狗音乐TOP500榜单中的排名、歌曲名及时长信息。通过构造分页URL批量获取数据,并利用MongoDB数据库进行持久化存储,实现自动化数据采集与保存。
本文探讨Python爬虫中URL包含字典或列表等非字符串参数时的编码问题。通过对比直接urlencode与先进行json序列化再urlencode两种方法,展示Python2环境下生成的URL差异,并建议当直接编码导致访问失败时,采用json序列化方式以确保参数正确解析。
本文详解Python爬虫中urllib模块处理URL编码的方法。针对包含非ASCII字符(如中文)的URL,直接请求会引发UnicodeEncodeError。通过urllib.parse.quote函数对特殊字符进行ASCII编码并拼接,可生成有效URL,确保爬虫程序正常发起请求并获取页面数据。
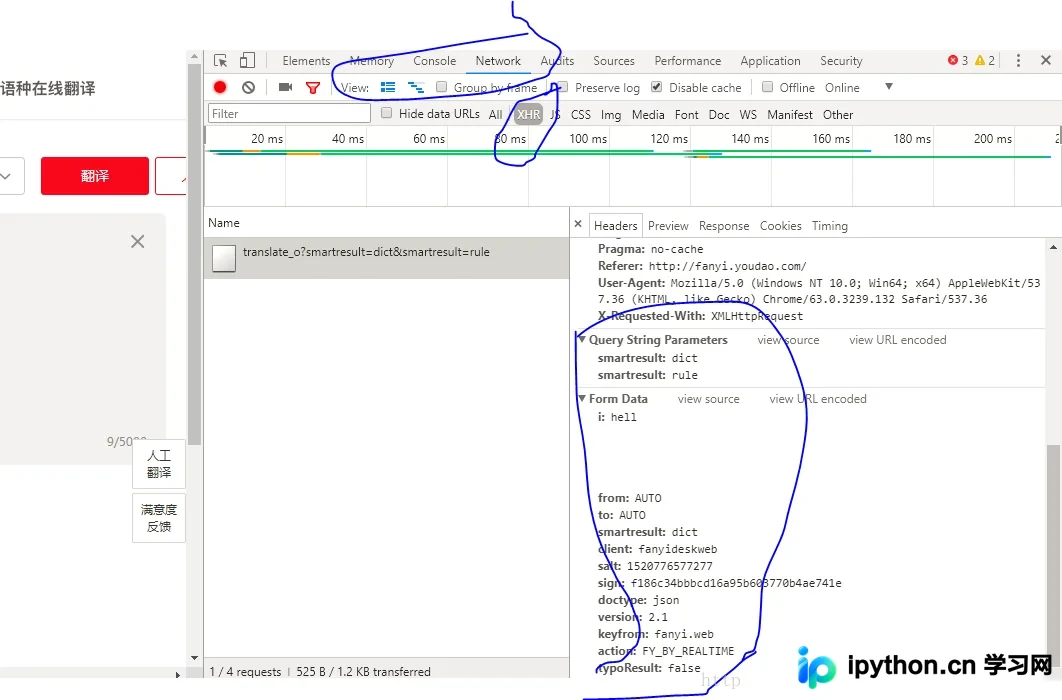
本文详细解析如何使用Python3的urllib库破解有道翻译接口的反爬虫机制。通过抓包分析定位加密参数,逆向JS源码获取sign生成算法(含salt、sign、client等变量),并模拟浏览器请求头(User-Agent、Referer、Cookie),最终实现成功调用接口获取翻译结果。
本文介绍如何在Python爬虫项目中实现中断重连与断点续爬功能,以应对网站验证或IP封禁导致的程序中断。通过维护新URL与已爬取URL集合,并将数据持久化至文件,避免内存溢出。文中提供了基于文件操作的URL管理器类及获取最后一行数据的详细代码实现,帮助开发者快速集成该功能。