

Python实战:模拟浏览器行为爬取高清壁纸详解

本文详解使用Python爬取高清壁纸的完整流程。通过模拟人工浏览步骤,包括访问列表页、解析源码获取子页面链接、进入详情页选择分辨率及最终下载图片,实现自动化批量获取。文中结合具体案例与代码注释,解析如何构造请求地址及处理中间链接,帮助开发者掌握静态网页图片抓取的核心技巧。
爬虫设计思路与人工操作模拟
前言
在构建爬虫项目之初,首要任务是厘清人工浏览网页获取图片时的具体操作步骤。
通常情况下,从网站批量获取壁纸的操作流程如下:
第一步,访问壁纸所在的网页地址。
第二步,点击目标壁纸图片,进入该壁纸的专属展示页面。
第三步,在详情页中选择所需的图片分辨率,以确保获取高清版本。
第四步,执行保存操作,将图片存储至本地。
在实际操作中,我们需要模拟上述流程:首先访问壁纸列表页,接着点击缩略图进入详情页,随后在详情页中选择分辨率并点击,从而跳转至最终包含图片下载链接的页面,最后完成图片保存。
在爬虫开发中,我们通过模拟浏览器的一系列操作,逐步访问各个页面,最终获取目标图片的直接下载地址,并将图片下载保存至指定的本地路径。
*在此过程中,部分中间页面的筛选条件构造较为复杂,需要打开对应页面的源代码,仔细查找包含目标链接的HTML标签。
Python爬虫代码实现与解析
具体实现项目与代码注释
本例旨在获取特定类型的图片。我在网页中搜索关键词“长门有希”,并打开一个搜索结果页面。观察发现,该列表页已包含其他同类型壁纸的链接,因此我将初始访问的目标地址直接设定为这个搜索结果页面,以提高效率。
目标结果页面截图:
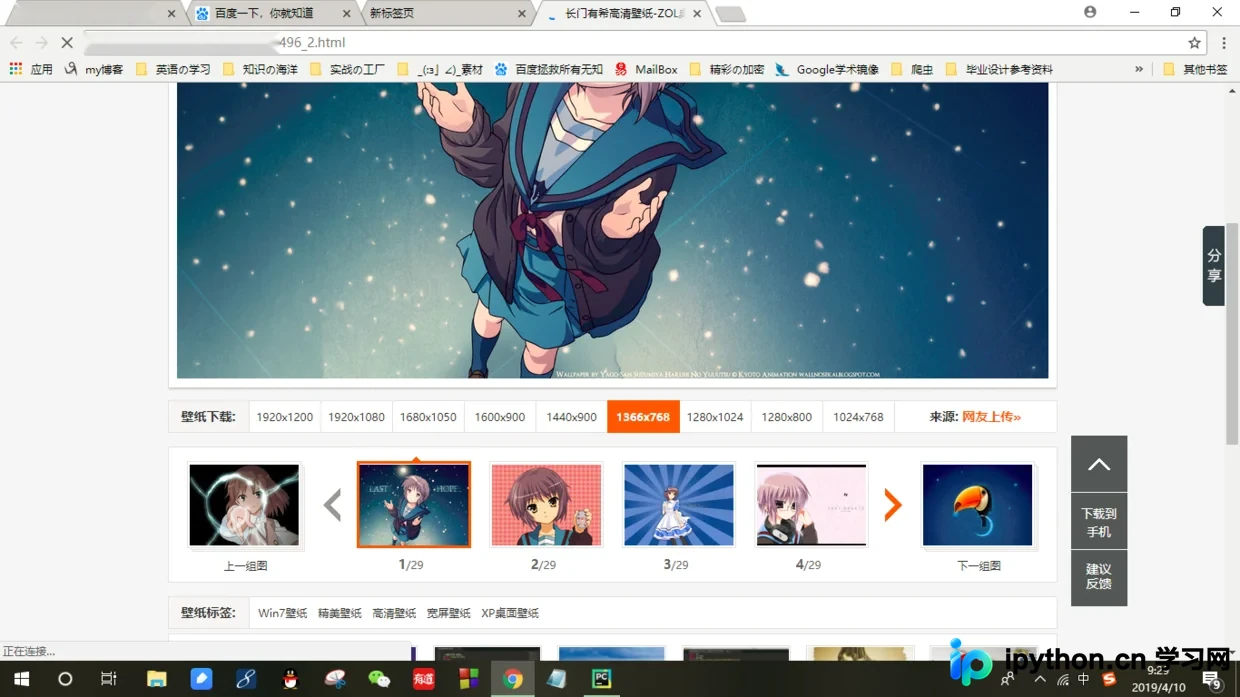
图中显示页码标记如“1/29”、“2/29”,代表存在其他同类型的目标壁纸。通过点击这些图片,可以打开新的目标下载页面。
接下来,我们查看该页面的网页源代码。
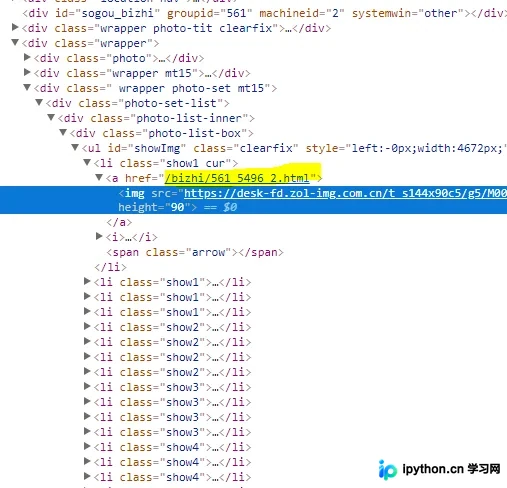
源码中黄色高亮部分即为打开同类壁纸的目标地址。注意,在发起访问请求时,需要在原始链接前加上前缀“http://desk.zol.com.cn”。
基于上述分析,我们开始构建爬虫逻辑:
流程为:访问指定页面 → 筛选并提取所有“长门有希”壁纸的目标下载页面链接。
相关实现代码如下:
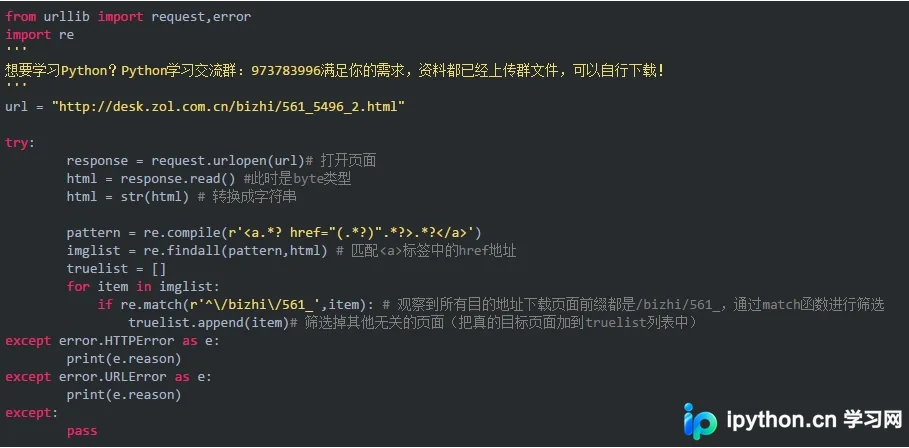
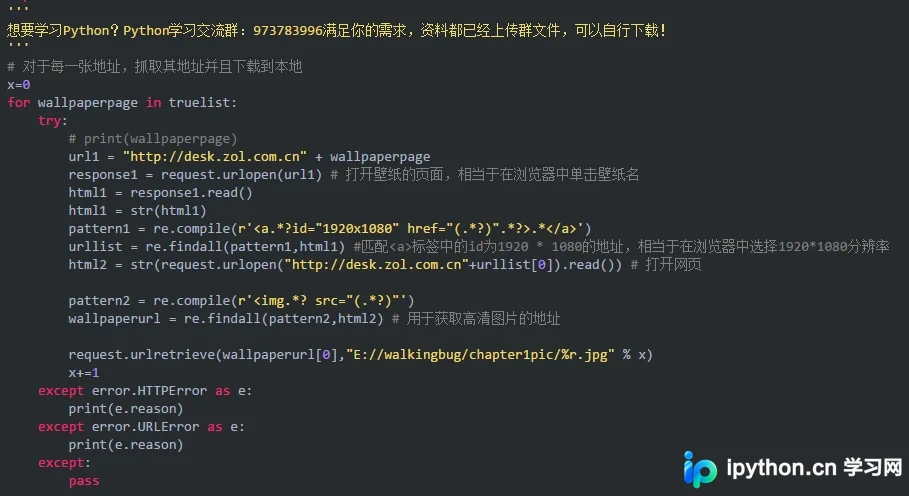
获取到链接后,程序逻辑为:遍历地址 → 打开指定页面 → 选择分辨率 → 获取最终目的下载地址 → 将图片保存至本地指定路径。
在测试阶段,我输出了上一步代码中truelist变量保存的内容。
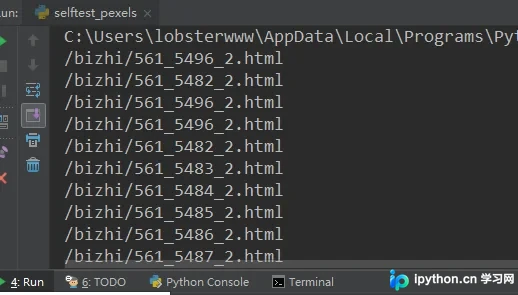
从输出结果可见,保存的仅为图片后缀部分。在实际访问时,我们需要拼接一个指定的前缀以构成完整URL。
具体实现代码如下(详细注释见代码块):
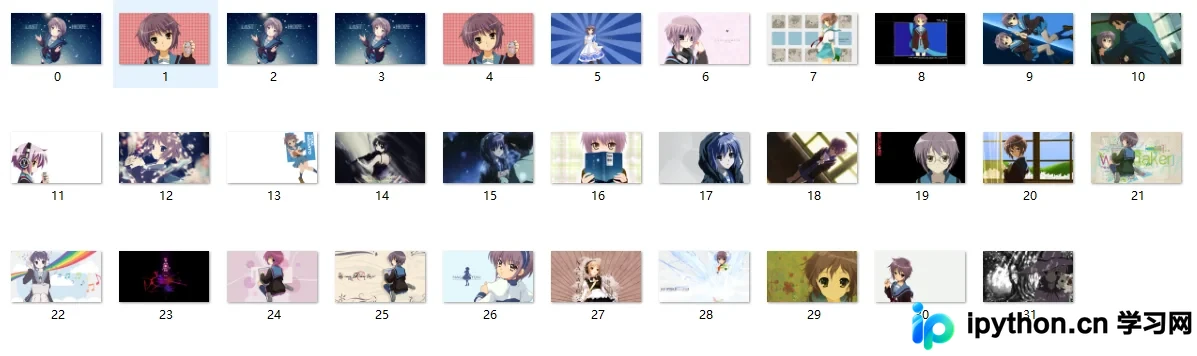
执行完毕后,可以在目标文件夹中看到成功爬取下来的图片集合。
以上所述是小编给大家介绍的Python爬取高清壁纸详解整合,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









