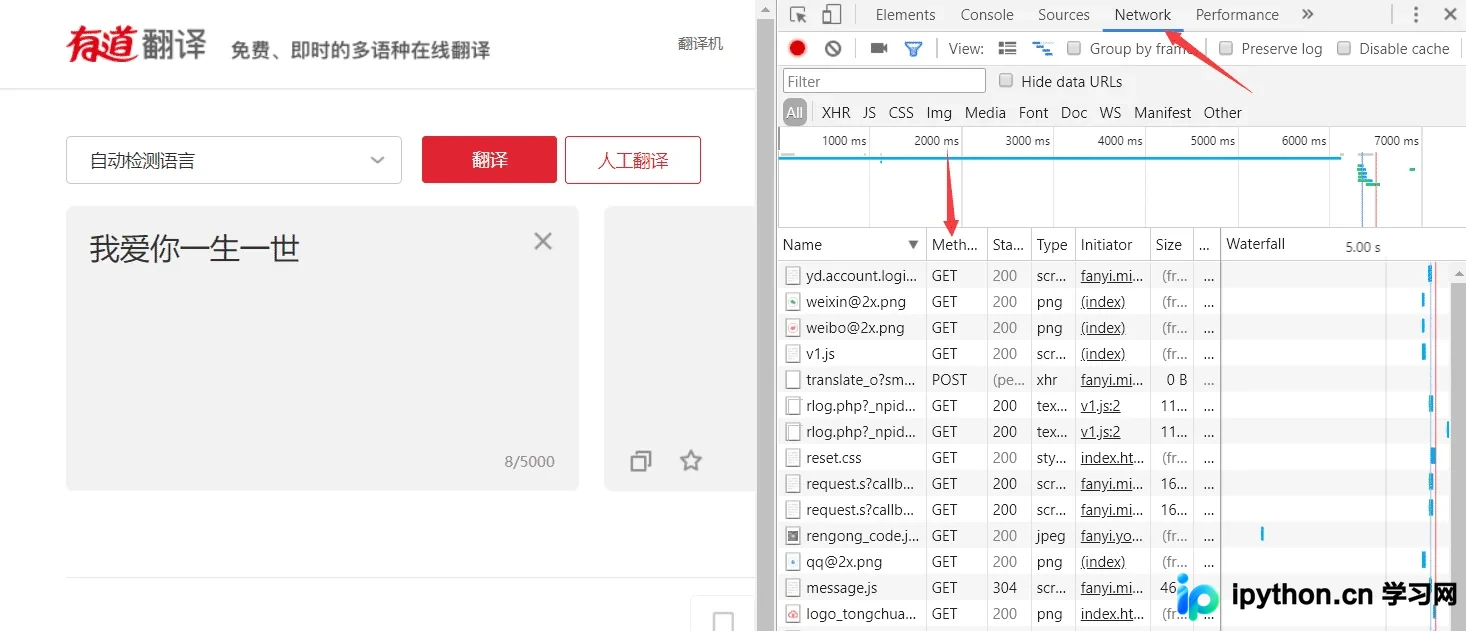
Python爬虫实战:利用urllib模拟有道翻译POST请求
本文详解如何使用Python的urllib库模拟有道在线翻译的POST请求。通过浏览器开发者工具分析网络请求,识别GET与POST差异,重点讲解urlopen方法中data参数的应用、字典数据的构造以及UTF-8编码转换原理,帮助开发者掌握基础网页抓取与接口模拟技巧。
2026-10-13
5

本文详解如何使用Python的urllib库模拟有道在线翻译的POST请求。通过浏览器开发者工具分析网络请求,识别GET与POST差异,重点讲解urlopen方法中data参数的应用、字典数据的构造以及UTF-8编码转换原理,帮助开发者掌握基础网页抓取与接口模拟技巧。
本文通过Python面向对象编程实现当当网书籍数据抓取,演示了正则表达式、BS4和XPath三种解析方式,以及TXT、CSV和MySQL三种存储方案。文章提供完整代码示例,对比各解析方法的优劣,帮助开发者掌握高效的数据爬取与处理技巧。
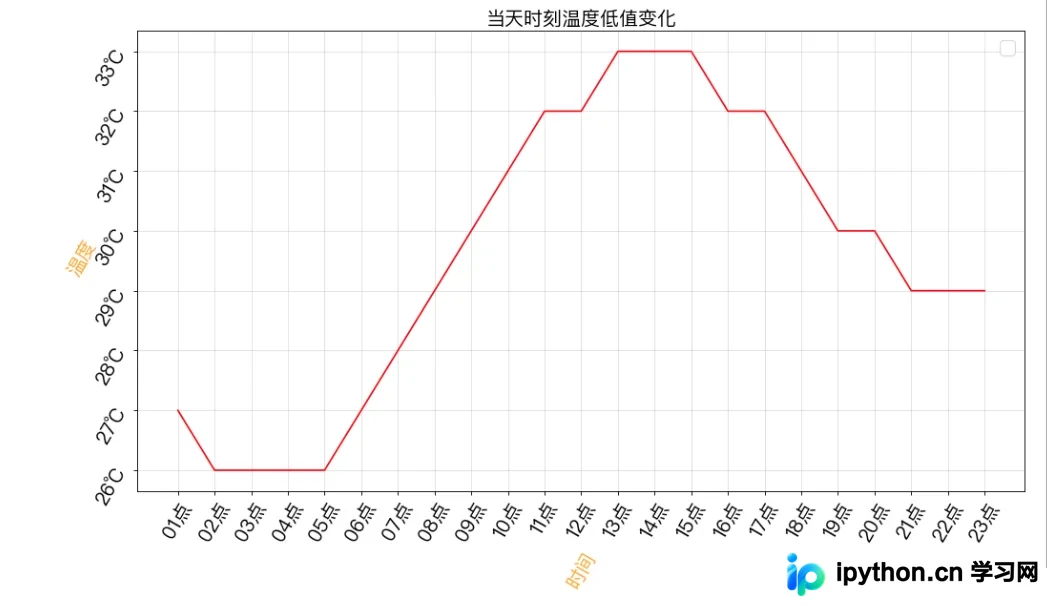
本文介绍使用Python爬虫技术抓取杭州今日24小时温度数据的方法。通过requests库发起请求,利用正则表达式解析HTML页面中的温度数值,并结合面向对象编程封装逻辑。最后使用Matplotlib库将提取的小时温度数据绘制为散点图或折线图,直观展示温度变化趋势。
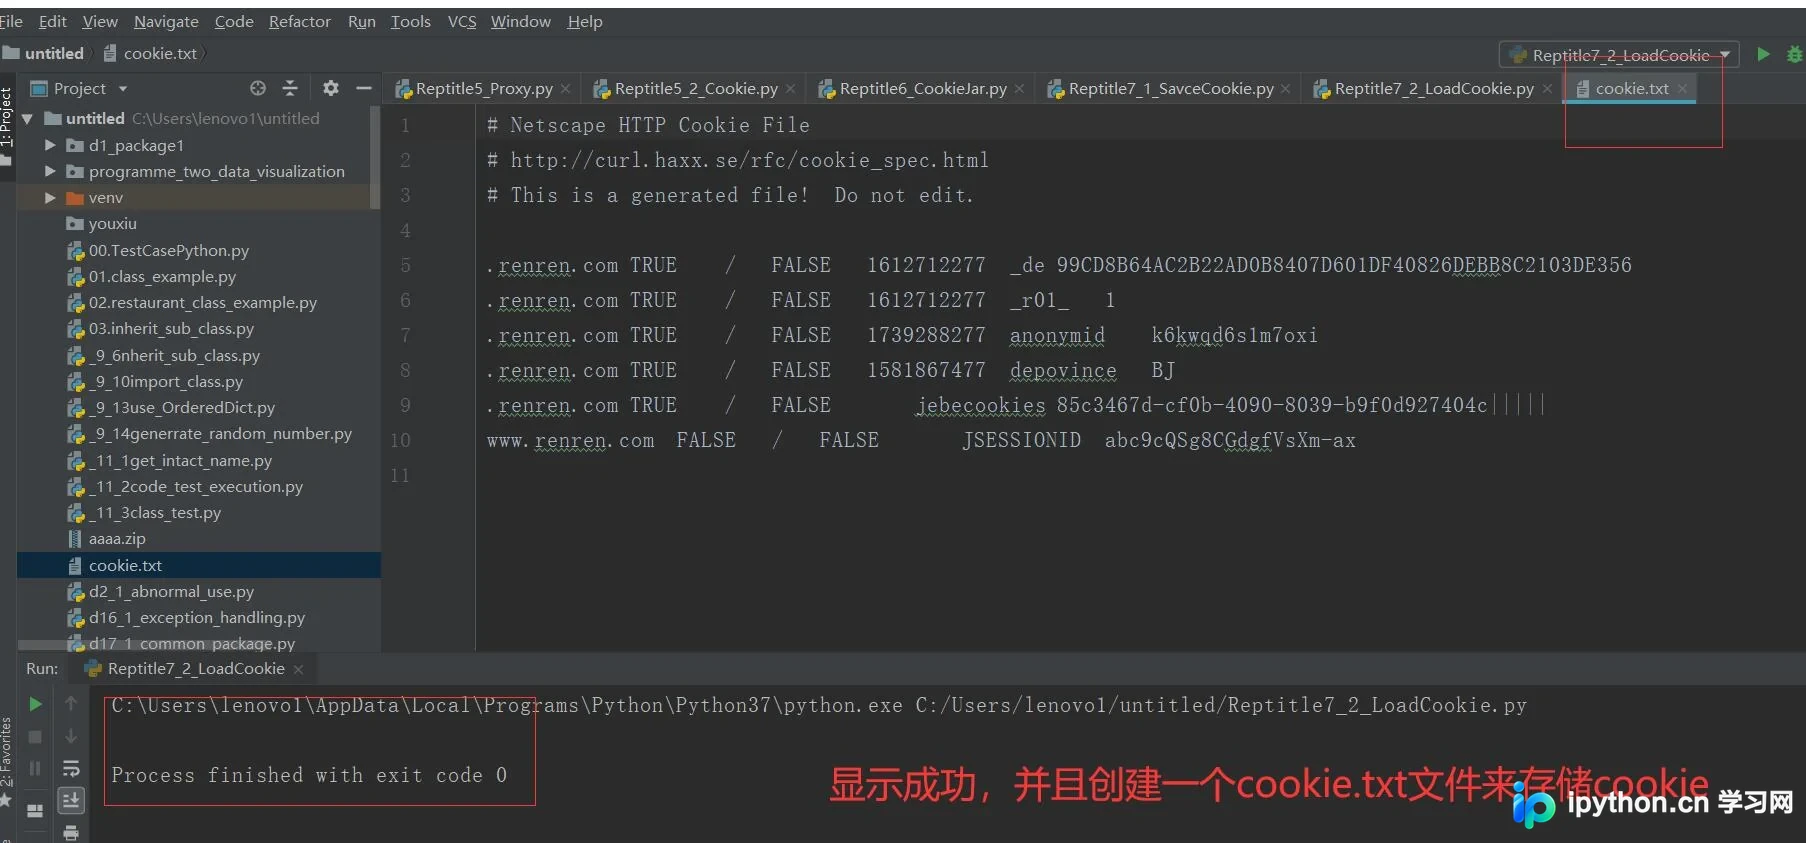
本文详解Python爬虫中Cookie的持久化保存与读取方法,利用FileCookieJar类实现登录状态的文件存储。同时介绍如何处理HTTPS请求中的SSL证书验证问题,通过替换默认上下文环境来忽略不信任的SSL证书,确保爬虫程序在复杂网络环境下的稳定运行。
本文提供使用Python爬取疫情数据的完整源码。通过requests库获取接口数据,利用json模块解析嵌套JSON结构,提取全国及各省累计确诊病例等关键指标。代码包含类封装、数据下载与解析逻辑,适合Python初学者参考学习网络爬虫基础及数据抓取技巧。
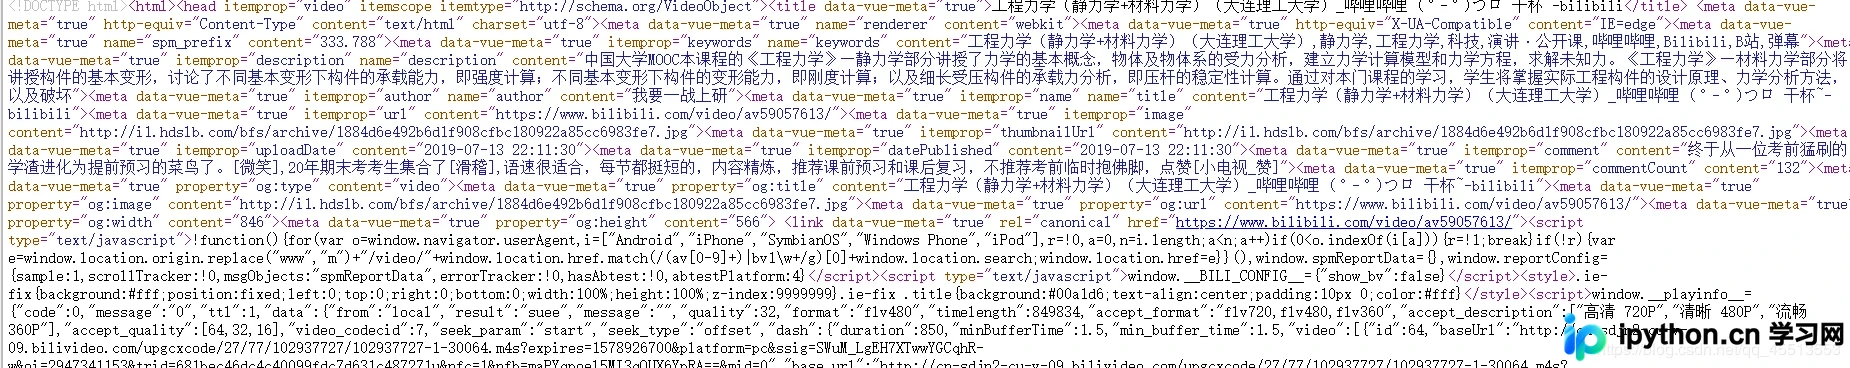
本文介绍利用Python脚本自动获取Bilibili系列视频总时长的方法。通过抓取网页源码中的timelength字段,结合正则表达式解析分集数量,实现批量视频时长的快速统计。文章包含详细操作步骤及完整GitHub源码链接,适合Python初学者参考学习。
本文详解Python爬虫中常见的UnicodeDecodeError异常原因,并提供两种通用解码策略:通过HTML标签提取charset自动解码,以及遍历utf-8、gbk等常用编码并配合errors='replace'参数尝试解析。通过对比数据完整性,推荐以实际数据表现选择最佳编码方式,有效解决网页抓取中的乱码问题。

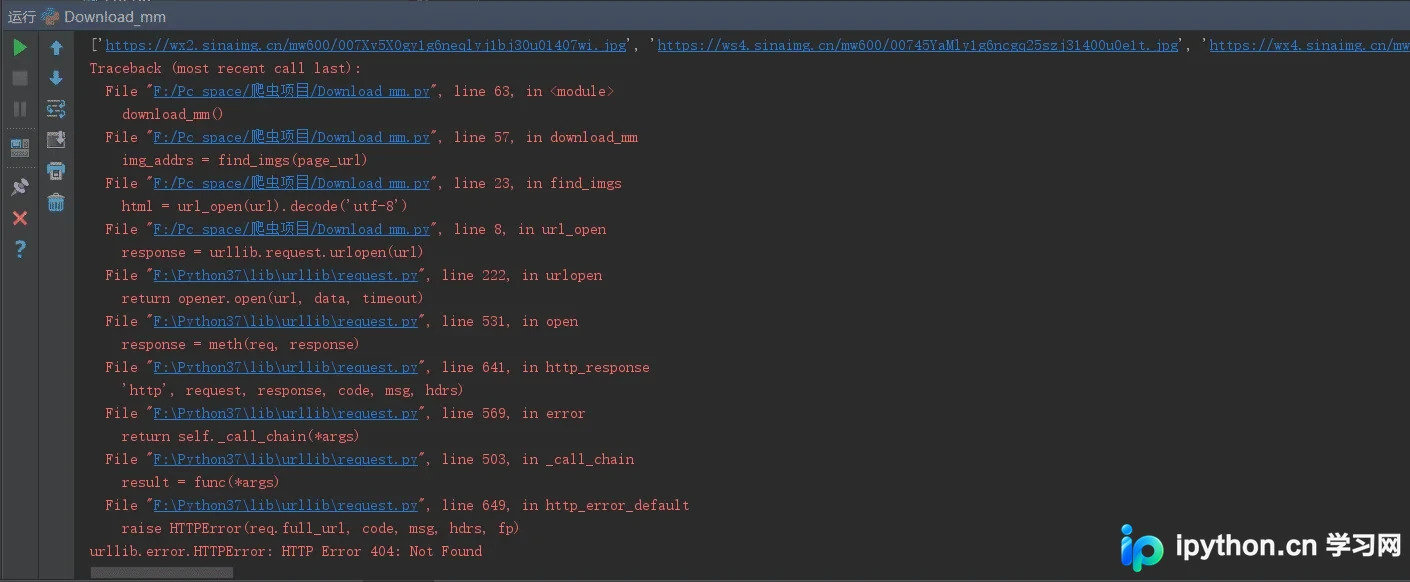
本文详解使用Python爬取煎蛋网图片的完整流程,涵盖urllib.request与os库的应用。重点分析因网页结构变化导致的404错误,通过对比前5面与后5面URL格式差异,定位find()函数匹配失效原因,并提出使用正则或BeautifulSoup优化的建议,帮助开发者规避常见抓取陷阱。
本文详细介绍如何使用Python编写校园通知监控脚本。通过urllib和re库抓取教务处、图书馆等网站的新通知,利用Twilio发送短信、smtplib发送邮箱提醒。文中还涵盖了处理编码异常、多收件人发送、Windows中文环境兼容性及使用PyInstaller打包为exe可执行文件的完整流程与常见故障排除。
本文介绍Python爬虫在抓取网站内链时识别页面类型的三种核心方法:通过URL结构判断、检测特定HTML字段存在性、以及利用DOM标签定位。同时深入讲解Python面向对象设计,通过基类与子类继承机制,实现不同页面类型(如产品页、文章页)的数据结构复用与扩展,提升爬虫代码的可维护性。
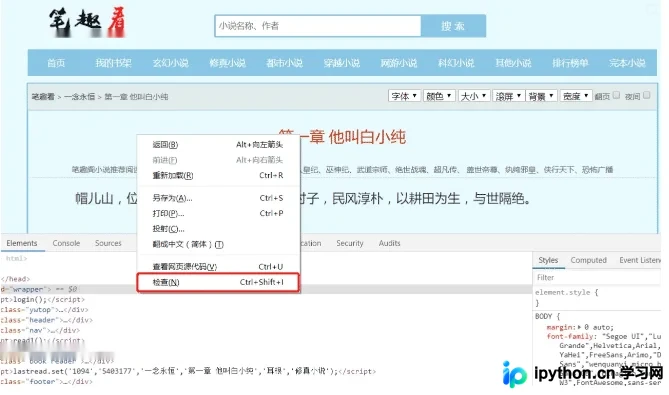
本文详细介绍如何使用Python编写爬虫程序,从笔趣网爬取小说《一念永恒》。重点讲解BeautifulSoup库的安装与使用,包括通过开发者工具定位HTML元素、构造带User-Agent的HTTP请求以及解析响应数据的具体步骤。旨在帮助初学者掌握基础的网络数据采集技巧,同时强调支持正版阅读的重要性。
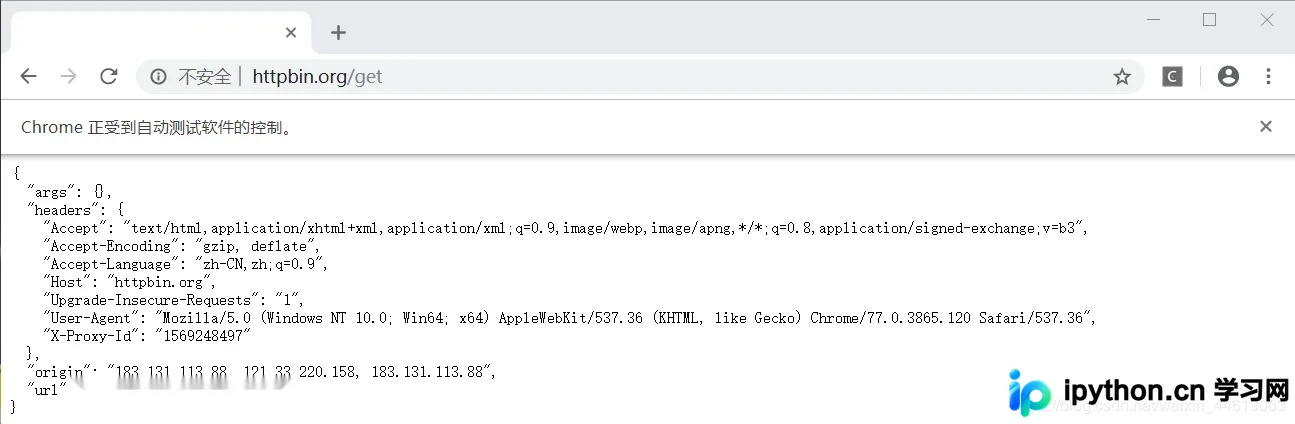
本文详解Python爬虫中代理IP的配置方法,涵盖Urllib、Requests及Selenium三种主流库的代理设置。通过搭建代理池接口获取IP,并结合httpbin.org验证IP伪装效果,帮助开发者解决IP被封禁问题,提升爬虫稳定性与效率。