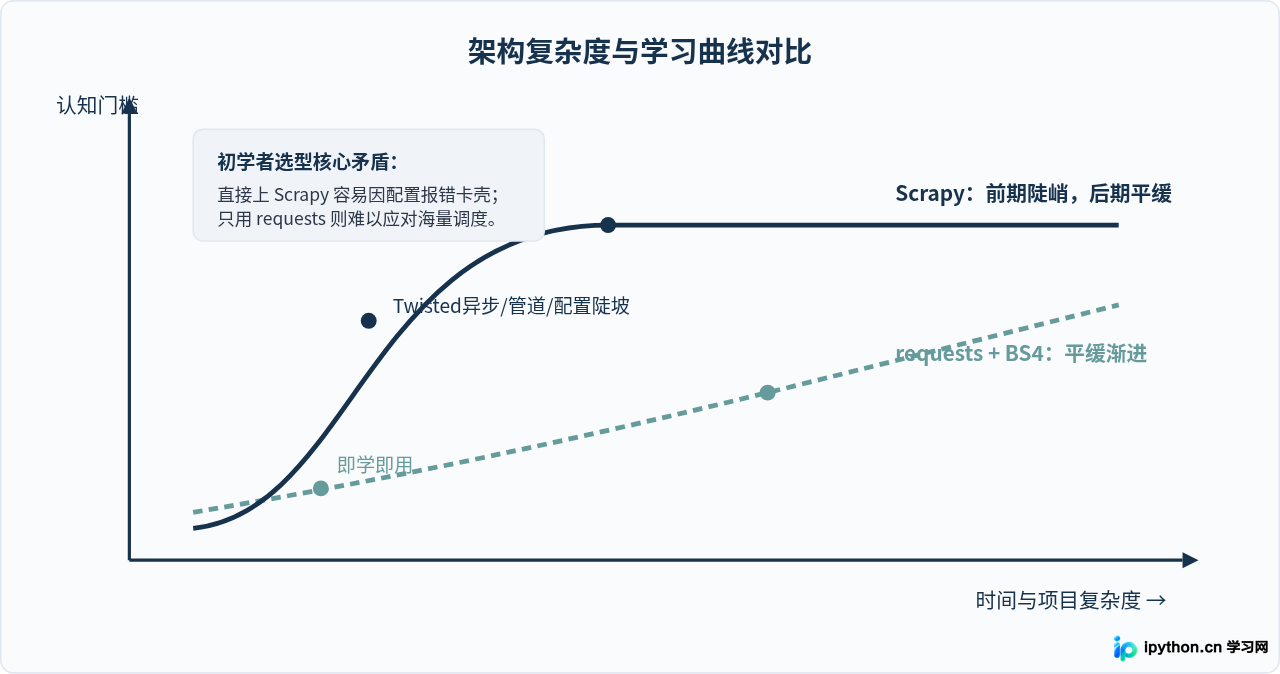
Python爬虫选Scrapy还是requests+BS4?初学者框架选型建议
针对Python爬虫初学者在Scrapy与requests+BS4之间的选型困惑,深入对比两者的学习成本、架构复杂度、适用场景与演进路径,提供清晰可执行的决策建议。
2026-10-10
6

针对Python爬虫初学者在Scrapy与requests+BS4之间的选型困惑,深入对比两者的学习成本、架构复杂度、适用场景与演进路径,提供清晰可执行的决策建议。
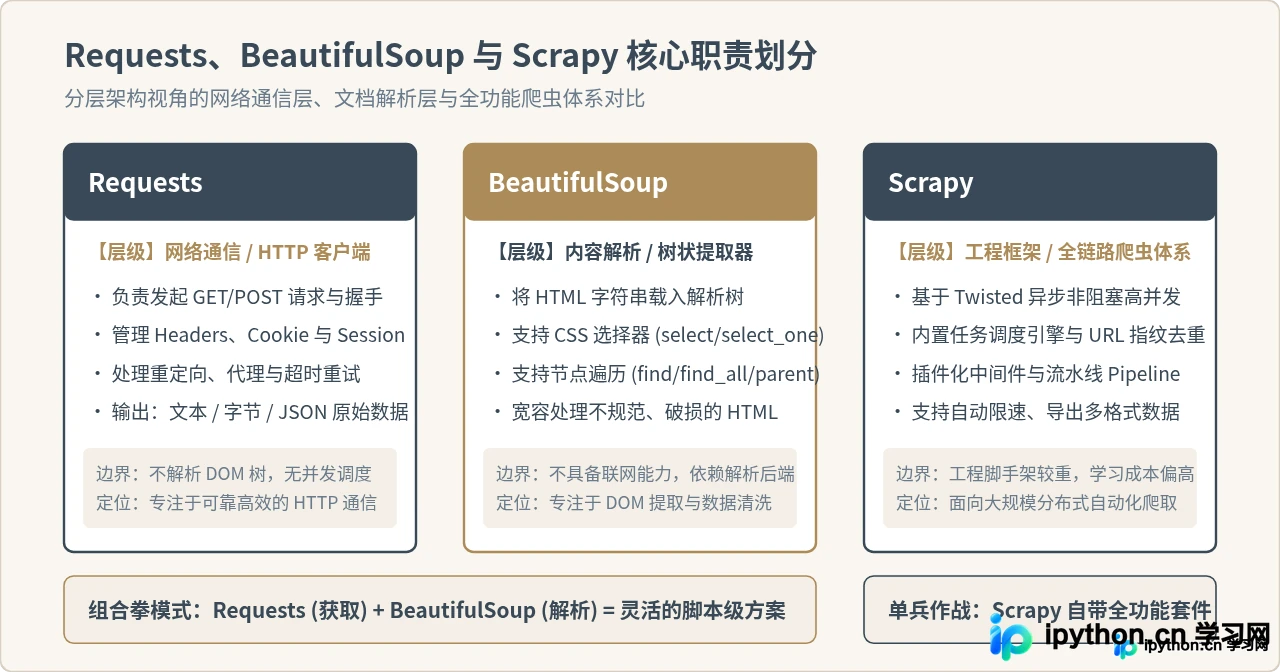
深入对比 Python 爬虫三大主流工具 Requests、BeautifulSoup 与 Scrapy 的定位差异、工作原理与适用场景,提供选型决策树与实践代码。
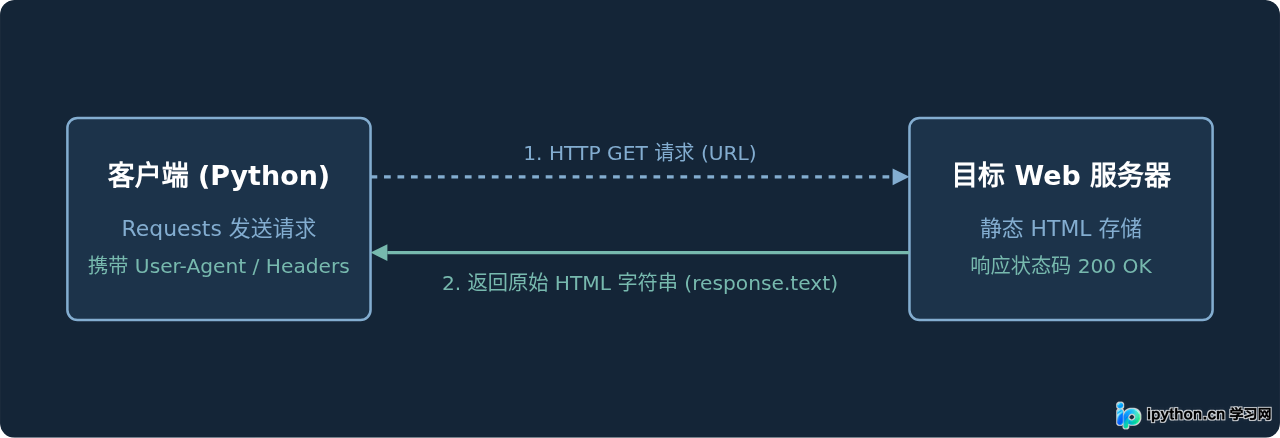
面向初学者的Python静态网页爬虫教程,系统讲解Requests网络请求与BeautifulSoup解析库的配合使用,包含环境安装、选择器提取、完整实战代码与常见问题排查。
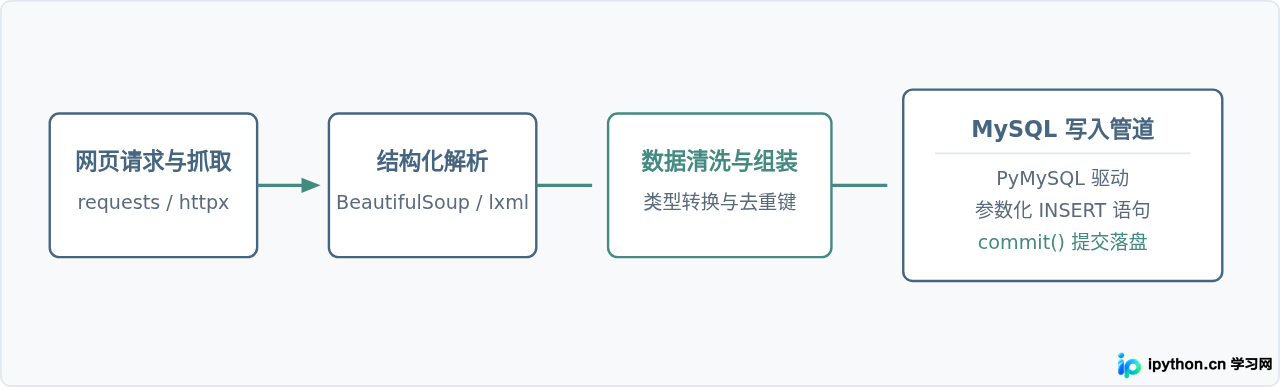
详细讲解Python网络爬虫如何将抓取并清洗后的结构化数据规范写入MySQL数据库,涵盖表结构设计、PyMySQL连接、参数化SQL、批量插入优化及异常重试机制。
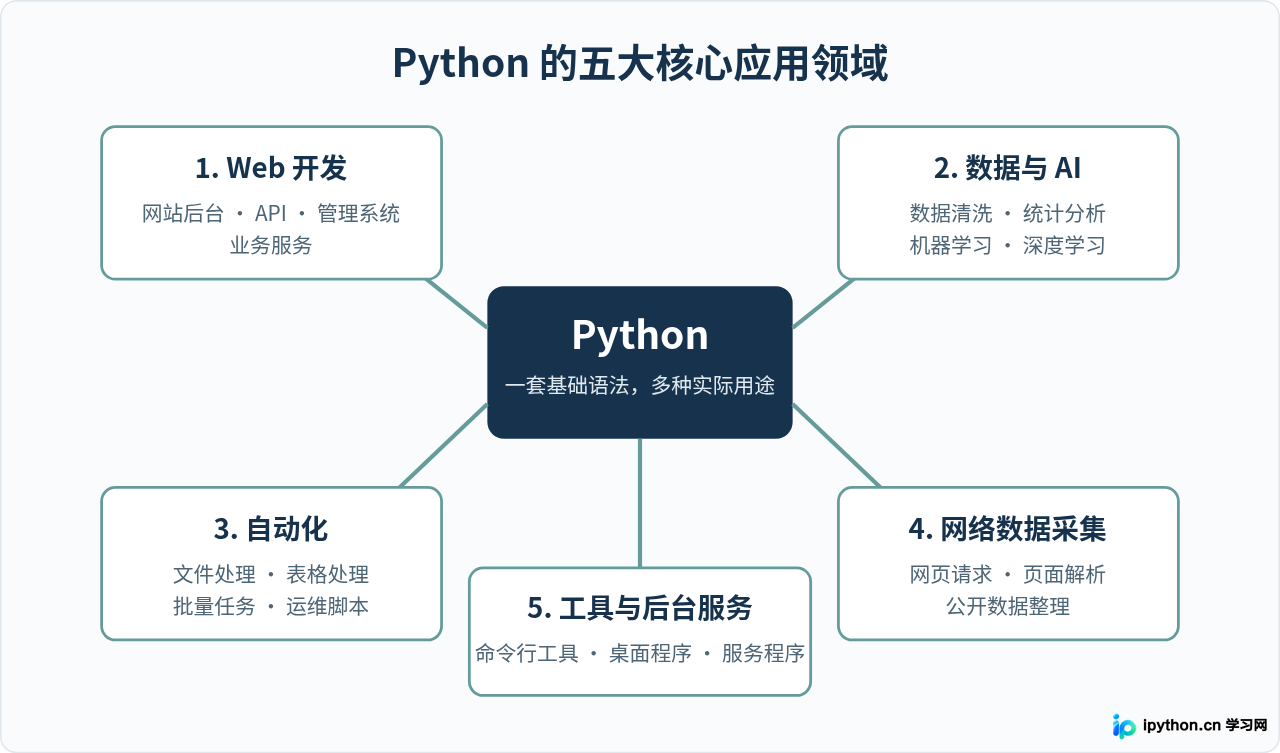
Python主要用来做什么?本文从Web开发、数据分析与人工智能、自动化脚本、网络数据采集和工具开发五个核心应用领域出发,通过具体场景和示例介绍Python的主要用途以及适合学习的方向。
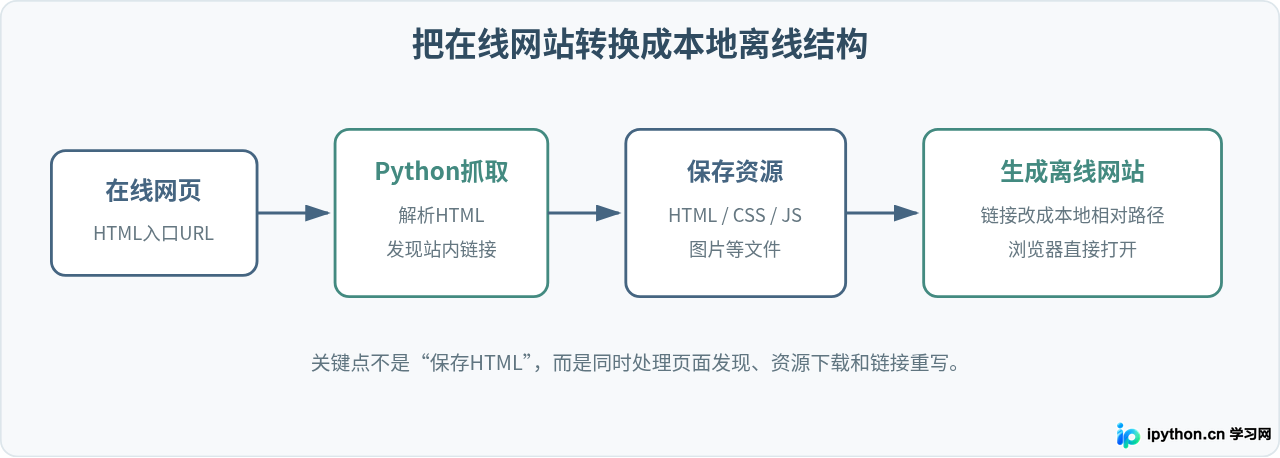
讲解如何使用Python批量爬取网站页面,将HTML、CSS、JavaScript和图片等资源保存到本地,并重写网页链接,形成可以离线浏览的完整HTML目录结构。
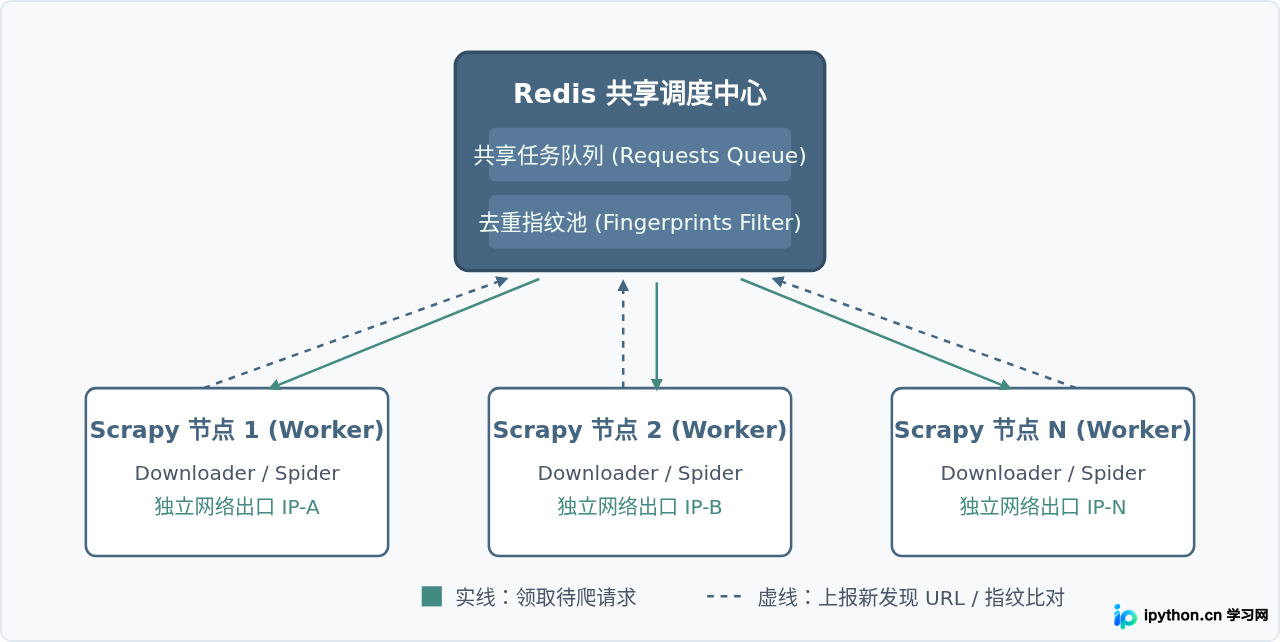
本教程详细讲解如何使用Python Scrapy与Redis构建高可用、大规模的分布式网络爬虫项目,涵盖架构原理、环境搭建、代码编写、节点部署及监控运维。
针对Python全站下载任务中频繁遭遇的403 Forbidden、验证码和连接重置问题,系统讲解如何科学配置请求头矩阵与动态IP代理轮换机制,保障采集稳定进行。
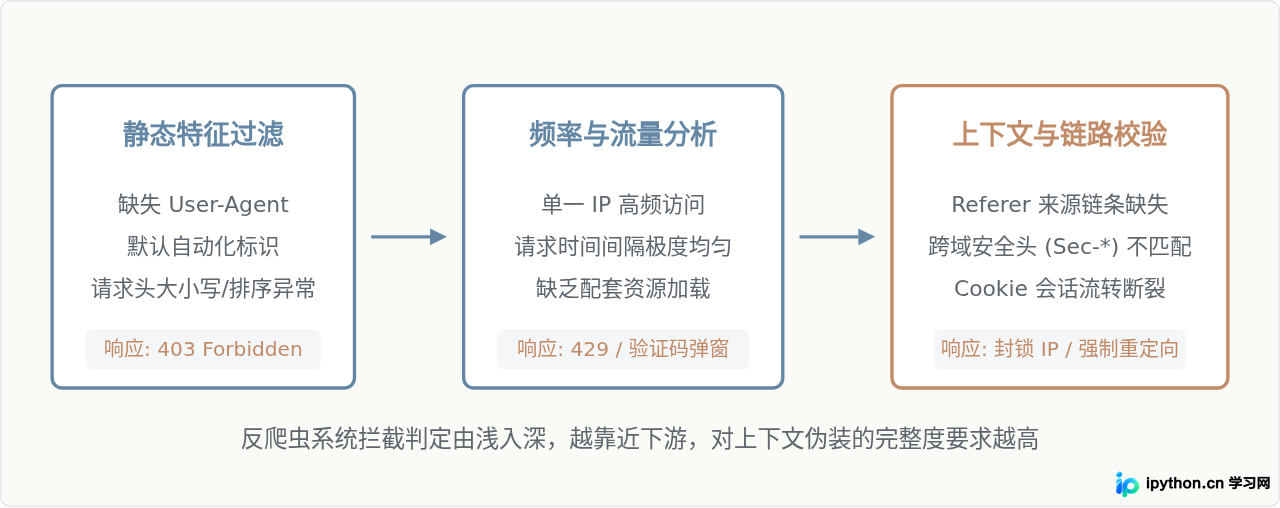
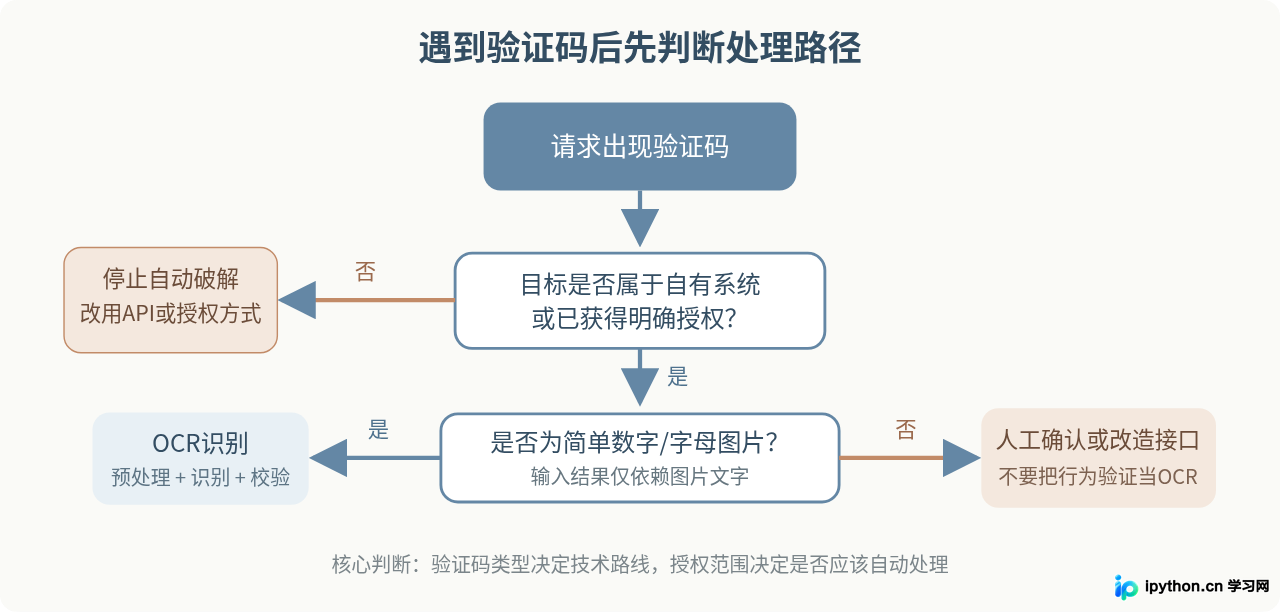
讲解Python爬虫遇到验证码时的处理思路,包括验证码类型判断、OCR识别、图像预处理、人工打码平台接口设计、失败重试和合规边界,并提供可运行的Python示例。
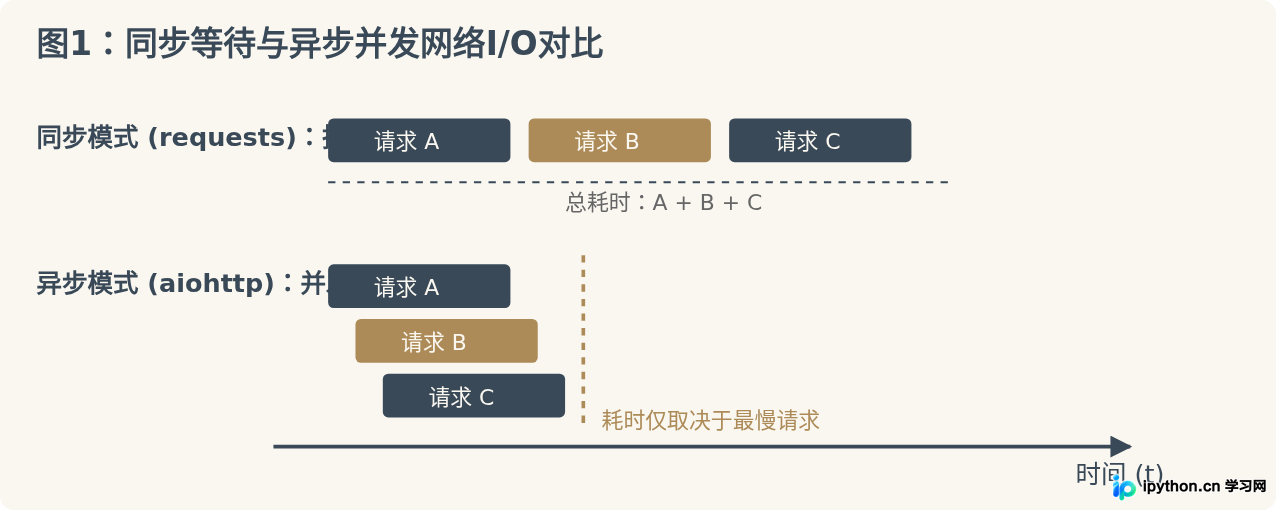
解决Python整站爬取速度慢的问题,详细讲解基于aiohttp的并发下载优化与基于Set/Redis/布隆过滤器的链接去重策略。
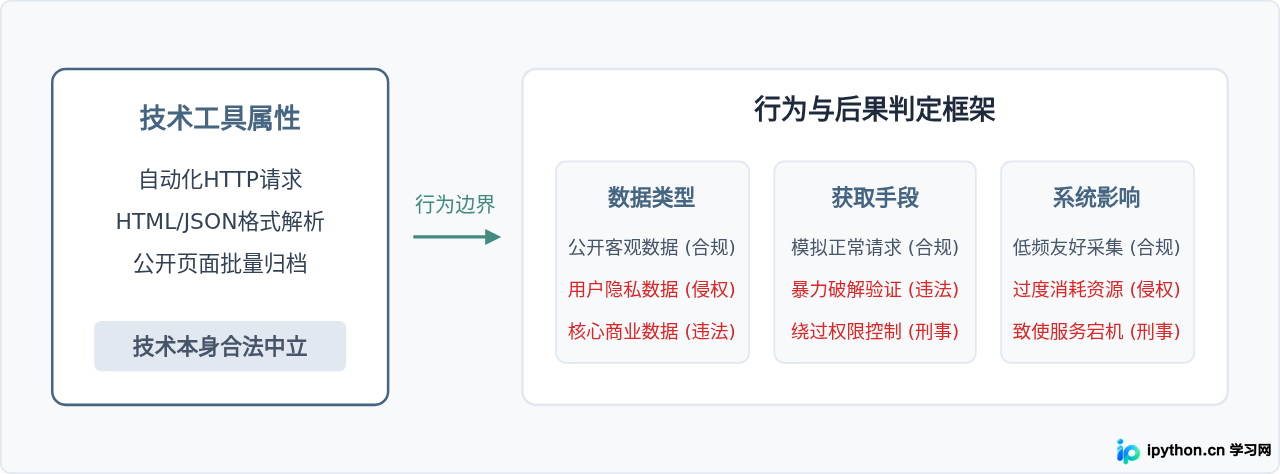
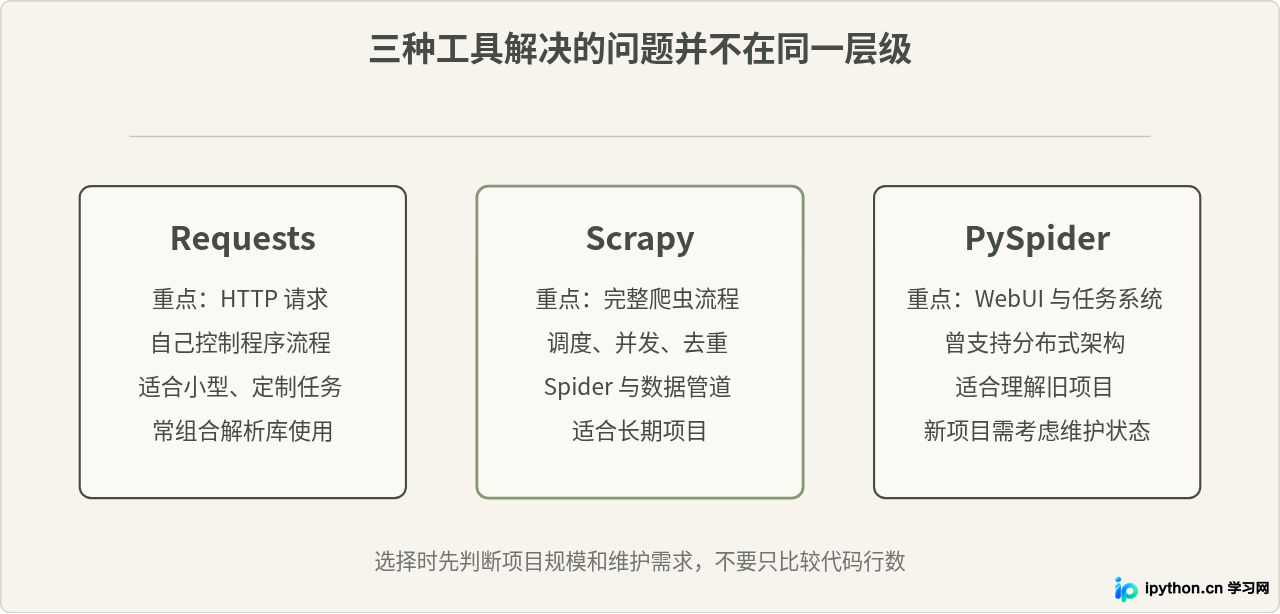
对比Python爬虫常见的Requests、Scrapy与PySpider,从学习成本、并发抓取、任务调度、数据处理、项目维护和适用场景等方面说明区别,并给出不同爬虫项目的选择方法。
详细解答写Python爬虫是否违法,梳理爬虫行为的三大法律红线,并深度解读robots.txt协议的规则语法、法律效力与实际代码解析方法。