

Python整站爬取速度慢怎么办?并发下载与链接去重优化策略

在使用Python进行整站爬取时,很多人会遇到启动顺利但中后期速度断崖式下跌的问题。几十个页面很快抓完,但面对成千上万个链接时,程序却像卡死了一样。导致整站爬取缓慢的核心原因通常只有两个:一是网络I/O阻塞导致程序大部分时间在空等响应;二是链接缺乏有效去重,导致程序在同一批页面中陷入无限循环或重复下载。本文将直接从这两个痛点入手,通过异步并发和去重算法给出具体的提速方案。
一、诊断瓶颈:为什么默认的requests会慢?
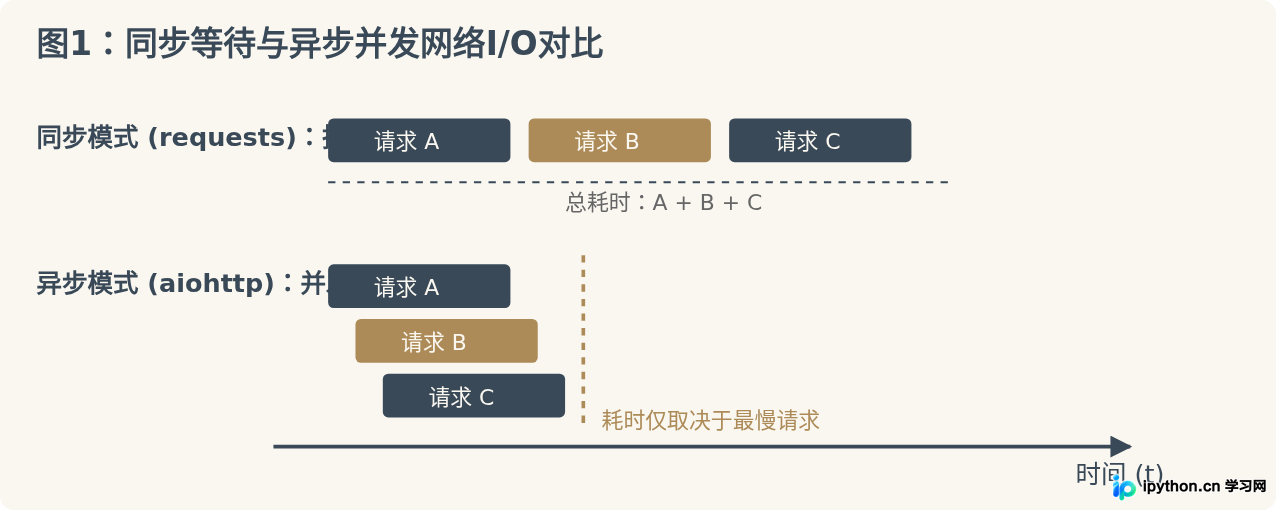
Python中最常用的 requests 库是同步的。当程序执行 requests.get(url) 时,当前线程会被阻塞,直到服务器完全返回数据。在整站爬取场景中,如果你要抓取10000个页面,每个页面网络延迟为0.5秒,单线程同步爬取仅等待网络连接就需要耗费将近1.5小时。
我们可以通过时间轴对比来直观理解同步与异步并发在网络请求中的差异:
二、并发下载策略:从同步到异步
要解决I/O阻塞,我们需要引入并发。在Python中,处理网络请求最高效的方式是使用 asyncio 配合 aiohttp 库。它能在单线程下利用操作系统的事件循环,在等待一个请求返回时,立刻发起下一个请求。
使用 aiohttp 实现并发控制的完整示例
直接发起几千个并发请求会导致本地端口耗尽或直接被目标服务器封禁IP。因此,在使用异步爬虫时,必须使用 asyncio.Semaphore 来限制同时发起的最大连接数。
import asyncio
import aiohttp
from bs4 import BeautifulSoup

# 并发限制器:同时最多允许 50 个请求
CONCURRENCY_LIMIT = 50
semaphore = asyncio.Semaphore(CONCURRENCY_LIMIT)

async def fetch_page(session, url):
    """带并发控制的页面抓取函数"""
    async with semaphore:
        try:
            # 设置超时时间,避免个别死链卡住任务
            async with session.get(url, timeout=10) as response:
                if response.status == 200:
                    html = await response.text()
                    return url, html
                return url, None
        except Exception as e:
            print(f"[{url}] 抓取失败: {str(e)}")
            return url, None

async def main(url_list):
    # 使用长连接池提升性能
    connector = aiohttp.TCPConnector(limit=CONCURRENCY_LIMIT)
    async with aiohttp.ClientSession(connector=connector) as session:
        tasks = [asyncio.create_task(fetch_page(session, url)) for url in url_list]

        # 收集所有结果
        results = await asyncio.gather(*tasks)
        for url, html in results:
            if html:
                # 在此处进行解析和数据提取
                print(f"成功抓取: {url},网页长度: {len(html)}")

# 示例运行
if __name__ == "__main__":
    urls_to_scrape = [f"http://example.com/page/{i}" for i in range(1, 100)]
    asyncio.run(main(urls_to_scrape))
ProcessPoolExecutor 交由独立的进程池处理,让异步循环专心处理网络I/O。
三、链接去重策略:避免死循环与重复抓取
整站爬取是通过“发现页面 -> 提取页面中的链接 -> 抓取新链接”不断递归进行的。网站底部的导航条、页脚说明通常在每个页面都会重复出现。如果没有高效的去重策略,爬虫会被无尽的循环拖死。
标准的整站爬取与去重处理流程如下所示:
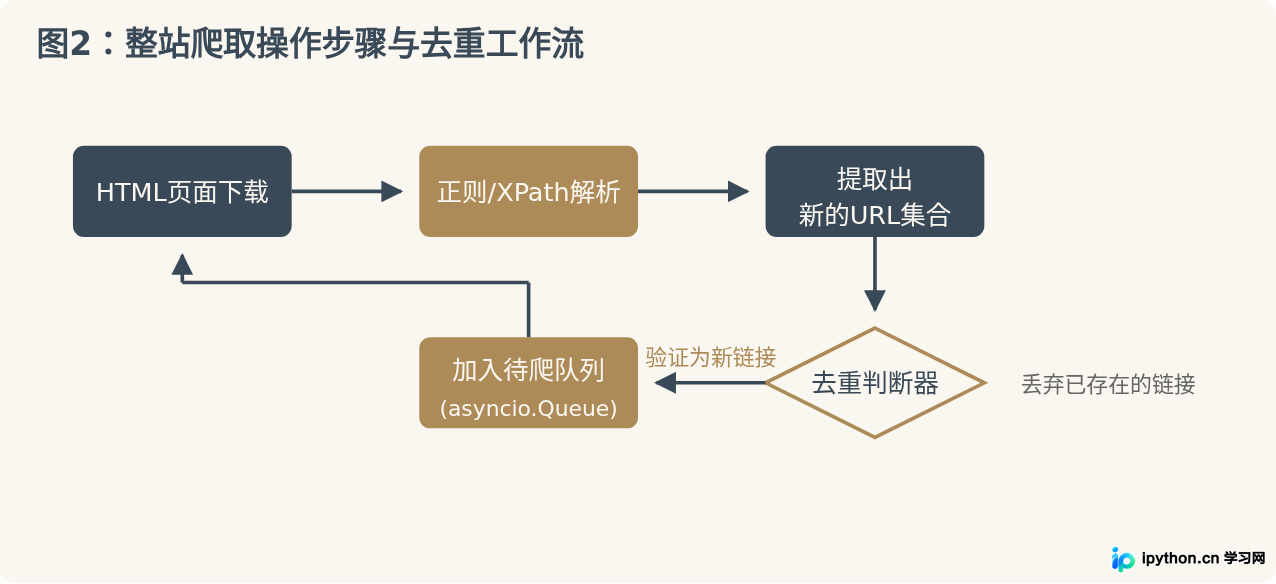
针对不同的数据规模,通常有以下三种去重选择:
1. Python原生 Set(适用于十万级页面以内)
直接使用Python内存中的 set 数据结构存储已经抓取过的URL。它的判断速度是 O(1),实现极其简单。
- 具体做法:定义全局变量
seen_urls = set(),在放入队列前判断if url not in seen_urls: seen_urls.add(url)。 - 局限性:纯内存消耗。一个中等长度的URL约占100字节,100万个URL将占用超100MB内存,且程序一旦意外中断,去重数据全部丢失。
2. Redis 集合去重(适用于分布式、需要断点续爬)
当你要暂停爬虫下次接着跑,或者使用多台机器同时爬取一个整站时,本地的 Set 就不够用了。利用 Redis 的 SADD 指令可以实现持久化、分布式的去重。
- 具体做法:每次提取到新URL,执行
redis_client.sadd("spider:seen", url)。如果返回值是1,说明是新链接;如果是0,说明已被爬过。 - 局限性:Redis 的 Set 仍然是将整个字符串存在内存里。面对千万级乃至亿级的URL(如大型电商或内容站),Redis 的内存占用会飙升到几个GB以上。
3. Bloom Filter 布隆过滤器(大规模爬取的终极优化)
当页面量突破百万甚至上亿时,使用布隆过滤器是最佳实践。它本质上是一个很长的二进制向量和一系列随机映射函数。它可以将数千万的URL映射成位串,内存占用仅为 Set 的 1% - 10%。
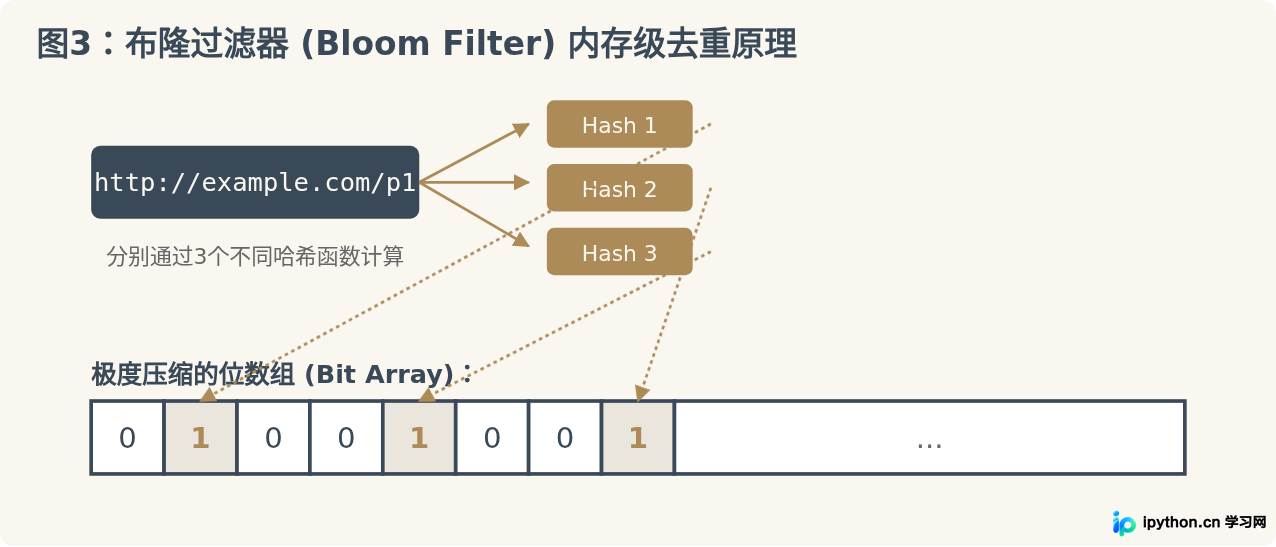
在Python中,可以通过安装 pybloom_live 库来在本地实现布隆过滤器,或者直接使用 Redis 提供的 RedisBloom 扩展。
- 判断依据:当一个URL经过多个哈希函数计算出的位图位置,其值全为
1时,布隆过滤器判定其“存在”。 - 注意误差:布隆过滤器有极小的“误判率(False Positive)”(可能把没抓过的网页误认为抓过),但绝不会发生“漏判”。在创建过滤器时调高
capacity和降低error_rate即可控制在万分之一的误判率,这对绝大部分爬虫任务是可以接受的。
四、合并策略与全文总结
要开发一个高效率的整站爬取程序,并不是简单将代码替换为异步就能完成的。高并发会带来连接池复用、服务器反爬封禁的问题;而多任务环境下,去重判断和入列操作也需要保持安全性。
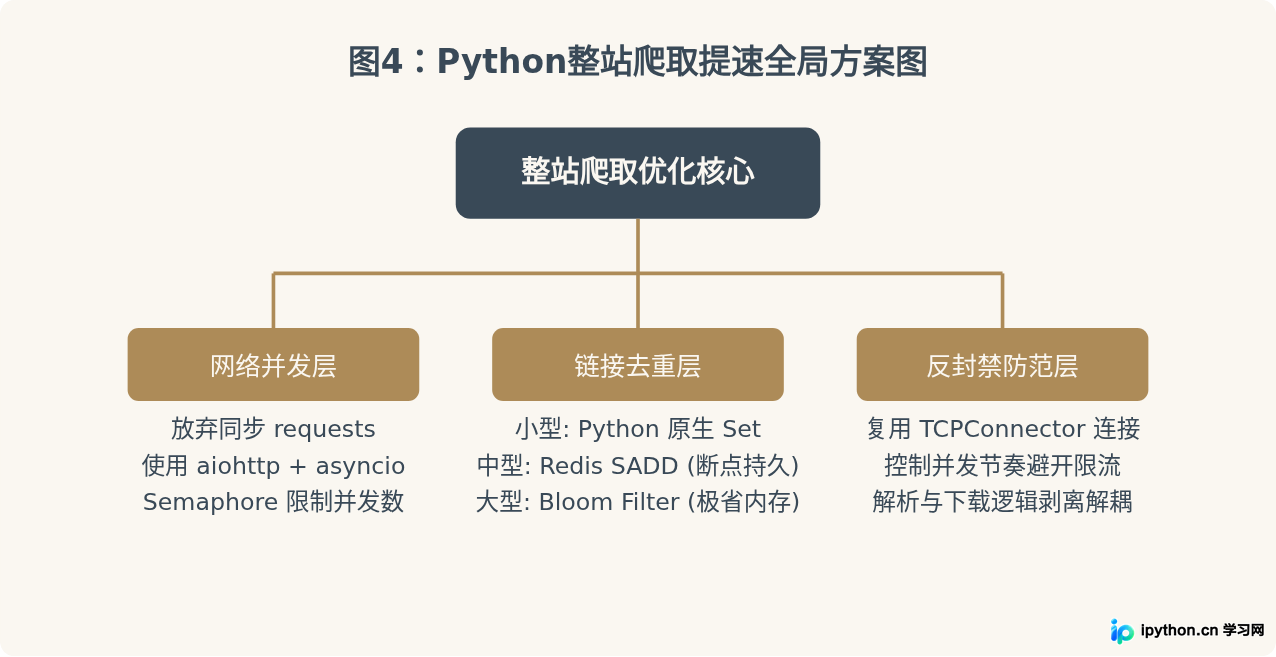
面对速度变慢的爬虫程序,请按下述逻辑排查与重构:首先,将你的单线程式网络请求替换为 asyncio + aiohttp 协程模型,并设定 50-100 的合理并发阈值。其次,检查现有的去重机制,确保每一个提取到的URL都要经过严格且高效的去重器(根据全站规模选择 Set 还是 布隆过滤器),只有被判定为“全新”的链接才能进入异步抓取队列。这两步落实到位,你的整站爬虫速度将得到质的飞跃。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









