

遭遇反爬拦截?Python全站下载中的IP代理与请求头配置技巧

进行全站规模的内容抓取或离线镜像时,程序往往在运行数十分钟后遭遇 HTTP 403、验证码重定向或直接断开连接。要突破这种批量爬取带来的拦截瓶颈,核心在于两项改造:将零散的伪装头升级为具备浏览器指纹特征的动态请求头矩阵,并将单点出口拓展为具备健康探测机制的高可用动态代理池。
一、全站下载遭遇拦截的深层原因
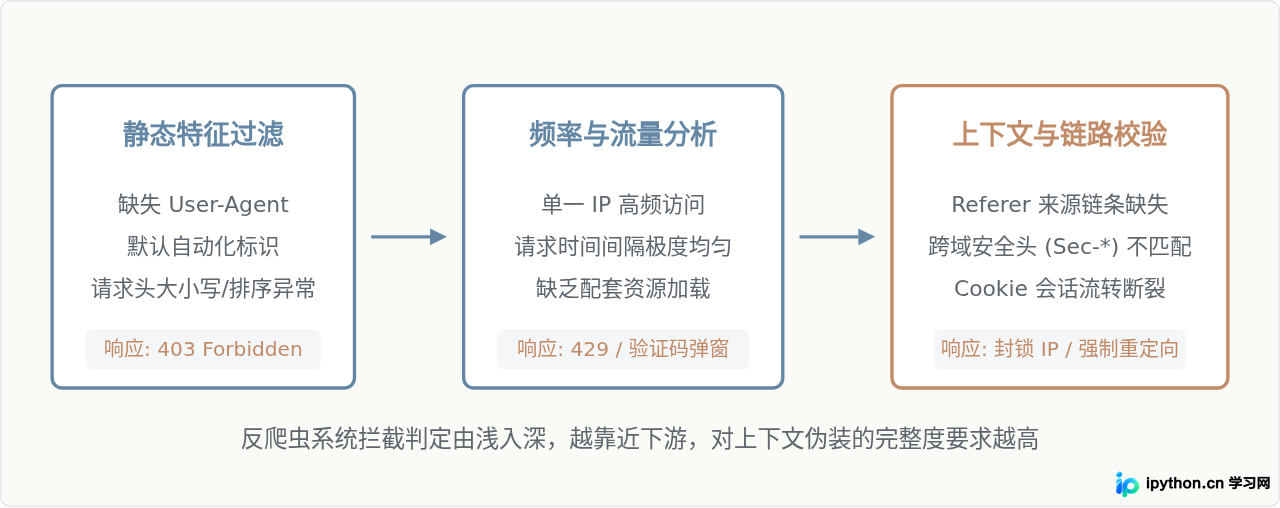
单页采集与全站下载最大的差异在于请求密度与行为广度。许多初学者能成功获取列表页前三页,却在遍历第两百页时报错退出。服务端反爬虫模块在评估访问来源时,并不是单独看某一次请求是否合规,而是通过上下文状态与流量指纹进行多维判定。
网站防护通常按以下层级递进触发:首先是浅层的静态特征审查(缺少基础字段或带有 Python-requests 标识);其次是频率门槛拦截(同一 IP 在短时间内的请求数超出阈值);最后是协议与行为一致性审查(请求头中的各字段与真实浏览器的标准行为不吻合,或者缺少静态资源并行加载的链路)。
二、构建真实的请求头(Headers)矩阵
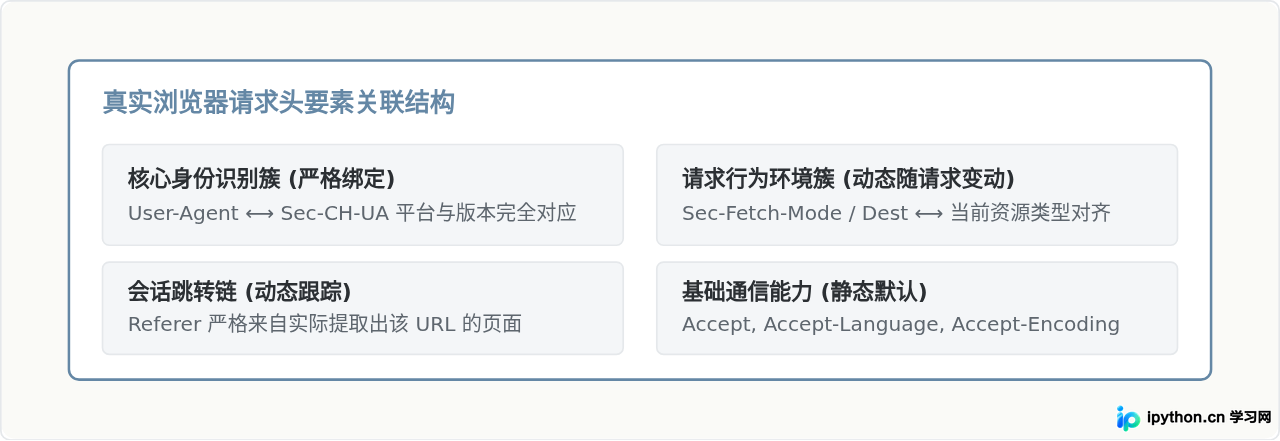
只设置一个 User-Agent 是很多初学者的通病。现代网站普遍启用了针对现代浏览器的端点安全审查,例如 Chromium 系列的 Sec-CH-UA 系列字段。如果 User-Agent 声明自己是 Chrome 浏览器,却完全没有携带配套的 Fetch 规范元数据头,就会在首轮检测中被判定为可疑请求。
1. 核心字段组合与动态关系
配置请求头时,需要确保各字段之间逻辑统一。操作系统平台与浏览器版本必须在所有字段中完全对齐,严禁出现“Windows 系统声明却带有 macOS 专属标头”等自相矛盾的情况。
- User-Agent: 标识客户端内核与版本。全站抓取建议维护一个包含主流主流桌面版本的集合池进行轮询。
- Sec-Fetch-* 系列字段: 现代浏览器的关键指纹。例如下载 HTML 页面时,
Sec-Fetch-Dest应为document,Sec-Fetch-Mode为navigate。 - Referer 链路: 全站下载必须动态更新 Referer。爬取子页面时,应将其父级分类页或列表页地址填入,还原真实的跳转逻辑。
- Accept 与 Accept-Language: 显式声明解析类型与语言环境,避免使用库的精简默认值。
2. 代码实现:动态请求头生成器
为了避免每次发包时重复手写字典,可以在下载器中引入一个轻量的工厂类,根据访问的目标 URL 类型和前置 URL 自动组装标准头:
import random

class HeaderGenerator:
    def __init__(self):
        # 预设几组真实环境对应的版本指纹
        self.profiles = [
            {
                "ua": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
                "ch_ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
                "platform": '"Windows"'
            },
            {
                "ua": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/123.0.0.0 Safari/537.36",
                "ch_ua": '"Chromium";v="123", "Google Chrome";v="123", "Not-A.Brand";v="99"',
                "platform": '"macOS"'
            }
        ]

    def get_headers(self, referer=None, is_document=True):
        profile = random.choice(self.profiles)
        headers = {
            "User-Agent": profile["ua"],
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8" if is_document else "*/*",
            "Accept-Language": "zh-CN,zh;q=0.9,en-US;q=0.8,en;q=0.7",
            "Accept-Encoding": "gzip, deflate, br",
            "sec-ch-ua": profile["ch_ua"],
            "sec-ch-ua-mobile": "?0",
            "sec-ch-ua-platform": profile["platform"],
            "Sec-Fetch-Site": "same-origin" if referer else "none",
            "Sec-Fetch-Mode": "navigate" if is_document else "no-cors",
            "Sec-Fetch-User": "?1" if is_document else None,
            "Sec-Fetch-Dest": "document" if is_document else "empty",
            "Upgrade-Insecure-Requests": "1" if is_document else None
        }
        # 清理空值项
        cleaned_headers = {k: v for k, v in headers.items() if v is not None}
        if referer:
            cleaned_headers["Referer"] = referer
        return cleaned_headers
三、IP代理轮换策略与生命周期管理
当请求头已经完全贴合正常浏览器时,如果依然出现拦截,通常意味着触发了 IP 级别的访问频次限制。进行整站爬取时,单 IP 发包频次过快会很快被黑名单收录,过慢又会导致整个任务需要数周才能完成。因此,部署动态 IP 代理池是实现规模化全站下载的必经阶段。
1. 代理选择的关键判断
公开抓取的免费代理可用率极低,网络延迟通常超过 5 秒且生命周期不可控,并不适合全站级任务。商用代理主要分为两种:
| 代理类型 | 典型存活时长 | 核心特征 | 最适配的全站下载环节 |
|---|---|---|---|
| 数据中心代理 (机房IP) | 数天至数月 | 带宽大、成本低、并发高,但极易被云盾类防护整段识别 | 针对防御松散的二级静态资源站或媒体下载 |
| 动态住宅代理 | 1分钟 ~ 30分钟 | 来自真实家庭宽带,反爬识别难度高,计费通常按流量计算 | 主站 HTML 页面抓取、详情页与反爬严重的 API 接口 |
2. 代理池管理流水线
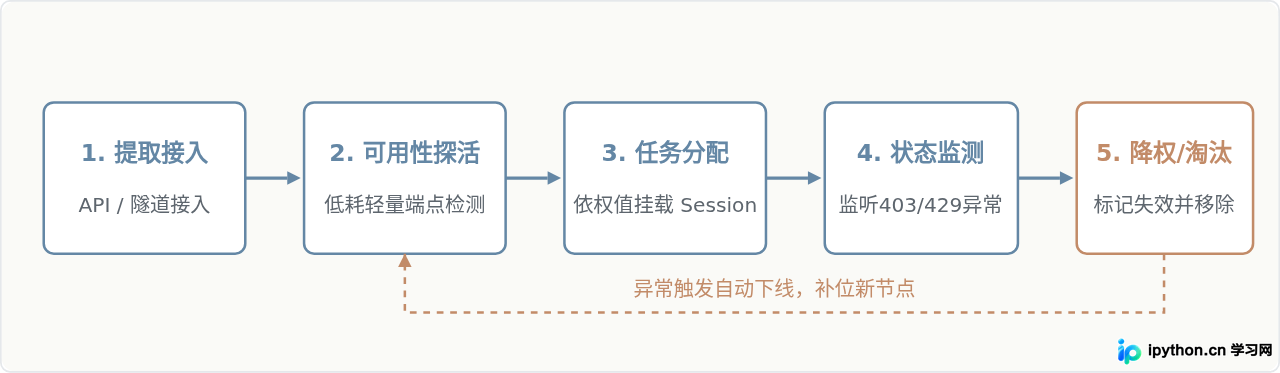
在全站采集脚本中,切忌直接在业务代码里即拿即用。代理池应该是一个独立的供给端,包含提取、探活、注入、熔断、剔除五个标准环节。
四、全站采集完整实现方案
以下示例使用标准库与 requests 结合,展示一个内嵌“动态头装配”、“代理轮换”以及“自动错误重试”的小型下载内核。这种组织方式将网络请求与抓取业务分离,避免代码杂糅。
import time
import random
import requests
from urllib.parse import urlparse

class ResilientDownloader:
    def __init__(self, proxy_list):
        self.proxy_list = proxy_list  # 格式: ["http://ip:port", ...]
        self.header_gen = HeaderGenerator()
        self.session = requests.Session()

    def _get_random_proxy(self):
        if not self.proxy_list:
            return None
        proxy_url = random.choice(self.proxy_list)
        return {"http": proxy_url, "https": proxy_url}

    def fetch(self, url, referer=None, max_retries=3, timeout=10):
        current_referer = referer
        for attempt in range(1, max_retries + 1):
            proxy = self._get_random_proxy()
            headers = self.header_gen.get_headers(referer=current_referer)

            try:
                # 发送请求,明确指定代理与头信息
                response = self.session.get(
                    url,
                    headers=headers,
                    proxies=proxy,
                    timeout=timeout,
                    allow_redirects=True
                )

                # 遇到封锁状态码,主动抛出异常触发重试
                if response.status_code in (403, 429):
                    raise requests.exceptions.HTTPError(f"触发防护,状态码: {response.status_code}")

                response.raise_for_status()
                return response.text

            except (requests.exceptions.RequestException, requests.exceptions.HTTPError) as e:
                # 随机抖动等待,避免规律性重发
                wait_seconds = random.uniform(1.5, 3.5) * attempt
                time.sleep(wait_seconds)

                # 如果某个代理连续报错,可在生产环境中将其从 self.proxy_list 剔除
                if attempt == max_retries:
                    return None
        return None

# 执行示例
if __name__ == "__main__":
    # 配置你的代理列表(示例格式)
    proxies = [
        "http://198.51.100.12:8080",
        "http://203.0.113.45:3128"
    ]

    downloader = ResilientDownloader(proxy_list=proxies)

    # 模拟从列表页进入详情页的全站下载流
    target_list_page = "https://example.com/archive"
    list_html = downloader.fetch(target_list_page)

    if list_html:
        target_detail_page = "https://example.com/archive/item-001"
        detail_html = downloader.fetch(target_detail_page, referer=target_list_page)
        # 接下来进行 HTML 解析与本地落盘保存
requests 库可能会因为固定使用 HTTP/1.1 TLS 指纹而被边缘节点过滤。如果配置了正确的代理与请求头后仍返回 403,建议将请求客户端替换为支持 HTTP/2 的库(如 httpx 并开启 http2=True)。
五、保障稳定运行的关键细节
解决了请求头与代理之后,要让爬虫连续运行数小时甚至数天,还需要消除几个容易被忽略的隐性特征:
- 避免机械固定的时间间隔: 严格使用
time.sleep(2)会在流量监控图上形成规律的波形。采用指数分布或正态分布的随机延时(如random.uniform(1.2, 4.0)),更接近人类阅读和翻页的行为。 - 会话(Session)与 Cookie 的隔离边界: 频繁更换 IP 时,切勿所有请求都共用同一个
requests.Session()。如果服务端发现一个已登录或分配了固定 Cookie 的会话在极短时间内跨越不同省份甚至国家的 IP 节点发包,会立刻将其标记为异常。换用代理时,应适时重建 Session。 - 非核心静态资源的处理: 如果只需要保存文本与关键数据,应当过滤掉无意义的跟踪埋点请求;如果确实是做镜像下载,必须注意图片、CSS、JS 的下载并发,避免主页面用代理,而静态文件走直连导致本机真实 IP 泄露。
六、技巧与排查总结
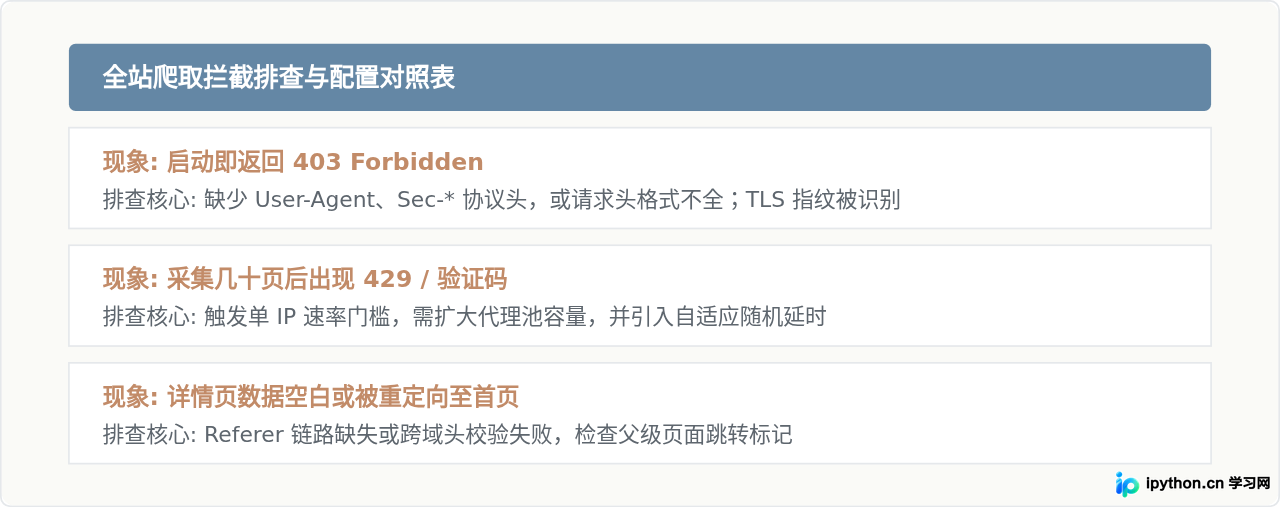
排查全站下载拦截问题时,可以按照下表的对应关系,逐项校验当前程序的状态。
完成全站下载不仅需要编写 HTML 提取逻辑,更需要建立完善的流量控制机制。将请求头维护成一套具有真实依赖关系的配置矩阵,再辅以带有健康淘汰机制的动态代理池,就能有效应对绝大多数内容站点的基础防御,确保批量下载任务平稳执行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









