

Python构建网页爬虫原理分析
本文深入解析Python构建网页爬虫的核心原理,涵盖从单线程基础实现到分布式系统扩展的关键环节。重点讨论抓取频率控制、URL去重策略(如布隆过滤器)、HTML解析挑战及性能瓶颈优化,为系统设计面试提供完整解决方案。
2026-10-13
5

本文深入解析Python构建网页爬虫的核心原理,涵盖从单线程基础实现到分布式系统扩展的关键环节。重点讨论抓取频率控制、URL去重策略(如布隆过滤器)、HTML解析挑战及性能瓶颈优化,为系统设计面试提供完整解决方案。
本文详解如何在Python爬虫中伪装浏览器以获取正常响应。通过Fiddler工具抓取豆瓣网站的真实请求头,提取User-Agent等关键信息,并在代码中自定义Request Headers进行模拟。附带完整Python示例代码及运行结果分析,帮助开发者解决反爬限制问题。
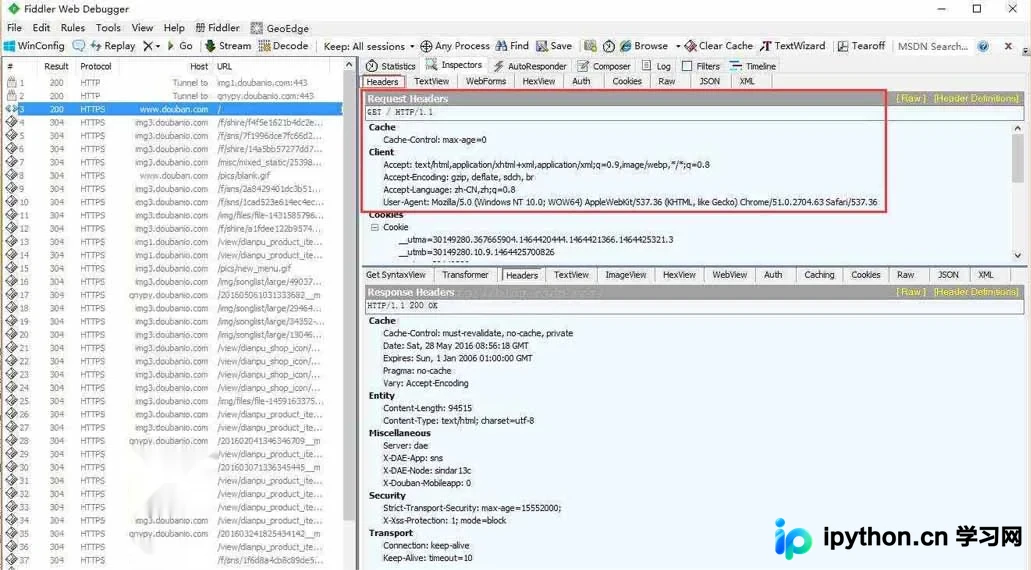
本文针对Python爬虫突然报错Http 800 Internal internet error的问题,分析原因为目标网站启用了反爬虫程序。通过对比修改前后的代码,演示如何为urllib.request.Request对象添加User-Agent头部信息,伪装成浏览器请求以绕过限制,恢复爬虫正常运行。
本文介绍如何利用Python语言编写一个简单的网络爬虫,从段子网(ishuo.cn)批量抓取搞笑段子。通过解析URL规律并结合urllib与re模块,实现对段子内容的自动提取与本地存储,为聊天机器人或内容发布提供数据支持。
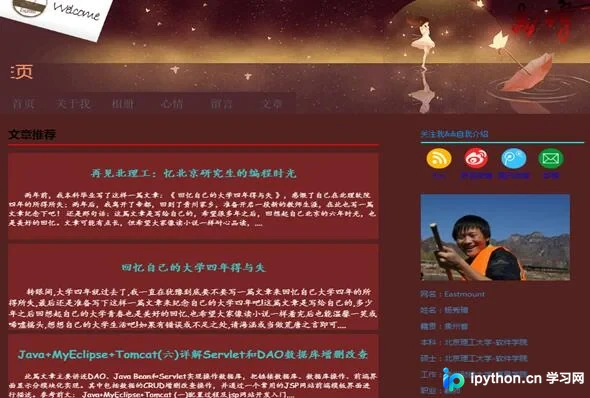
本文详细解析Python中正则表达式(Regex)在爬虫开发中的应用。通过介绍re模块的核心函数如findall、compile、match及search,结合抓取网页标题、超链接、表格内容及图片URL的具体代码示例,演示如何高效提取HTML数据。最后通过完整实例展示如何爬取个人博客的标题、图片及文章摘要,帮助初学者掌握基础网络数据抓取技巧。
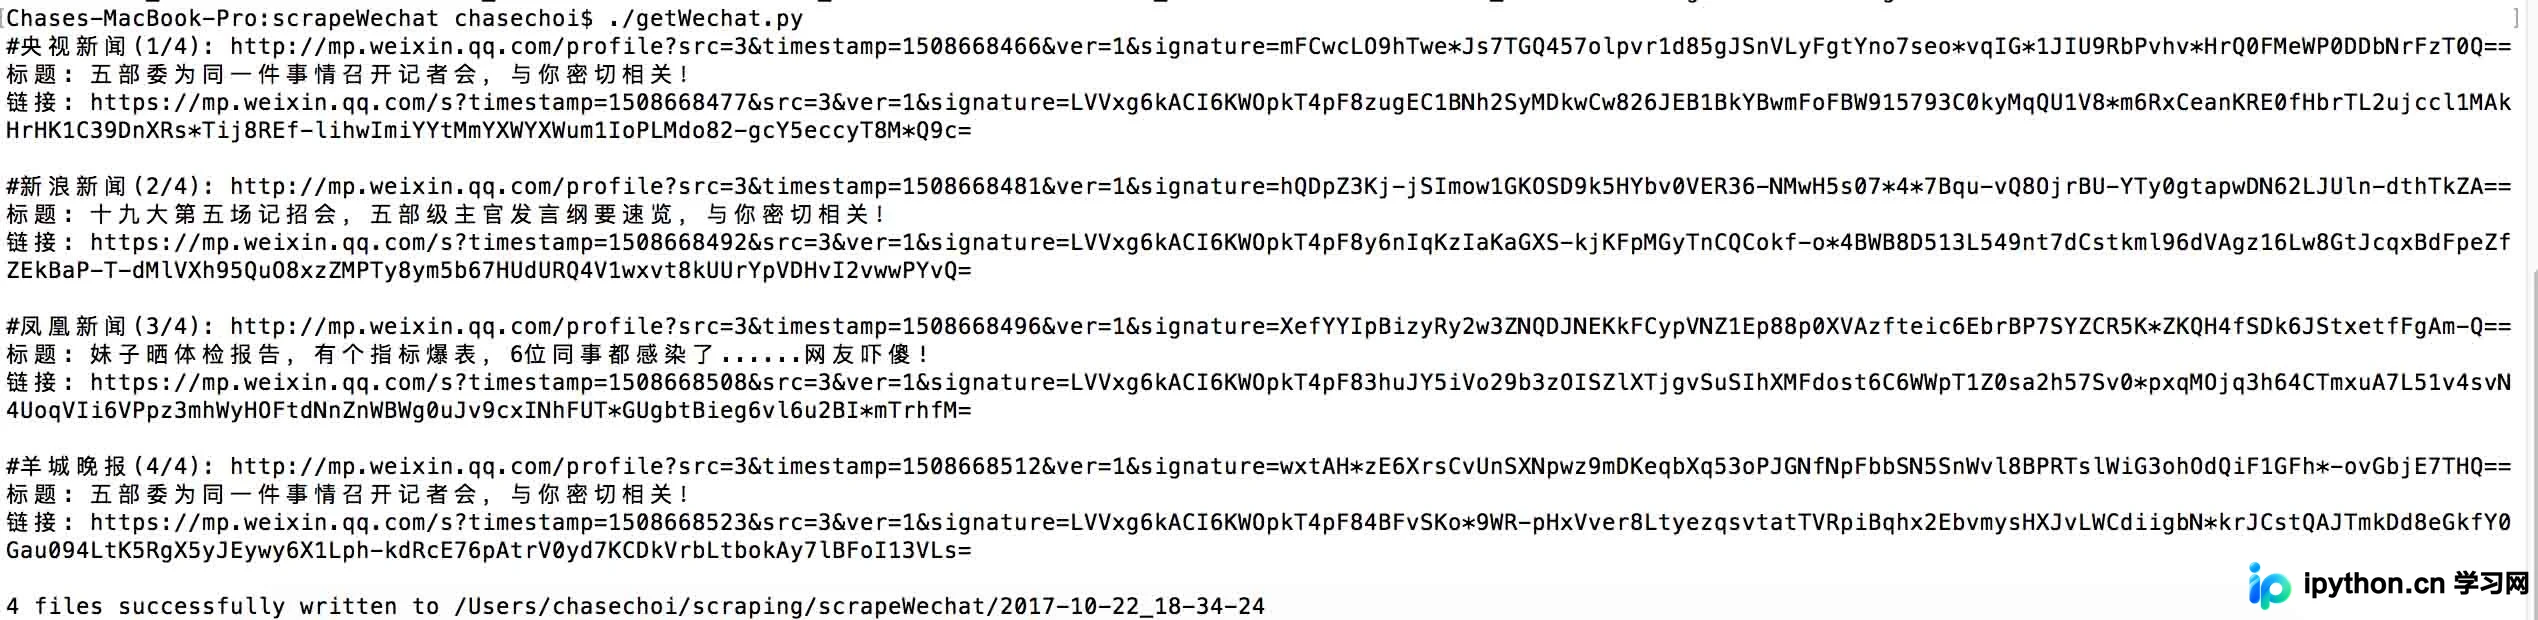
本文介绍如何使用Python抓取指定微信公众号的最新推送文章。针对搜狗微信搜索链接的时效性及动态网页渲染问题,结合Requests与Selenium+PhantomJS技术获取HTML内容,并通过BeautifulSoup提取链接。代码包含处理验证码提示、跨平台文件路径构造及带时间戳的文件保存逻辑,旨在提供一套完整的抓取示例供参考。
本文详解Python爬虫中代理Proxy的配置方法,涵盖urllib和requests两大模块。通过构建ProxyHandler、设置环境变量及Basic Auth语法,实现透明、匿名及高匿代理的灵活调用,助力解决复杂抓取场景。
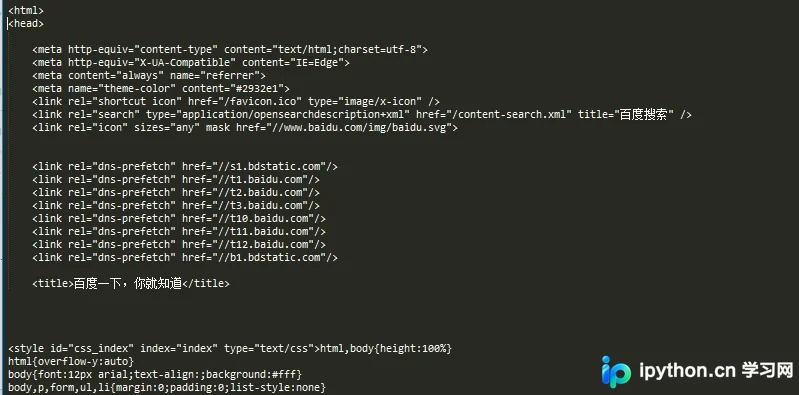
本文介绍Python爬虫基础,详解urllib库的URL组成、请求发起及Response处理。重点讲解HTTPError与URLError的捕获顺序与属性获取,通过百度首页抓取及404错误示例,展示代码实现与调试方法,帮助初学者掌握网络请求与异常处理核心技能。
本文介绍使用Python自动抓取SeeBug漏洞库POC文件的实现方法。通过抓包分析发现下载链接规律,利用Queue和Threading模块构建多线程爬虫。重点解决Referer验证及反爬限制,通过设置延时和动态Headers确保请求稳定,最终实现批量下载POC文件。
本文探讨Python爬虫中常见的乱码问题,介绍如何利用chardet库自动检测网页编码,并通过unicode解码与encode编码将不同字符集(如Big5、GBK、EUC-JP)统一转换为UTF-8,确保数据顺利存入MySQL数据库。
本文介绍基于Python的爬虫实现方案,核心依赖urllib2进行HTTP请求与源码获取,利用BeautifulSoup解析HTML结构。文中提供了完整的类封装代码,涵盖分页链接生成、页面内容提取及数据存储功能,适用于基础网页数据采集场景。
本文深入讲解Python中BeautifulSoup库的使用,涵盖从安装到高级应用的全流程。内容详解HTML树形结构、Tag与NavigableString数据类型,并通过遍历文档树与搜索文档树(find/find_all)两种核心方法,演示如何高效定位和提取HTML中的目标数据,结合代码示例帮助开发者快速掌握网页数据抓取技巧。