

Python爬虫存数据:将抓取结果写入MySQL数据库的步骤

编写爬虫程序时,内存中的字典或列表无法持久保存数据。将解析后的抓取结果落盘到关系型数据库(如 MySQL),可以为后续的数据检索、清洗、去重和业务分析提供可靠支持。完成这一目标的核心流程包括:设计与源数据字段对应的表结构、在 Python 中建立受管的数据库连接、使用参数化 SQL 避免注入风险,以及通过批量提交提升写入吞吐量。
一、数据落库的端到端交互架构
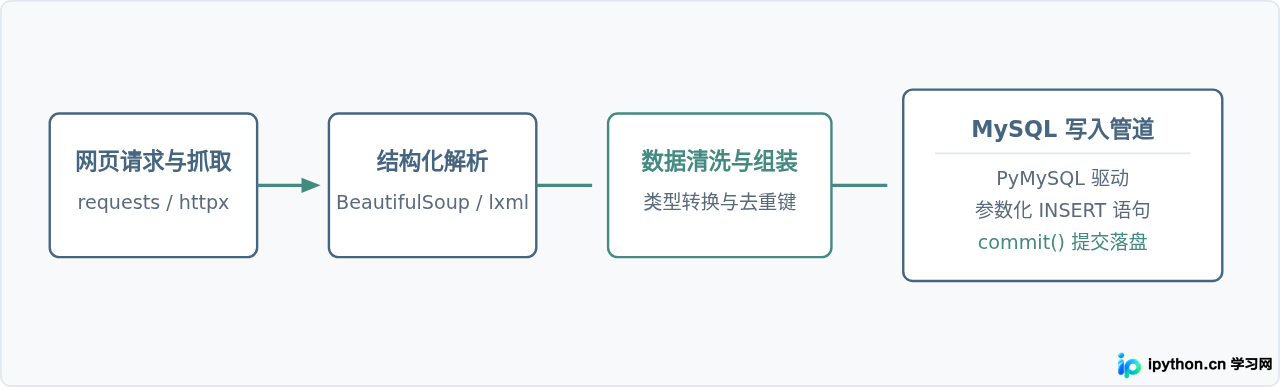
在编写具体代码之前,需要明确爬虫与数据库之间的数据流向。网络爬虫通常由 HTTP 请求、HTML/JSON 解析、字段结构化处理、入库管道(Pipeline)四部分组成。数据库写入环节位于整个管道的末端,负责确保网络断开或解析异常时不破坏现有数据的一致性。
二、环境准备与 MySQL 目标表设计
在 Python 中与 MySQL 建立交互,最常用的纯 Python 驱动是 PyMySQL。它不需要在宿主机上编译 C 库,安装简单且跨平台兼容性良好。使用 pip 在命令行中执行以下命令完成安装:
pip install pymysql接下来需要在 MySQL 中建立对应的数据库和数据表。这里以爬取图书信息的场景为例(包含书名、价格、ISBN编号及采集时间):
CREATE DATABASE IF NOT EXISTS crawler_db DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;

USE crawler_db;

CREATE TABLE IF NOT EXISTS books (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    isbn VARCHAR(32) NOT NULL,
    title VARCHAR(255) NOT NULL,
    price DECIMAL(8, 2) NOT NULL DEFAULT 0.00,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    UNIQUE KEY uq_isbn (isbn)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;utf8mb4,否则一旦网页文本中包含表情符号(Emoji)或特殊数学字符,写入时会抛出 OperationalError: 1366, Incorrect string value。对 isbn 设置唯一索引(UNIQUE KEY),可以天然防止爬虫断点重跑时产生重复数据。
三、核心实现:单条数据的入库操作
数据写入主要分为四个动作:创建数据库连接、获取游标(Cursor)、执行参数化 SQL 插入、提交事务(Commit)。执行后必须关闭游标与连接,释放底层 TCP 套接字。
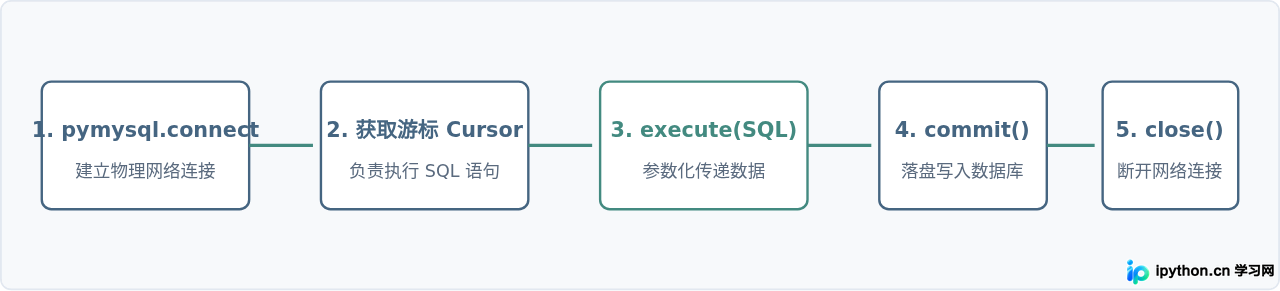
以下是使用参数化查询将抓取项写入数据库的完整可运行代码:
import pymysql

# 模拟爬虫解析提取出来的字典数据
crawled_item = {
    "isbn": "9787115546082",
    "title": "流畅的Python(第二版)",
    "price": 139.00
}

# 1. 建立数据库连接
connection = pymysql.connect(
    host="127.0.0.1",
    user="root",
    password="your_password",
    database="crawler_db",
    charset="utf8mb4",
    autocommit=False  # 明确关闭自动提交,手动掌控事务
)

try:
    with connection.cursor() as cursor:
        # 2. 编写参数化 SQL 模板,避免拼接字符串引起的 SQL 注入
        insert_sql = """
            INSERT INTO books (isbn, title, price)
            VALUES (%s, %s, %s)
            ON DUPLICATE KEY UPDATE
                title = VALUES(title),
                price = VALUES(price);
        """
        # 3. 将变量以元组形式传入 execute 方法
        data_tuple = (
            crawled_item["isbn"],
            crawled_item["title"],
            crawled_item["price"]
        )
        cursor.execute(insert_sql, data_tuple)

    # 4. 显式提交事务
    connection.commit()
    print("数据入库成功!")

except pymysql.MySQLError as error:
    # 发生异常时回滚,避免事务挂起占用锁
    connection.rollback()
    print(f"写入发生错误,已回滚事务: {error}")

finally:
    # 5. 确保在任何情况下均关闭数据库连接
connection.close()O'Reilly),拼接后的语法会直接报错崩溃。通过 cursor.execute(sql, (param1, param2)) 传参,驱动会自动负责转义和类型校验。
四、批量写入与性能调优
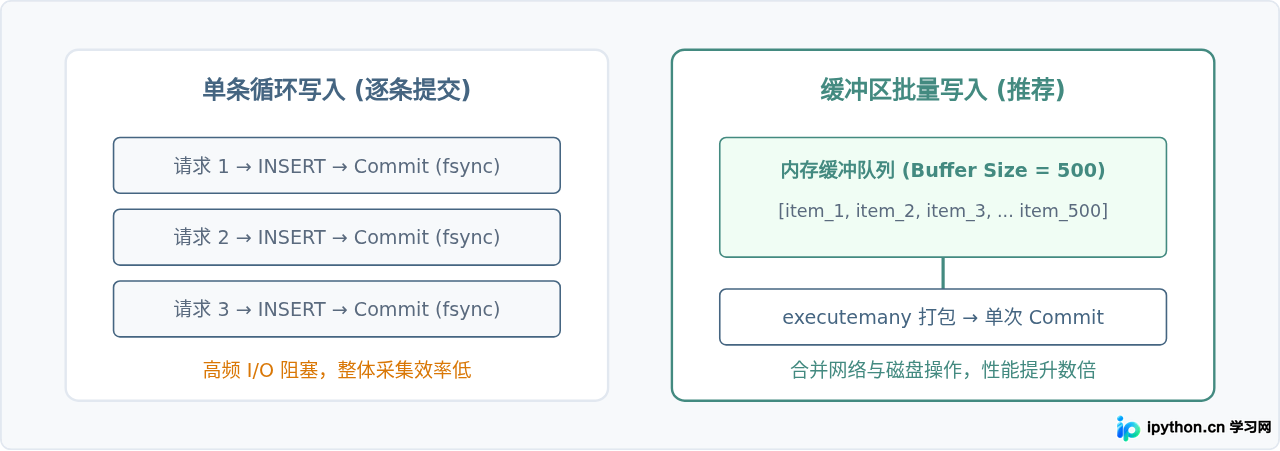
当爬虫采集的数据量达到几千甚至几十万条时,如果每解析一条数据就发起一次 INSERT 并执行一次 commit(),程序的主要时间将全部耗费在网络往返延迟(RTT)和磁盘写日志上。此时应当使用批量插入(Batch Insert)模式。
批量写入通过 cursor.executemany() 将多条记录打包在同一个网络包中发送给 MySQL 服务器,并在累积达到一定批次(例如 500 条)时统一执行一次 commit()。
import pymysql

# 模拟爬虫抓取到的多条记录列表
items_buffer = [
    ("9787111636663", "深入理解计算机系统", 179.00),
    ("9787121362142", "算法导论(原书第3版)", 128.00),
    ("9787115545566", "Python核心编程", 99.00)
]

connection = pymysql.connect(
    host="127.0.0.1",
    user="root",
    password="your_password",
    database="crawler_db",
    charset="utf8mb4"
)

try:
    with connection.cursor() as cursor:
        batch_insert_sql = """
            INSERT INTO books (isbn, title, price)
            VALUES (%s, %s, %s)
            ON DUPLICATE KEY UPDATE
                title = VALUES(title),
                price = VALUES(price);
        """
        # executemany 接收包含多个元组的列表
        rows_affected = cursor.executemany(batch_insert_sql, items_buffer)

    connection.commit()
    print(f"批量入库成功,受影响行数: {rows_affected}")

except pymysql.MySQLError as err:
    connection.rollback()
    print(f"批量写入失败: {err}")
finally:
    connection.close()
五、单条插入与批量插入的核心机制对比
为什么批量写入的速度会有数十倍的提升?下表对比了两种模式在实际开发中的表现与取舍:
| 对比维度 | 单条插入(逐条 Commit) | 批量插入(executemany + 批量 Commit) |
|---|---|---|
| 网络通信开销 | N 条数据对应 N 次 TCP 报文往返,网络延时严重放大 | 数据打包合并,大幅缩减网络往返次数 |
| 磁盘 I/O 压力 | 频繁触发 Redo Log 刷盘(fsync),磁盘压力大 | 按批次合并刷盘,有效利用 I/O 带宽 |
| 吞吐量(每秒写入) | 约 50 ~ 200 行/秒(受限于网络与磁盘) | 可达 2000 ~ 10000+ 行/秒 |
| 异常回滚颗粒度 | 单条隔离,一条报错不影响其他已提交数据 | 整个批次同时回滚,需要对异常数据进行分流或重试 |
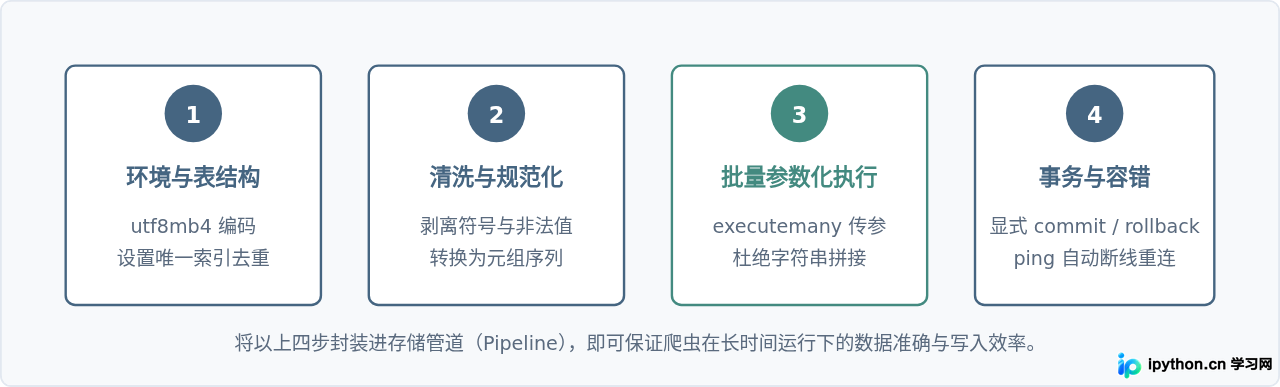
六、爬虫入库全流程规范与常见陷阱排查
在长时间运行的生产爬虫中,以下三个关键隐患直接决定了入库管道的稳定性:
- MySQL 连接超时(2006, 'MySQL server has gone away'):爬虫在解析复杂网页或下载大文件时耗时较长,如果两个请求之间的间隔超过了 MySQL 服务端的
wait_timeout(默认通常为 8 小时,但在部分云数据库上可能只有几分钟),原有连接将被服务端单方面切断。此时应在执行 SQL 前使用connection.ping(reconnect=True)激活并重连。 - 数据类型与脏数据溢出:爬取到的价格、数量字符串中可能包含货币符号或文字(如
"¥128元")。必须在 Python 阶段将其清洗为合法的浮点数或整型,否则强行写入会触发Data truncation警告或直接报错导致事务回滚。 - 主键重复冲突处理:在
INSERT语句中合理运用ON DUPLICATE KEY UPDATE或INSERT IGNORE,使爬虫支持幂等运行,防止重复抓取时因唯一键冲突终止执行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









