Python爬虫开发与项目实战:从静态抓取到分布式架构
本书系统讲解Python网络爬虫开发,从基础原理到Scrapy框架应用,深入解析动态网页抓取与JS加密分析。涵盖单机爬虫至分布式架构设计,通过9个实战项目演示反爬突破与数据去重方案,适合希望掌握大规模数据采集技术的开发者。
2026-10-11
6

本书系统讲解Python网络爬虫开发,从基础原理到Scrapy框架应用,深入解析动态网页抓取与JS加密分析。涵盖单机爬虫至分布式架构设计,通过9个实战项目演示反爬突破与数据去重方案,适合希望掌握大规模数据采集技术的开发者。
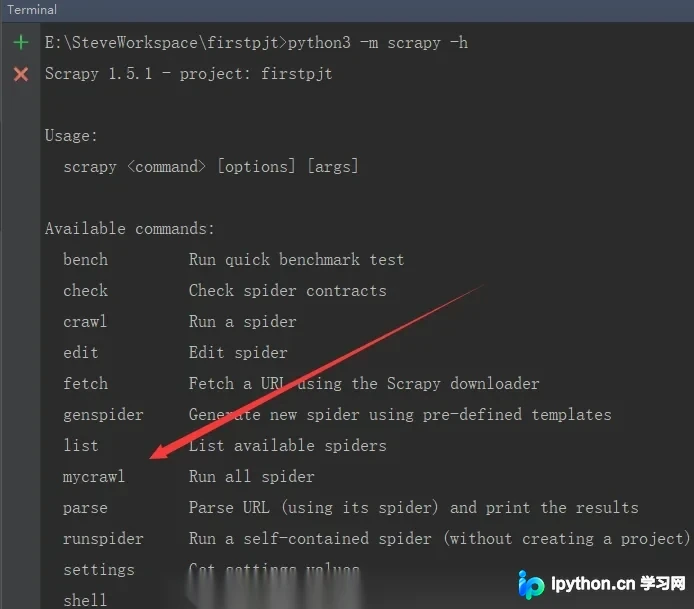
本文介绍Scrapy批量运行爬虫文件的两种实现方式:一是直接修改CrawProcess源码中的run()方法,遍历加载所有爬虫;二是通过创建自定义命令目录(mycmd)并继承修改源码,实现一键启动多个爬虫。详细步骤包括代码修改、目录结构配置及setting.py参数设置,帮助开发者高效管理多个爬虫任务。
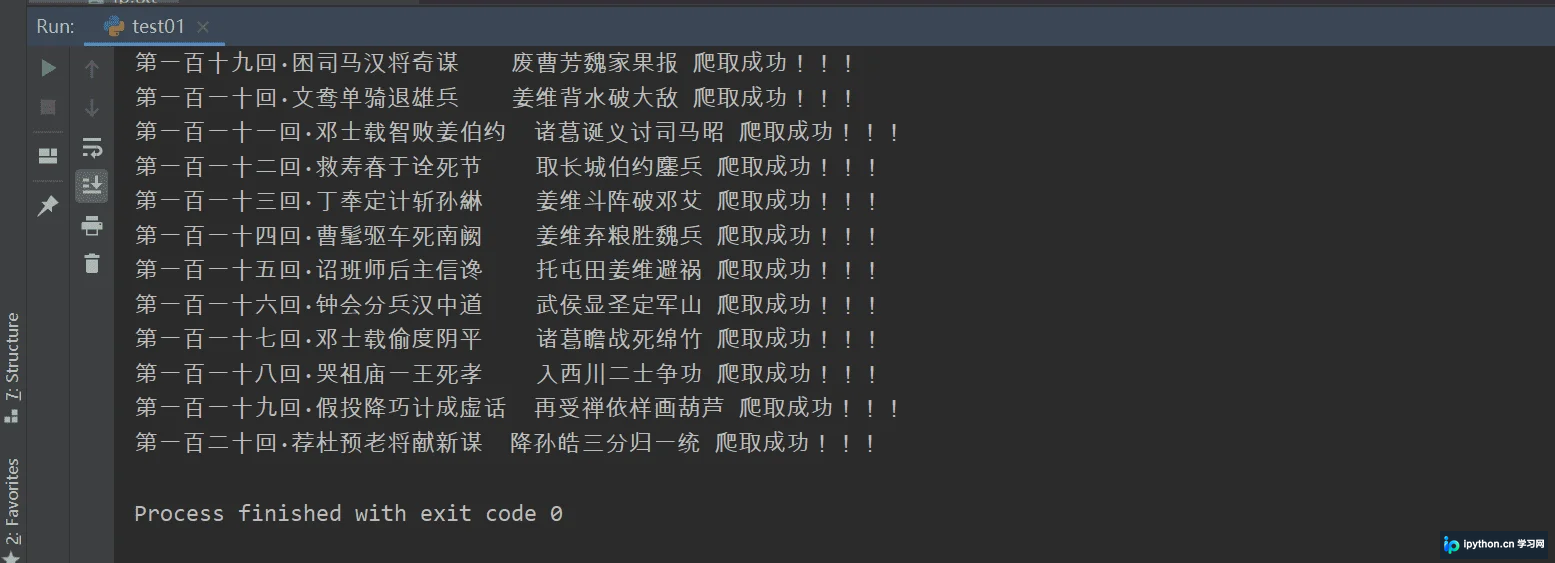
本文详解Python爬虫中BeautifulSoup库的数据解析流程。从环境安装、对象实例化到标签定位(find/select)、文本提取及属性获取,结合三国演义小说爬取案例,演示如何解析列表页与详情页,实现指定内容的持久化存储。
本文探讨学习Python爬虫的实际应用价值,涵盖大数据分析与机器学习的数据源获取。解析网络爬虫工作原理,对比浏览器与爬虫的数据交互差异,并深入分析Python作为爬虫首选语言的技术优势,包括其丰富的标准库、胶水语言特性及高效的执行机制。
针对网站频繁访问同一IP导致封禁的问题,本文详细说明如何通过requests库构建代理池、在HTTP请求中切换IP,并结合随机User-Agent、控制请求间隔与完善异常重试机制,有效提升Python数据采集任务的稳定性与存活率。
面向新手的Python爬虫入门教程,从Python运行环境检查、虚拟环境与核心依赖库配置入手,系统解析HTTP网络请求与DOM树解析机制,提供完整可运行的代码实现与常见报错排障方案。
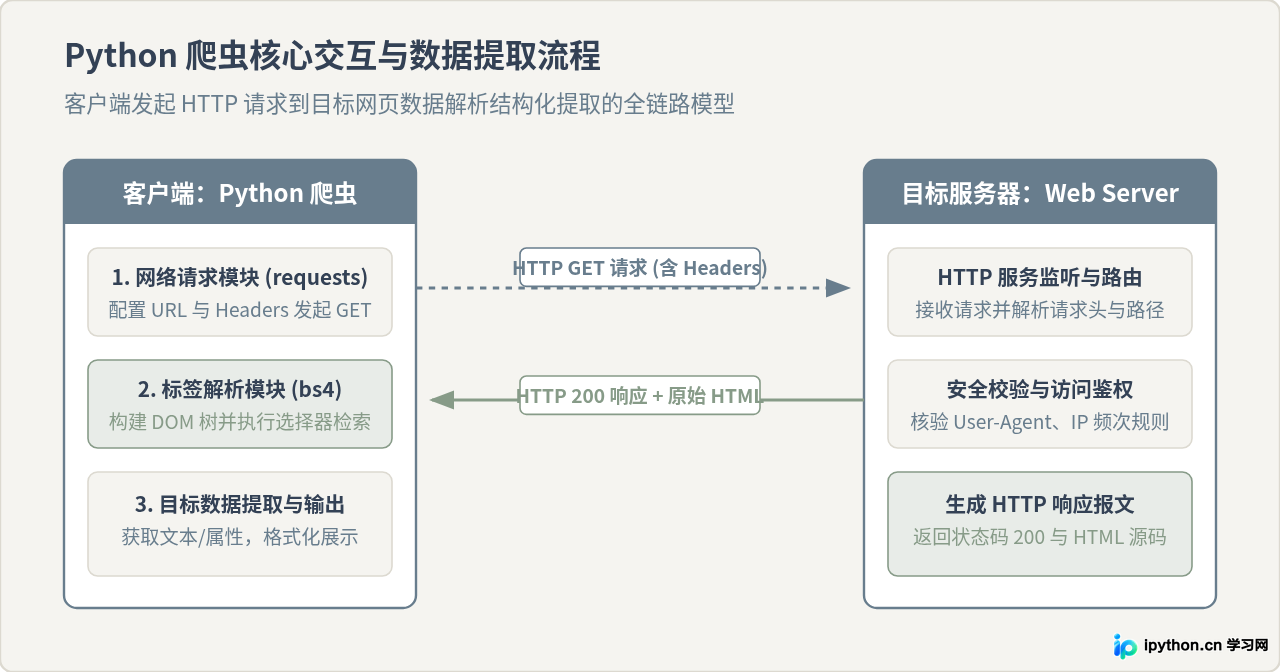
在Python爬虫开发中,高频请求下的DNS解析耗时可能成为性能瓶颈。本文通过实例分析DNS缓存的必要性,提供基于socket模块的缓存实现代码,并详细讲解如何在gevent协程环境下正确应用该缓存机制,以显著降低网络请求延迟。
本文介绍Python爬虫的基本概念与核心原理,重点讲解如何使用urllib和urllib2库发起HTTP请求。通过对比GET与POST两种数据提交方式,演示URL编码、参数传递及登录模拟的具体代码实现,并包含基于try-except的异常处理机制,帮助初学者掌握网络数据抓取的基础操作。
本文介绍如何使用Python爬虫批量抓取城市公交网络站点数据。通过requests获取页面,利用BeautifulSoup解析HTML结构,提取公交线路链接、站点信息及运营详情。代码包含完整的请求、解析与数据保存逻辑,适用于学习网络爬虫基础及数据抓取实战。
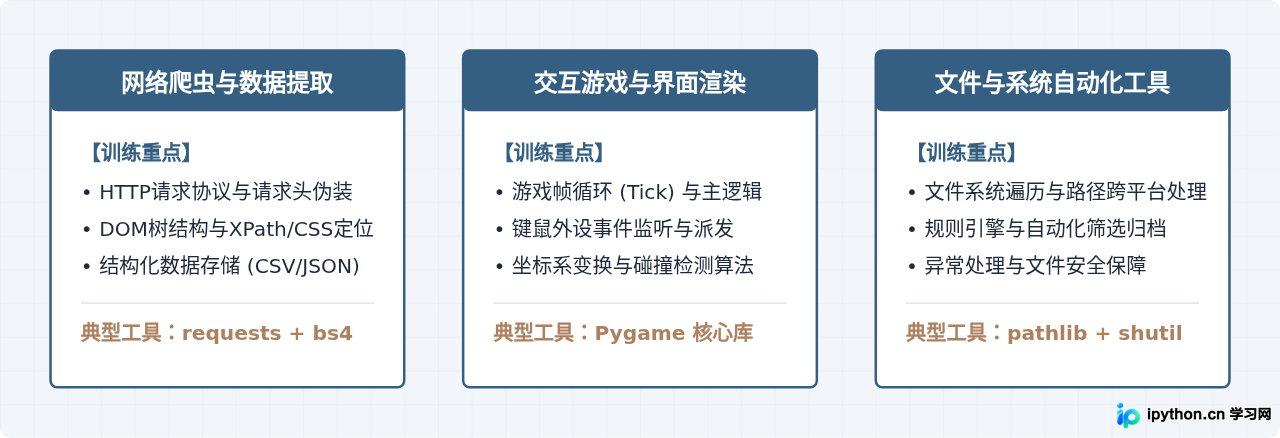
精选爬虫、游戏与自动化三大方向的Python入门练手项目源码,包含完整的实现逻辑、代码注释、运行验证与踩坑说明,帮助读者快速掌握实际开发技能。
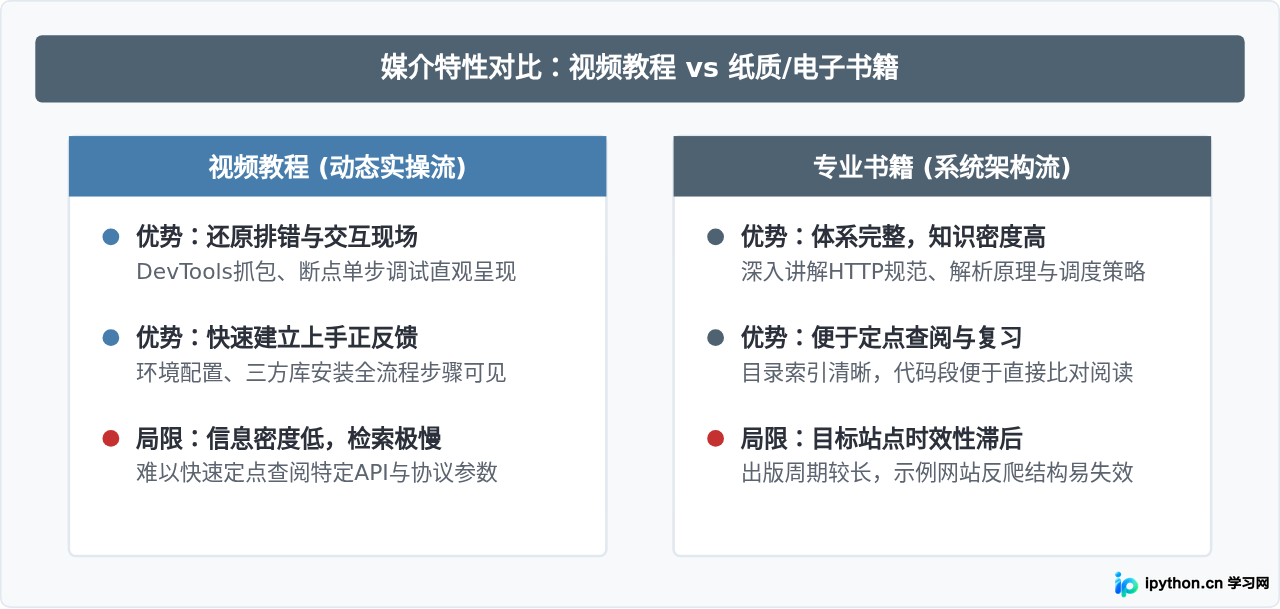
针对自学Python爬虫时买书与看视频的优劣势对比,提供阶段性搭配策略、筛选标准与避坑指南,帮助初学者高效选择适合自己的学习资料。
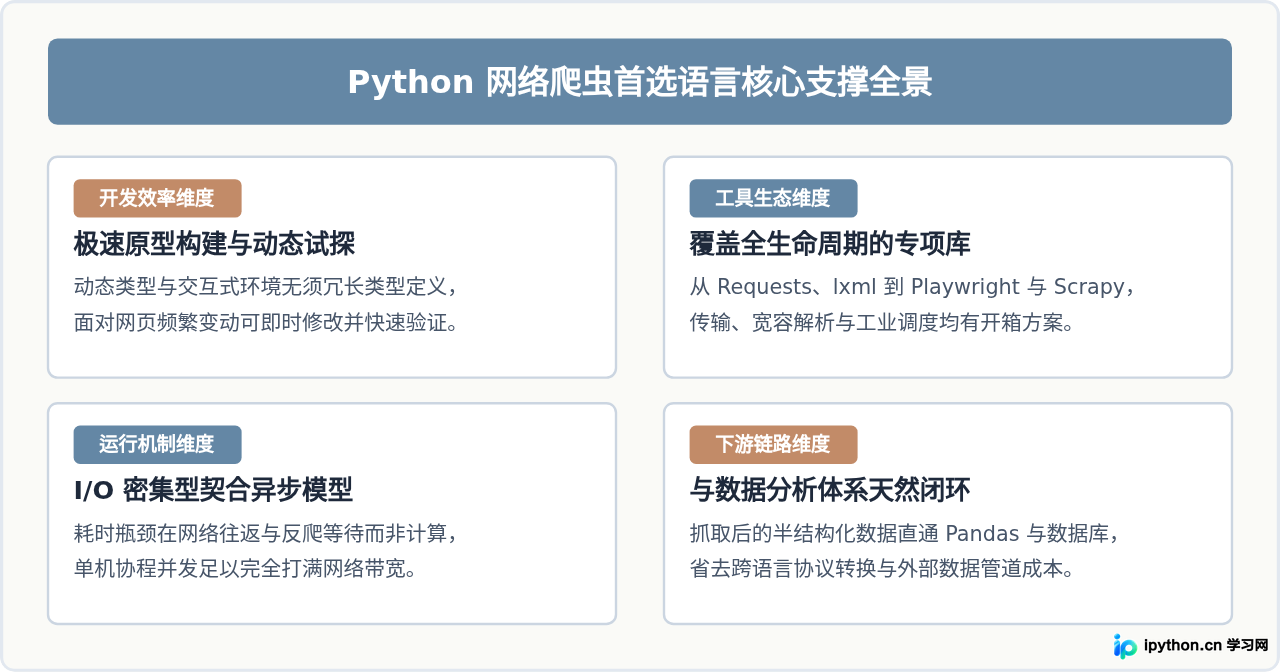
深入解析为什么Python成为网络爬虫开发的首选语言,从原型开发敏捷度、全流程专项工具生态、I/O密集型任务特性及下游数据协同等维度展开系统剖析,并提供技术选型指南。