

适合Python初学者的实战练手项目:爬虫与数据处理案例
专为Python初学者设计的爬虫与数据处理实战案例,手把手跑通网络请求、HTML解析、脏数据清洗到导出结构化CSV的完整闭环,附带完整代码与直观流程图解。
很多初学者在掌握了 Python 的基础语法、循环与函数后,往往会陷入“语法都懂却不知能写什么”的困惑。网络爬虫与数据清洗是检验与巩固编程技能极具性价比的切入点:它既有明确直观的输出结果,又能一次性串联起 HTTP 网络通信、HTML 文档解析、字符串与正则表达式处理,以及结构化数据的持久化存储。本文通过一个精简、规范且合规的“图书目录信息抓取与数据清洗入库”案例,完整演示从发送请求到导出标准 CSV 文件的端到端工作流。
一、项目核心目标与技术选型辨析
一个适合新手的练手项目,应当满足三个核心条件:逻辑闭环、调试成本低、反馈即时。因此,在技术选型上,我们选用 Python 生态中最经典的组合:requests 负责网络请求,beautifulsoup4 负责文档树解析,搭配标准库 csv 或 pandas 完成数据清洗与格式导出。
常见认知辨析:初学者必须一上来就学 Selenium 或 Scrapy 吗?
很多新手看到教程推荐自动化浏览器(如 Selenium)或大型框架(如 Scrapy),便误以为必须先掌握它们才能写爬虫。其实不然:对于结构清晰的静态 HTML 网页,使用无头浏览器会引入庞大的驱动依赖并拖慢执行速度数倍;而大型框架隐藏了底层的 HTTP 状态码与文档遍历机制,反而不利于新手理解核心原理。先用 requests + BeautifulSoup 夯实基础,才是性价比最高的路径。
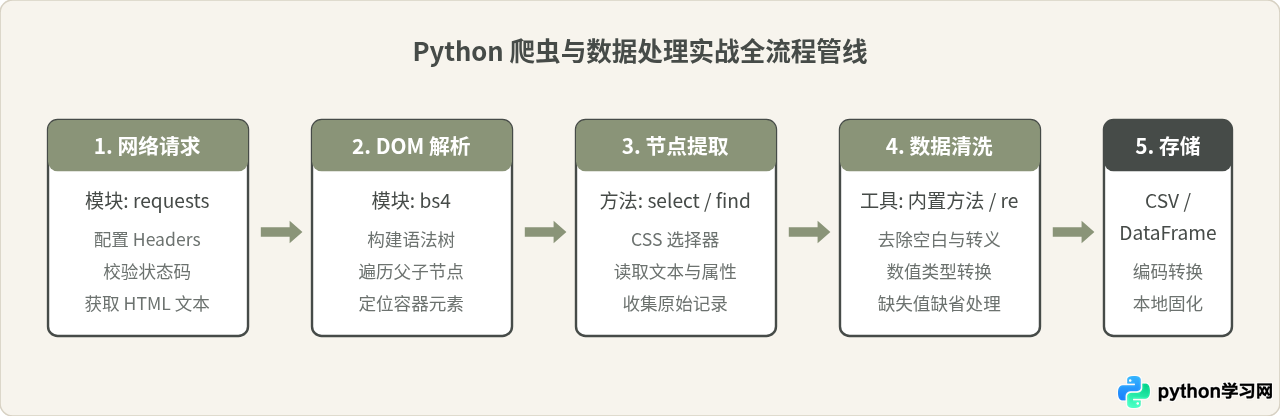
二、环境准备与练习目标设定
在开始编写代码前,需要安装必要的依赖库。打开终端或命令提示符,执行以下命令:
pip install requests beautifulsoup4 pandas为了保证练习环境安全、合法且稳定,我们以公开的爬虫练习网站 books.toscrape.com 为抓取对象。该站点专为开发者测试爬虫设计,数据结构稳定,不设置复杂的反爬屏障,非常适合演练核心操作。
本案例的目标是提取首页展示的所有图书信息,具体包括:
- 图书标题(title):位于商品卡片中
h3 > a的title属性或文本。 - 价格(price):原始文本包含货币符号(如
£51.77),需清洗为纯浮点数。 - 星级评分(rating):以 CSS 类名形式存在(如
star-rating Three),需转化为数字 1 至 5。 - 库存状态(availability):判断当前书籍是否有现货(布尔值或规范化文本)。
三、阶段一:发起请求与 HTML 节点定位
爬虫的第一步是模拟浏览器发送 HTTP GET 请求并获取 HTML 源代码。这里有几个关键细节需要注意:
- 设置请求头(User-Agent):虽然练习站点不严格校验,但在任何爬虫脚本中养成配置请求头的习惯,能有效避免因默认的
python-requests头被直接拦截。 - 校验状态码:始终通过
response.status_code == 200或response.raise_for_status()确保请求成功后再进行解析。 - 解析 DOM 树:使用 BeautifulSoup 将原始文本构造成可以遍历搜索的对象。
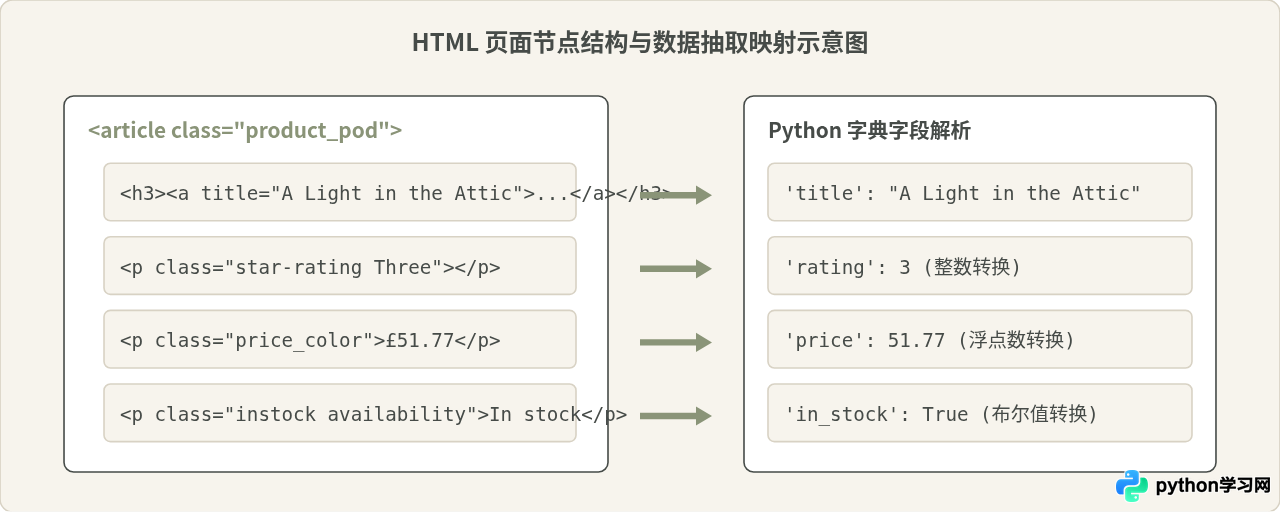
我们首先编写基础抓取逻辑,找到所有代表书籍卡片的 <article class="product_pod"> 容器,然后遍历每个容器提取初始数据。
import requests
from bs4 import BeautifulSoup

url = "https://books.toscrape.com/catalogue/page-1.html"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

response = requests.get(url, headers=headers, timeout=10)
response.raise_for_status()

# 显式使用 utf-8 编码,避免乱码
response.encoding = "utf-8"

soup = BeautifulSoup(response.text, "html.parser")
book_elements = soup.select("article.product_pod")

print(f"成功找到 {len(book_elements)} 本图书信息")
四、阶段二:脏数据清洗与规范化转换
很多新手初写爬虫时,直接把抓到的 text 塞进文件,导致后续分析极其痛苦:数字里夹杂着英镑符号 £、多余的换行符 \n、不可见的全角空格,或是评价用英文单词(如 Three)表达无法求均值。数据处理的核心任务,就是把网页上的“人类可读展示文本”,转化为数据库或数据分析软件易处理的“机器可读强类型值”。
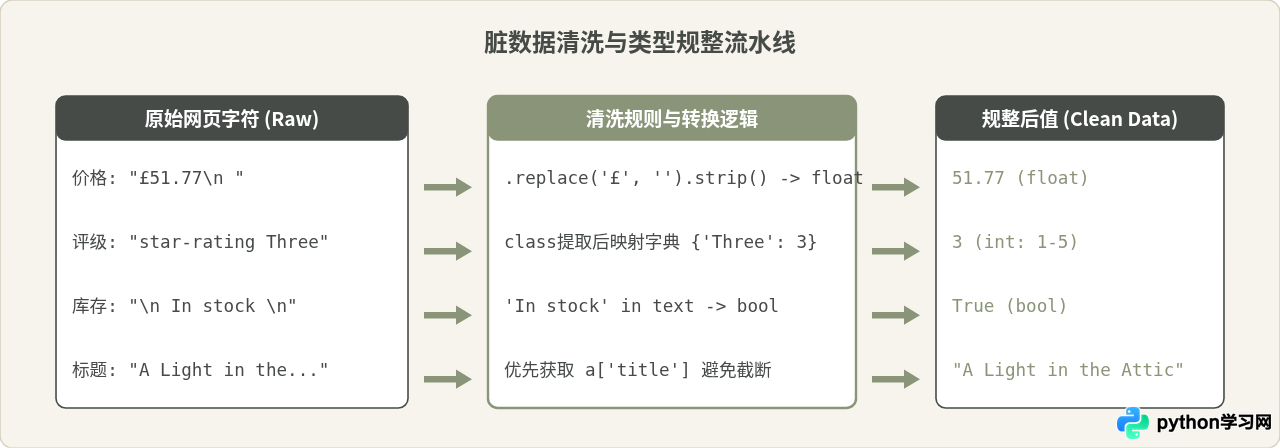
针对具体字段的清洗方案设计如下:
- 评级映射字典:网页通过 CSS 类名
One、Two、Three、Four、Five来标记评级,我们可以构造一个简单的 Python 字典{"One": 1, "Two": 2, ...}进行恒等转换。 - 完整标题提取:网页链接的文本可能因为排版被省略号截断(如
A Light in the...),但其完整的全称保存在<a>标签的title属性中。提取时优先读取属性值。 - 金额数值化:去掉首部非数字符号(如
£)并剔除空白字符,转换成float类型,以便后续计算均价、区间统计。
五、阶段三:完整代码实现与持久化存储
下面给出一段模块化、可直接运行的完整脚本。代码将抓取、清洗与写入 CSV 紧密结合,并附带错误防护机制与友好的控制台输出:
import requests
from bs4 import BeautifulSoup
import pandas as pd

def parse_book_item(book_elem):
    """
    清洗单个图书卡片并返回规整后的字典
    """
    # 1. 提取标题:优先取 a 标签中的完整 title 属性
    a_tag = book_elem.select_one("h3 a")
    title = a_tag.get("title", "").strip() if a_tag else ""
    if not title and a_tag:
        title = a_tag.get_text(strip=True)

    # 2. 提取价格并清洗为 float
    price_elem = book_elem.select_one("p.price_color")
    price_raw = price_elem.get_text(strip=True) if price_elem else ""
    # 去除常见的英镑货币符号及干扰空格
    clean_price = price_raw.replace("£", "").replace("Â", "").strip()
    try:
        price = float(clean_price)
    except ValueError:
        price = 0.0

    # 3. 提取星级评分并映射为整数 1-5
    rating_map = {
        "One": 1,
        "Two": 2,
        "Three": 3,
        "Four": 4,
        "Five": 5
    }
    star_elem = book_elem.select_one("p.star-rating")
    rating_val = 0
    if star_elem:
        classes = star_elem.get("class", [])
        for cls in classes:
            if cls in rating_map:
                rating_val = rating_map[cls]
                break

    # 4. 提取库存状态并转换为布尔值
    stock_elem = book_elem.select_one("p.instock.availability")
    stock_text = stock_elem.get_text(strip=True) if stock_elem else ""
    in_stock = "In stock" in stock_text

    return {
        "title": title,
        "price": price,
        "rating": rating_val,
        "in_stock": in_stock
    }

def scrape_and_save(page_url, output_filename="books_cleaned.csv"):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    print(f"正在抓取页面: {page_url}")
    try:
        resp = requests.get(page_url, headers=headers, timeout=10)
        resp.raise_for_status()
        resp.encoding = "utf-8"
    except requests.RequestException as e:
        print(f"网络请求失败: {e}")
        return

    soup = BeautifulSoup(resp.text, "html.parser")
    items = soup.select("article.product_pod")

    data_list = []
    for item in items:
        data = parse_book_item(item)
        data_list.append(data)

    # 使用 Pandas 组装并导出数据
    df = pd.DataFrame(data_list)

    # utf-8-sig 编码可以防止 Excel 打开中文/特殊字符时出现乱码
    df.to_csv(output_filename, index=False, encoding="utf-8-sig")
    print(f"成功保存 {len(df)} 条记录至 {output_filename}")

    # 简要打印统计概览
    print("\n数据概览与清洗结果:")
    print(df.head(3))
    print(f"\n平均价格: £{df['price'].mean():.2f}")
    print(f"平均评分: {df['rating'].mean():.2f} 星")

if __name__ == "__main__":
    target_url = "https://books.toscrape.com/catalogue/page-1.html"
    scrape_and_save(target_url, "books_cleaned.csv")
运行结果示例
运行该程序后,终端将输出抓取成功的条目数量以及清洗后的 DataFrame 摘要,并在当前工作目录下生成 books_cleaned.csv 文件:
正在抓取页面: https://books.toscrape.com/catalogue/page-1.html
成功保存 20 条记录至 books_cleaned.csv

数据概览与清洗结果:
                                 title  price  rating  in_stock
0                 A Light in the Attic  51.77       3      True
1                   Tipping the Velvet  53.74       1      True
2                           Soumission  50.10       1      True

平均价格: £38.05
平均评分: 2.95 星
六、初学者常见报错与排查清单
在实际编码过程中,初学者通常会遭遇以下三类典型问题,提前了解原因能大幅减少调试弯路:
| 现象 / 报错 | 背后的真实原因 | 修正与预防方法 |
|---|---|---|
AttributeError: 'NoneType' object has no attribute 'get_text' |
CSS 选择器未命中任何元素(如类名拼写错误或该商品缺字段),直接调用方法引发异常。 | 在调用 .get_text() 或取属性前,先通过 if elem: 做空值防御判断。 |
| 导出的 CSV 文件在 Excel 中打开显示为乱码 | Windows 平台的 Excel 默认按系统 ANSI 或带 BOM 的 UTF-8 打开,普通的 utf-8 无法正确识别。 |
写入 CSV 时指定 encoding='utf-8-sig',添加签名即可完美兼容。 |
ValueError: could not convert string to float |
待清洗的字符串中混有不可见的空白符、特殊币种标识或英文字符。 | 转换前通过 .replace() 或正则表达式 re.sub(r'[^\d.]', '', text) 彻底过滤非数字字符。 |
七、进阶成长路径与实战总结
完成单页静态数据的“抓取-清洗-存储”只是第一步。在具备了基础工程经验后,初学者可以按照下述梯度循序渐进地提升自己的数据获取与加工能力:
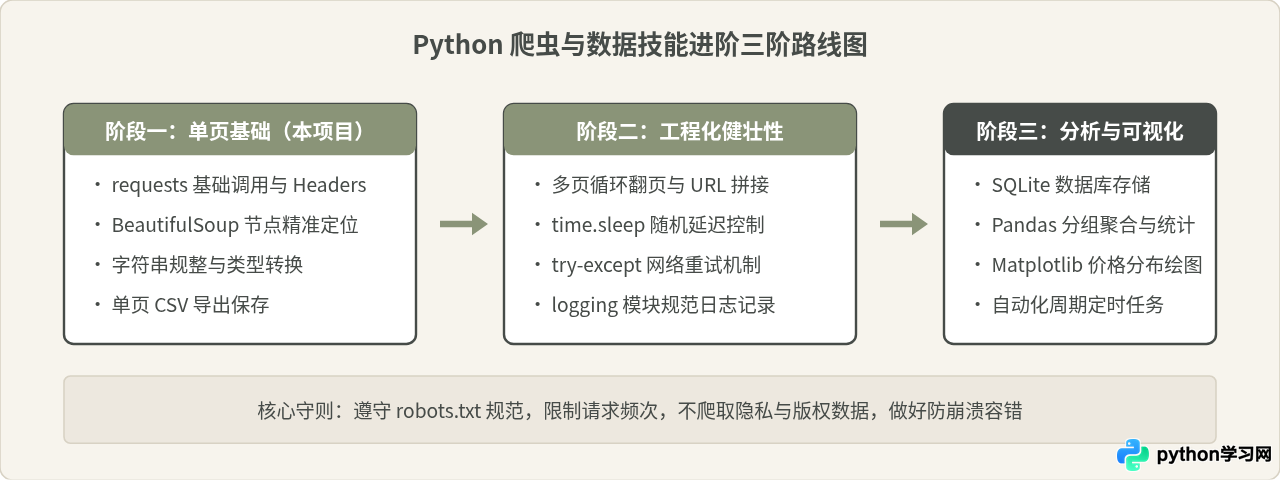
通过本文的案例演练,相信你已经建立了对网络数据抓取与处理的基本直觉。爬虫的本质并不神秘,关键在于仔细观察页面源码、合理使用选择器、做好数据清理以及尊重目标站点的服务边界。动手尝试把本文的代码扩展为抓取前 3 页的数据并计算全站最畅销书籍的均价,你对 Python 实战的理解便会再上一个台阶。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









