

Python常用第三方库有哪些?按数据、Web和自动化分类盘点
一、数据科学与处理常用库
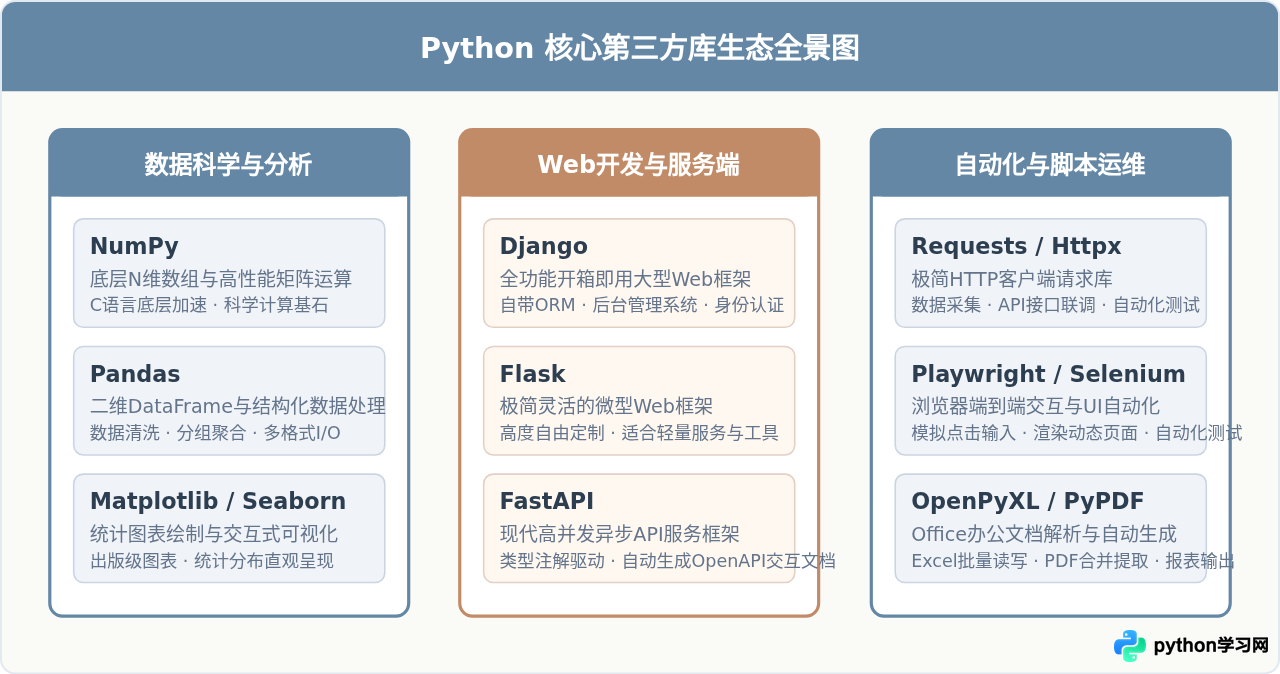
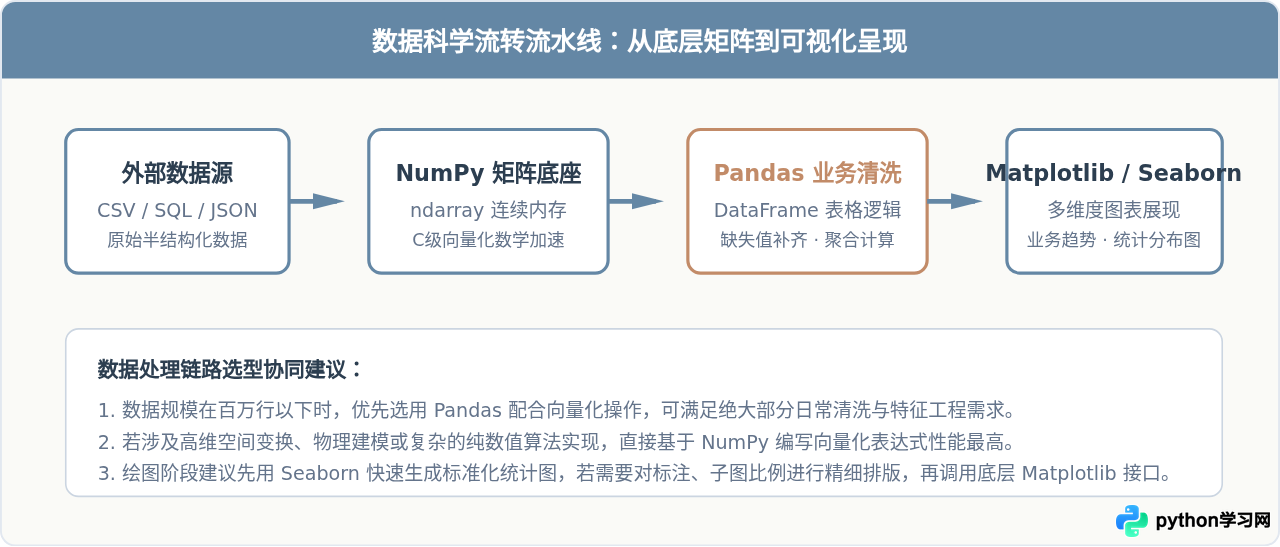
在数据分析与科学计算领域,Python构建了统一且高效的标准栈。这一体系通常以底层线性代数计算库为基底,向上延伸出表格分析工具与可视化展现工具。
1. NumPy:高性能多维数组与数值计算基石
NumPy(Numerical Python)是几乎所有Python数据科学库的底层核心。Python自带的list在处理海量数值时存在明显的内存开销与解释器寻址损耗,而NumPy通过连续内存存储与底层C/Fortran实现,提供了强大的ndarray(N维数组)对象与向量化广播运算机制。
import numpy as np

# 创建连续多维数组并执行向量化计算
data_array = np.array([10.5, 20.0, 35.2, 42.8])
# 向量化广播运算:所有元素乘以标量,无须编写显式循环
scaled_array = data_array * 1.5

print("均值:", np.mean(scaled_array))
print("标准差:", np.std(scaled_array))
适用场景: 矩阵乘法、线性代数求解、傅里叶变换、统计量聚合计算。它通常不直接用于业务端表格操作,而是作为Pandas与机器学习算法的底层计算引擎。
2. Pandas:结构化数据分析与清洗神器
Pandas构建在NumPy之上,提供了两种核心数据结构:Series(一维带标签序列)与DataFrame(二维表格数据结构)。在日常业务分析、报表处理与ETL流水线中,Pandas是使用频率最高的库。
import pandas as pd

# 示例:构建用户访问DataFrame并进行统计清洗
raw_records = {
    "user_id": [101, 102, 103, 104, 105],
    "department": ["研发", "市场", "研发", "运营", "研发"],
    "score": [88, 92, None, 79, 95]
}

df = pd.DataFrame(raw_records)

# 1. 缺失值填充
df["score"] = df["score"].fillna(df["score"].mean())

# 2. 条件筛选与分组聚合
dept_summary = df[df["score"] >= 80].groupby("department")["score"].agg(["count", "mean"])
print(dept_summary)
适用场景: CSV/Excel/SQL/Parquet数据源清洗、缺失值处理、时间序列重采样、透视表分析以及跨表关联(Merge/Join)。
3. Matplotlib 与 Seaborn:统计数据可视化
清洗完成的数据需要通过图表传达规律。Matplotlib提供了对画布、坐标轴、刻度和图元对象的精细控制;而Seaborn则是基于Matplotlib的高阶封装,内置了更具现代感的默认配色与高级统计绘图函数(如热力图、小提琴图、回归拟合线)。
二、Web 开发与接口服务常用库
在后端服务、API开发与轻量微服务构建中,Python拥有多种设计理念鲜明的框架。选择合适的框架不仅决定了代码开发速度,也直接影响后续系统的扩展维护成本。
1. FastAPI:新一代现代高性能异步 API 框架
FastAPI是近年来增长最迅速的Python Web框架。它基于ASGI标准规范、Python 3.6+原生的Type Hints(类型注解)以及Pydantic数据验证库构建,兼具高性能与极致的开发体验。
from fastapi import FastAPI
from pydantic import BaseModel, Field

app = FastAPI(title="用户服务API")

# 基于Pydantic定义请求入参校验模型
class ItemModel(BaseModel):
    name: str = Field(..., example="机械键盘")
    price: float = Field(..., gt=0, description="价格必须大于0")
    is_active: bool = True

@app.post("/items/")
async def create_item(item: ItemModel):
    # 框架自动完成类型转换、校验及格式错误提示
    tax = item.price * 0.13
    return {"status": "success", "data": item, "tax": tax}
核心优势: 原生支持async/await协程异步处理;自动化生成符合OpenAPI规范的交互式Swagger UI文档;入参与出参类型由代码自动校验,极大减少边界异常。
2. Flask:极简通用的微型框架
Flask秉持微核心(Microframework)设计哲学。核心本身仅包含路由调度、请求上下文和Jinja2模板引擎,数据库访问、权限控制等所有业务组件均通过扩展(如Flask-SQLAlchemy、Flask-Migrate)按需插拔引入。
from flask import Flask, jsonify, request

app = Flask(__name__)

@app.route("/health", methods=["GET"])
def health_check():
    return jsonify({"status": "healthy", "service": "auth-core"})

if __name__ == "__main__":
    app.run(port=5000)
适用场景: 内部简单运维工具、小型原型验证(PoC)、单点功能微服务。适合需要极高定制自由度的项目。
3. Django:自带完整电池的企业级全栈框架
Django倡导“开箱即用(Batteries-Included)”与约定优于配置。它内置了生产级的ORM数据库映射器、自带完整的管理后台(Admin Site)、用户身份验证系统(Auth)、防CSRF/XSS安全中间件及自动化数据库迁移工具。
适用场景: 大型内容管理系统(CMS)、多角色权限复杂的企业内部业务管理后台、需要快速交付完整后台与数据库结构的全栈业务系统。
| 对比维度 | FastAPI | Flask | Django |
|---|---|---|---|
| 定位与架构 | 轻量异步 API 微服务 (ASGI) | 轻量同步微框架 (WSGI) | 全功能开箱即用全栈框架 (WSGI/ASGI) |
| 数据验证机制 | Pydantic 类型提示强校验 | 无内置,需自行编写或外接扩展 | 内置 Django Forms & Model 校验 |
| 后台管理系统 | 无(专注于接口通信) | 无(需第三方扩展如Flask-Admin) | 内置高度可定制的 Django Admin |
| API 文档生成 | 全自动生成 Swagger / ReDoc | 需引入 Flask-RESTX 等外置库 | 需结合 Django REST Framework 扩展 |
| 典型最佳应用 | 微服务 API、高并发接口、AI模型服务 | 小型工具、单页接口、原型试错 | 企业运营后台、综合门户、复杂业务系统 |
三、自动化与任务脚本常用库
Python在办公效率提升、数据抓取和系统自动化巡检领域占据主导地位。掌握网络通信、页面模拟与文档格式转换库,能够大幅缩减日常重复性工作耗时。
1. Requests:人性化的 HTTP 网络请求客户端
Requests是Python生态中公认的“代码优雅”典范,用于向第三方接口或Web页面发起HTTP/HTTPS请求。与标准库urllib繁琐的流处理相比,Requests提供直观的API、自动Cookie保持(Session机制)以及开箱即用的JSON解析能力。
import requests

url = "https://httpbin.org/post"
headers = {"User-Agent": "AutomationBot/1.0"}
payload = {"task_id": "report_001", "action": "generate"}

# 发起 POST 请求并自动序列化 JSON
response = requests.post(url, json=payload, headers=headers, timeout=10)

if response.status_code == 200:
    result = response.json()
    print("服务端响应成功:", result.get("json"))
else:
    print(f"请求异常,状态码: {response.status_code}")
2. OpenPyXL:Excel 自动化读写与批量加工
企业日常运营涉及大量.xlsx文件的汇总与排版。OpenPyXL支持直接读写Excel文件中的单元格、工作表(Worksheet)、计算公式以及单元格字体与边框样式。
from openpyxl import Workbook
from openpyxl.styles import Font, PatternFill

wb = Workbook()
ws = wb.active
ws.title = "业务巡检统计"

# 写入表头并配置高亮样式
headers = ["任务编号", "执行主机", "耗时(ms)", "执行状态"]
ws.append(headers)

header_font = Font(name="微软雅黑", size=11, bold=True, color="FFFFFF")
header_fill = PatternFill(start_color="6487A5", end_color="6487A5", fill_type="solid")

for col_num in range(1, len(headers) + 1):
    cell = ws.cell(row=1, column=col_num)
    cell.font = header_font
    cell.fill = header_fill

# 写入业务巡检行数据
ws.append(["TASK-20261025", "node-prod-01", 145, "正常"])
ws.append(["TASK-20261026", "node-prod-02", 320, "预警"])

wb.save("automation_report.xlsx")
3. Playwright 与 Selenium:浏览器端到端交互与自动化测试
在面对需要登录验证、滑动验证码或由JavaScript动态异步渲染的前端单页应用时,纯HTTP请求无法获取最终呈现的DOM。此时需要借助自动化浏览器驱动工具:
- Selenium: 行业传统标杆,兼容各大主流浏览器驱动(ChromeDriver/GeckoDriver),文档与社区积累最雄厚。
- Playwright: 由微软主导维护的现代自动化工具,内置自动等待(Auto-wait)机制、支持网络请求拦截Mock,执行速度快,支持无头(Headless)高速模式。
四、第三方库的规范化安装与虚拟环境配置
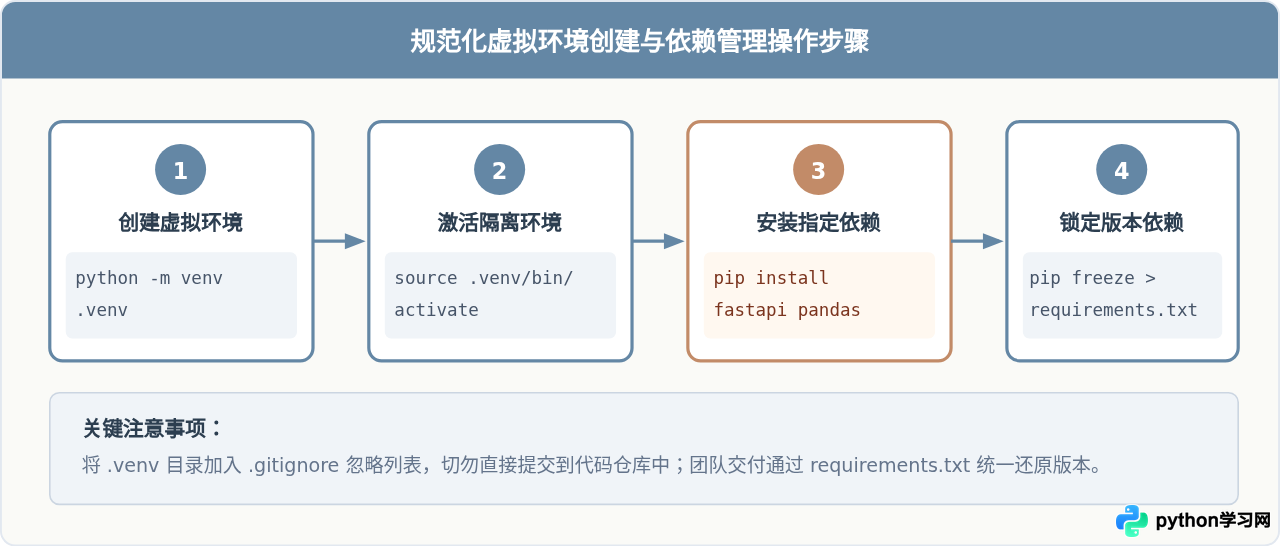
在多项目协同开发中,切忌直接在系统全局Python环境中执行pip install。不同项目依赖同一第三方库的不同版本(例如Django 3.2与Django 4.2)会导致全局环境被破坏并产生版本冲突。必须建立统一的虚拟环境(Virtual Environment)隔离规范。
操作步骤与命令演示
-
在工程根目录下生成独立虚拟环境:
# 在当前目录下创建名为 .venv 的虚拟环境目录 python -m venv .venv -
激活虚拟环境:
在不同操作系统下激活脚本路径略有差异:
# Linux / macOS 终端执行:
source .venv/bin/activate

# Windows PowerShell 终端执行:
.venv\Scripts\Activate.ps1
激活成功后,终端提示符前会显示环境标识前缀
(.venv)。 -
加速安装目标第三方库:
国内网络访问默认PyPI源速度较慢时,可指定官方镜像源镜像加速:
pip install pandas fastapi uvicorn requests -i https://pypi.tuna.tsinghua.edu.cn/simple -
固化并生成版本锁定描述清单:
pip freeze > requirements.txt下游部署或团队成员克隆代码后,只需执行
pip install -r requirements.txt即可100%还原依赖环境。
Microsoft Visual C++ 14.0 or greater is required 或缺少gcc编译器,通常是因为所安装库没有对应平台预编译好的 .whl 二进制包。优先升级本地pip版本(python -m pip install --upgrade pip),新版pip会自动匹配下载官方构建好的Wheel包,避免本地触发源码编译。
五、全景选型总结与决策建议
为了让不同应用背景的开发者在启动新项目时能迅速敲定技术栈,我们将三大分类的核心能力与推荐选型逻辑汇总成如下决策矩阵:
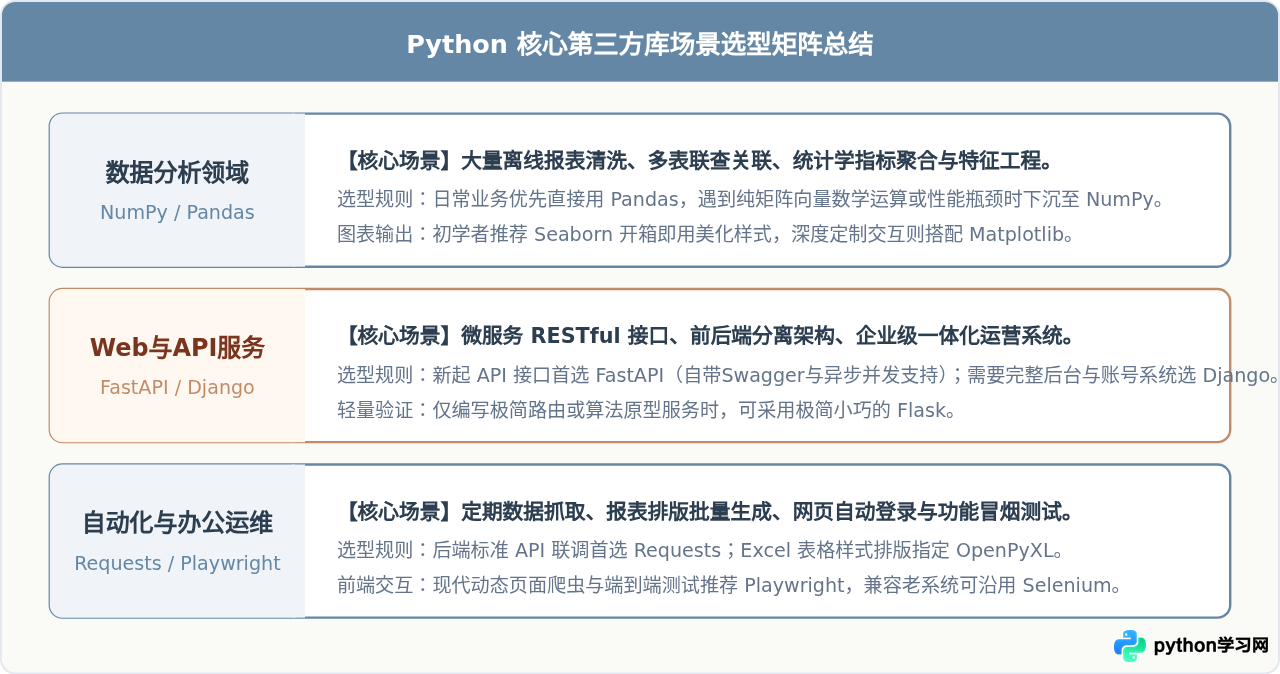
综上所述,Python强大的生态魅力不仅在于单项第三方库的独立性能,更在于它们之间清晰的边界分工与模块化协同。在实际工程落地时,遵循“先用 venv 隔离环境、依据输入输出形态选取基础库、最后通过 requirements.txt 固化标准”的工程规范,即可构建出稳定、高效且易于维护的应用系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









