

Python 语音识别框架实现详解
本文介绍基于 Python 和 Windows SAPI 接口的语音识别与合成实现方法。通过 win32com 库调用系统组件,构建包含特定指令的语法规则,实现语音指令监听与对应的语音反馈功能,适用于简单的桌面语音控制场景。
2026-10-13
18

本文介绍基于 Python 和 Windows SAPI 接口的语音识别与合成实现方法。通过 win32com 库调用系统组件,构建包含特定指令的语法规则,实现语音指令监听与对应的语音反馈功能,适用于简单的桌面语音控制场景。
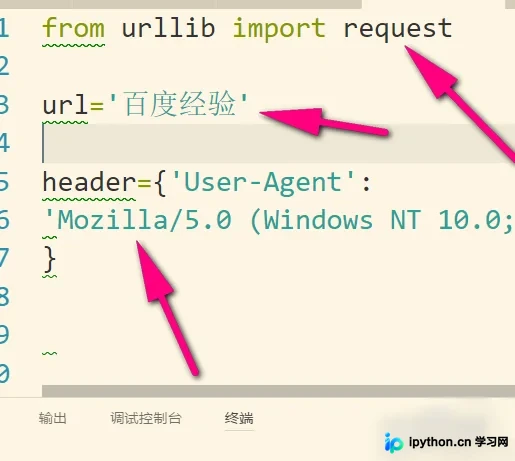
本文详解Python3爬虫中请求头Header的构建方法。通过浏览器开发者工具Network面板提取User-Agent,结合Request类构造GET或POST请求,并演示使用urlopen发送请求的完整流程,帮助开发者有效伪装浏览器身份。
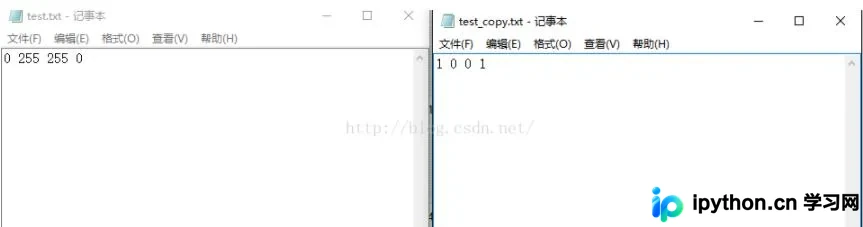
本文介绍了使用Python读取txt文件内容并修改字符的方法。通过遍历读取的每一行数据,将数值0替换为1,将255替换为0,最后将处理后的结果写入新的txt文件。虽然算法复杂度较高,但实现了预期的数据转换功能,适合需要简单文本处理场景的参考。
本文介绍在Python中判断一个列表是否包含另一个列表全部元素的两种方法。第一种通过for循环配合in关键字进行逐个检查;第二种利用集合特性,将列表转换为集合后判断子集关系。文中提供了具体的代码示例及运行结果,帮助开发者快速掌握相关技巧。
本文介绍在Python中获取二维数组行列数的两种常用方法。第一种利用numpy库的shape属性,可一次性获取形状或单独提取行列数值;第二种针对原生列表构成的二维数组,通过len函数分别计算外层和内层长度。文章包含具体代码示例及运行结果,适用于Python基础数据处理场景。
本文详细介绍利用Python爬虫下载网页中图片、文档等资源的三种方法。通过解析网页源码获取资源URL,分别演示了使用urllib.urlretrieve直接下载、requests库同步全量下载以及开启stream参数进行分块写入的实现代码。重点解析了分块下载在处理大文件时节省内存的优势,并提供了批量下载多个资源的通用逻辑思路。
本文详解Python爬虫中如何使用代理IP防止IP被封。通过urllib.request的ProxyHandler构建自定义opener,并调用install_opener设置全局代理,使urlopen默认使用代理IP。文中涵盖HTTP/HTTPS代理设置、端口配置及常见连接拒绝错误的排查方法,帮助开发者实现稳定的数据抓取。
本文详细介绍如何使用Python构建基础爬虫架构。通过解析urllib库的网络请求功能与BeautifulSoup的HTML解析能力,演示从导入模块、打开网址到提取节点信息的完整流程。同时涵盖常见错误如HTTPError和None值的排查与处理,帮助开发者掌握基础爬虫的核心步骤与异常处理机制。
本文介绍在Python中读取TXT文件并提取特定位置字符的方法。通过open函数打开文件,使用readlines()读取所有行,再结合split()方法以固定字符为分隔符进行分割,最后通过索引n获取目标字符串并写入新文件。
本文介绍如何在Python3环境中使用pandas和pandas_datareader库获取股票数据。详细记录了安装步骤,并针对运行时报错的ImportError(is_list_like导入失败)和ImmediateDeprecationError(Yahoo Daily弃用)提供了具体的代码修改方案,包括修改fred.py和data.py文件中的导入路径及注释弃用报错语句。
本文介绍在Python中将TXT文件数据读取并转换为NumPy数组或列表的方法。针对包含混合数据的TXT文件,提供逐行处理并转为数组的代码示例;针对纯数字文件,推荐loadtxt直接读取。同时详细解析split和strip函数的语法、参数及实际应用案例,帮助开发者高效处理文本数据。
本文介绍如何使用Python读取通达信股票数据文件(.day)。通过struct模块解析二进制数据,处理日期、价格及成交量字段,最终将结果封装为pandas DataFrame对象,便于后续数据分析与处理。