

Python使用requests模拟浏览器发送请求的方法
本文介绍如何在Python中利用requests库模拟浏览器行为发送HTTP请求。通过构造包含User-Agent、Accept等字段的Headers字典,并配置代理服务器,可实现与真实浏览器相似的请求特征。示例展示了GET请求的完整参数设置及状态码获取方式,适用于需要规避基础反爬机制的场景。
2026-10-13
20

本文介绍如何在Python中利用requests库模拟浏览器行为发送HTTP请求。通过构造包含User-Agent、Accept等字段的Headers字典,并配置代理服务器,可实现与真实浏览器相似的请求特征。示例展示了GET请求的完整参数设置及状态码获取方式,适用于需要规避基础反爬机制的场景。
本文介绍如何在Celery 4和Django 2环境下,利用原生Celery Beat实现高效定时任务,无需依赖djcelery或django_celery_beat等第三方插件。通过配置celery.py、tasks.py及settings.py,结合Redis作为消息队列,可简化部署流程。文中详细说明了任务定义、调度策略设置、启动脚本编写及日志监控方法,强调生产环境应避免使用Root权限运行Celery,确保系统安全与稳定。
本文介绍如何在Python中利用Scipy库的插值功能对折线数据进行平滑处理。通过对比拟合与插值的区别,详细解析nearest、cubic等插值方法,并提供完整代码示例,展示如何将原始折线转化为平滑曲线,适用于数据可视化优化场景。
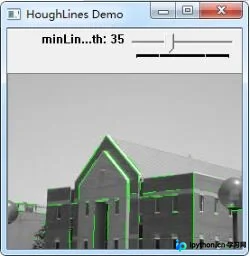
本文介绍使用Python结合OpenCV库实现霍夫变换检测直线的具体方法。通过HoughLinesP函数获取直线端点,并利用滑动条动态调整最小长度阈值,从而实现对检测线段的交互式筛选与可视化展示。
本文详解如何使用Python的xlrd库读取Excel中的时间数据。Excel存储的时间为浮点数,通过xldate_as_tuple函数可将其转换为datetime类型。文章介绍了该函数的基准日期参数设置及返回值格式,帮助开发者准确处理Excel时间字段。
本文介绍如何利用Python的xlrd库提取Excel文件中的合并单元格信息。通过调用merged_cells方法,可获取包含起始行、结束行、起始列及结束列坐标的列表。文章详细解析了坐标数组的含义,并提供了计算合并单元格实际占用行列数的公式,帮助开发者准确处理复杂表格数据。
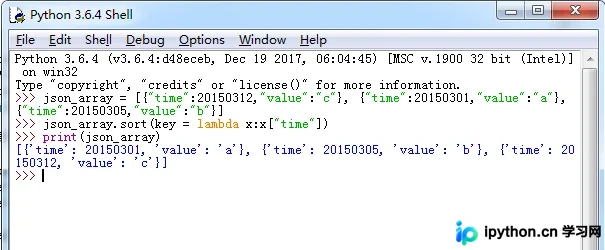
本文介绍如何使用Python对包含字典的JSON数组按指定关键字段进行排序。通过示例代码展示利用sort方法与lambda函数结合,实现按时间等字段的高效排序,并附带相关在线JSON工具推荐。
本文详细介绍如何利用Python的re模块通过正则表达式分别匹配IP地址、URL网址以及电子邮件地址。文章提供了具体的正则模式代码及测试示例,帮助开发者快速掌握网络数据格式验证的核心技巧。
本文介绍如何利用 Python 正则表达式精准匹配字符串中的 HTTP 及 HTTPS 链接。通过编译特定模式,可有效识别包含特殊字符、百分号编码及子域名的 URL。示例代码展示了从文本中提取短链接的全过程,为网络爬虫和数据清洗提供实用参考。
本文详细介绍在Python中实现xlsx、csv和json三种文件格式相互转换的方法。通过对比xlrd、pandas及标准库的不同实现方案,重点解析字符编码处理、数据读取及写入的关键步骤,并提供完整的代码示例供开发者参考。
本文介绍使用Python的xlrd库读取Excel文件时,数值类型被自动识别为浮点型的问题。通过判断单元格ctype属性,将类型为2的浮点数转换为整数再转为字符串,从而保证数据准确性。
本文详细介绍 Python 列表中获取元素值与索引的方法,包括通过下标直接取值和使用 index() 函数查找索引。同时涵盖列表的修改、追加及扩展操作,并重点解析使用 del 关键字删除列表元素的具体用法与注意事项,帮助开发者掌握列表核心操作。