Python批量修改VOC格式XML标注文件类别名称
本文介绍如何利用Python脚本批量修改VOC格式XML标注文件中的目标类别名称。通过分析XML层级结构,使用ElementTree库遍历object节点,根据预设规则批量替换name标签内容,从而节省目标检测数据标注处理时间。
2026-10-16
3

本文介绍如何利用Python脚本批量修改VOC格式XML标注文件中的目标类别名称。通过分析XML层级结构,使用ElementTree库遍历object节点,根据预设规则批量替换name标签内容,从而节省目标检测数据标注处理时间。
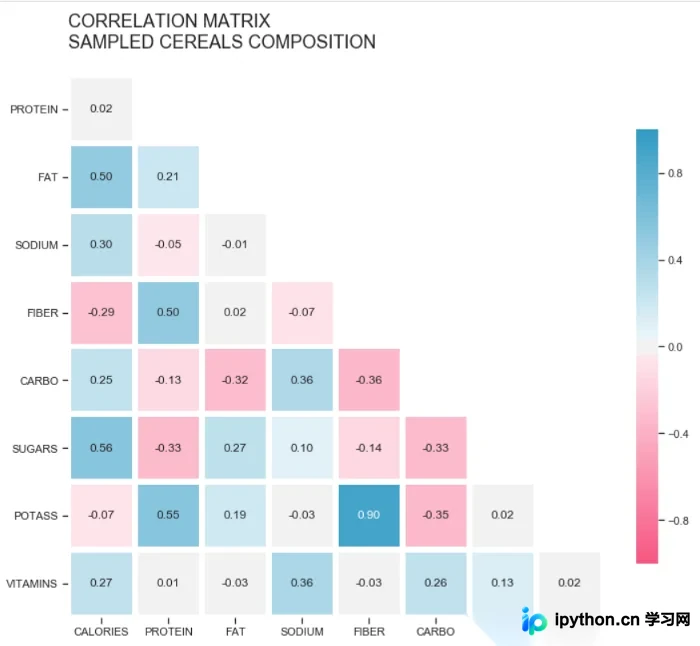
本文详细介绍如何使用Python的Seaborn库绘制高质量热力图。内容涵盖从导入Pandas和Numpy进行数据预处理开始,通过corr()计算相关性矩阵,利用Mask矩阵去除冗余上三角区域,以及调整参数显示具体数值。此外,还深入讲解了如何使用diverging_palette优化发散型调色板,提升视觉表现力,最终生成带有标题和格式优化的专业级相关性热力图。
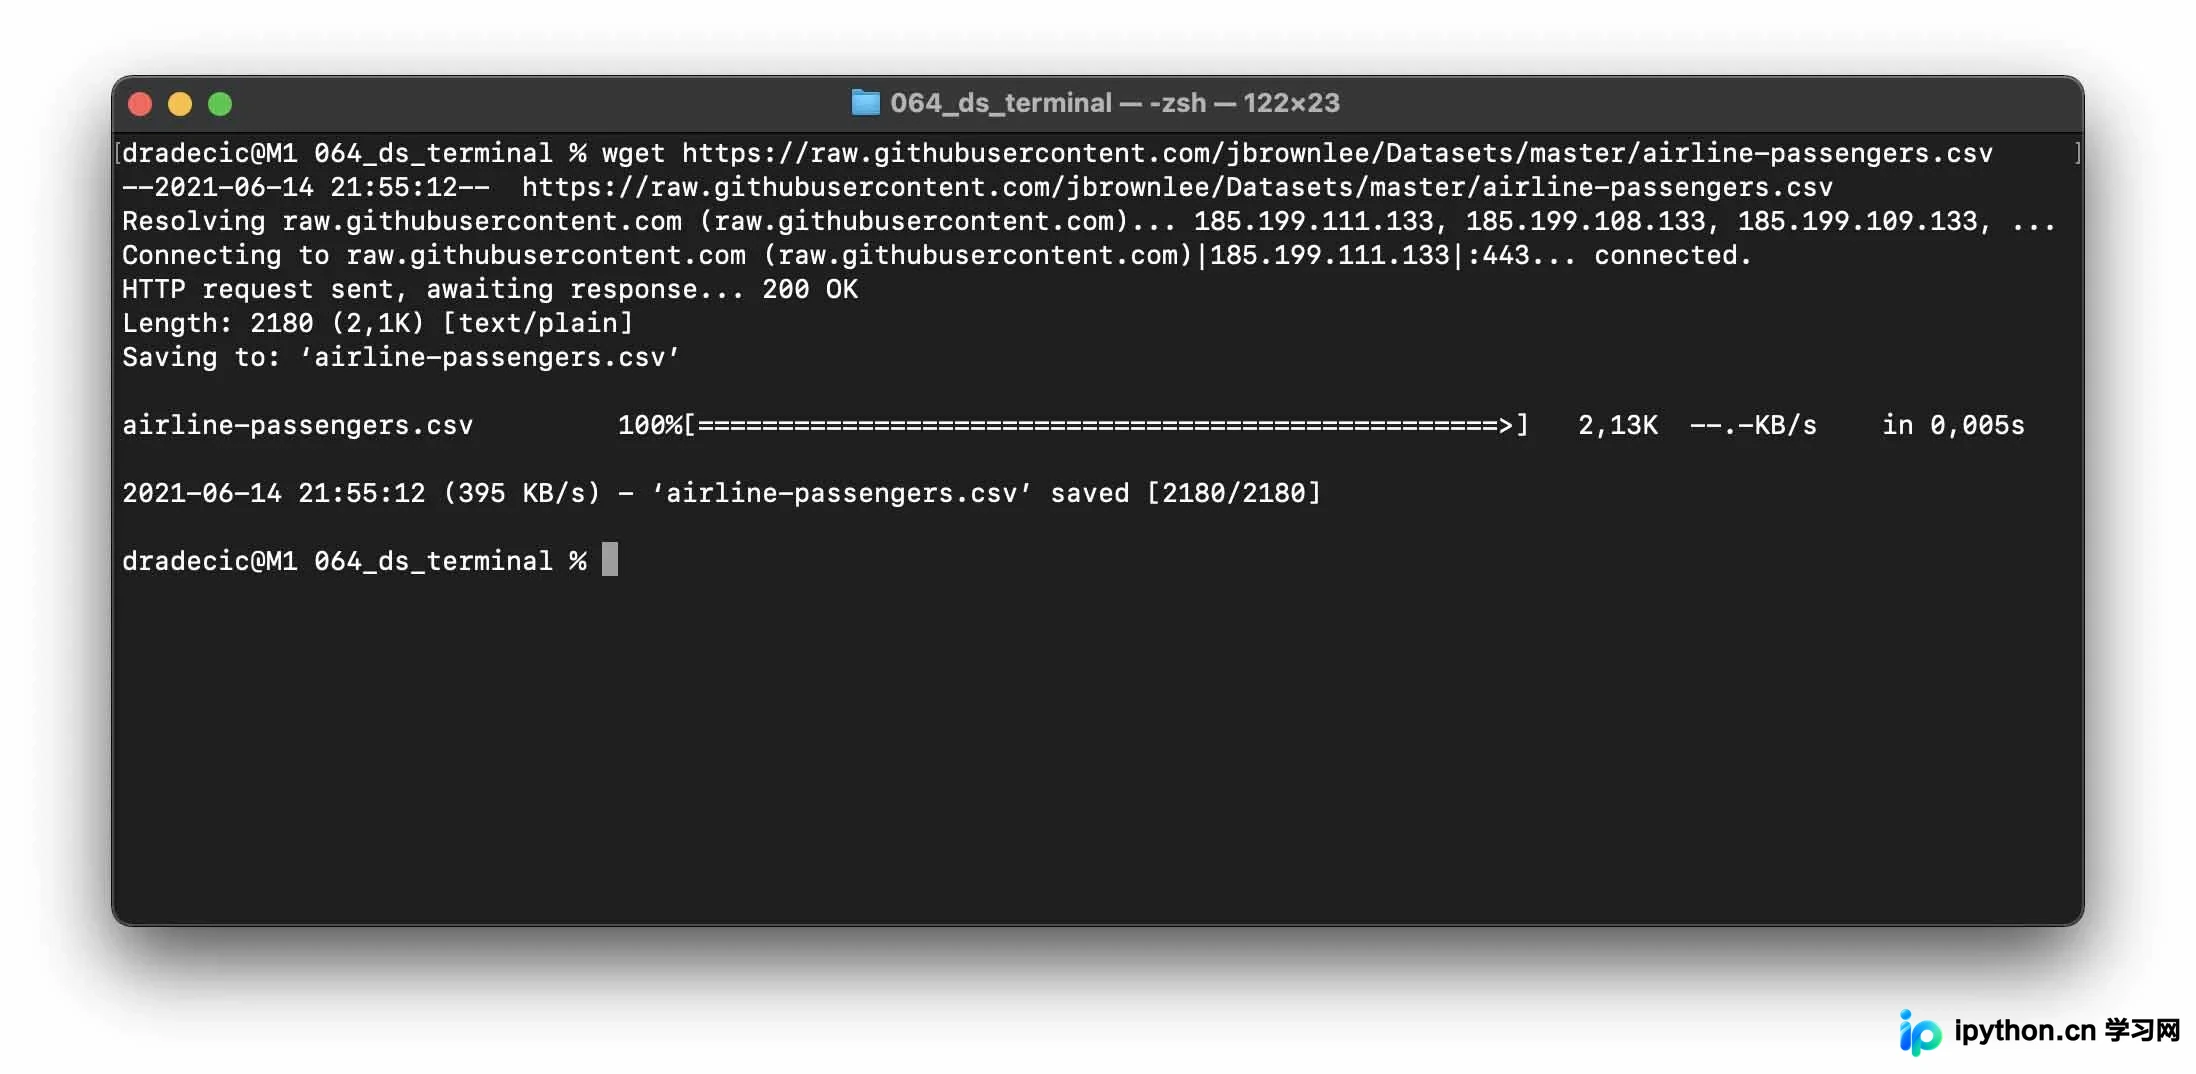
本文介绍了Python数据科学家在部署模型和处理数据管道时常用的10个终端命令。涵盖wget下载、head/tail查看文件、wc统计行数、grep筛选数据、cat查看内容、find查找文件、sort排序、nano编辑代码以及变量使用。这些基础命令能显著提升数据处理效率,是入门数据挖掘的必备技能。
本文详细解析numpy中reshape(-1,1)与reshape(1,-1)的具体用法。通过多个代码示例,说明当指定新数组shape为-1时,Numpy如何根据剩余维度自动计算。重点区分单特征数据使用reshape(-1,1)转为列向量,以及单样本数据使用reshape(1,-1)转为行向量的场景,帮助开发者准确处理数据维度。
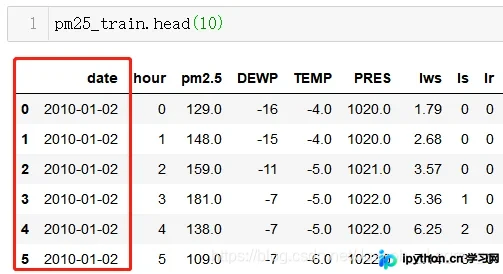
本文介绍如何在pandas中提取Timestamp对象的日期部分,以及处理非数值日期属性的方法。通过调用.date()获取纯日期,或将字符串类型的日期列拆分为年、月、日单独列,以便直接输入机器学习模型进行数据挖掘。
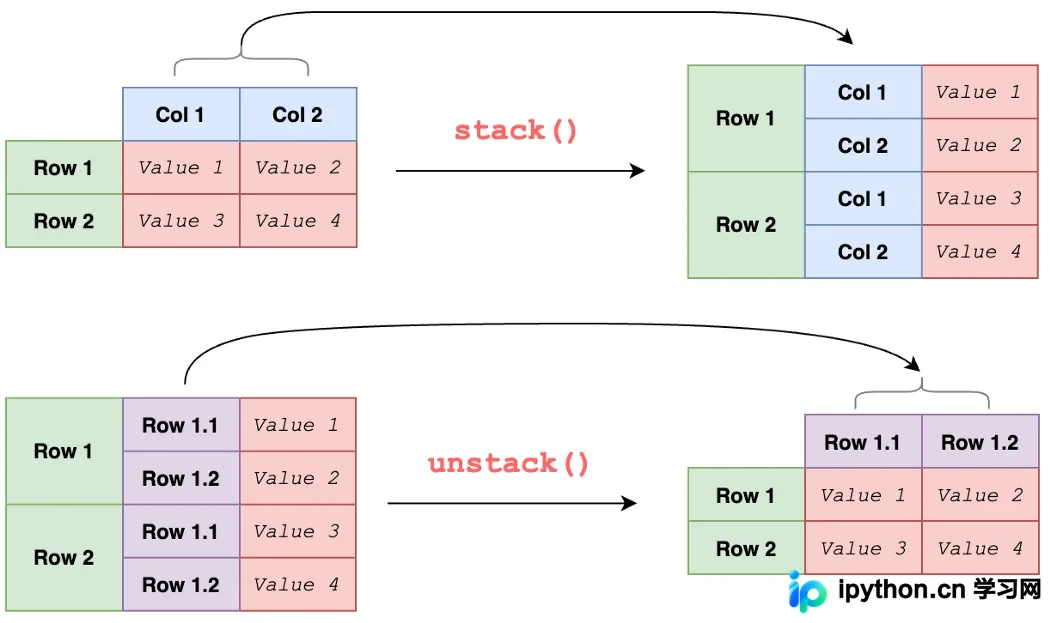
本文深入解析Pandas中stack()和unstack()函数的核心用法。通过单层与多层索引案例,展示如何处理缺失值、指定堆叠层级及链式操作,帮助开发者高效完成DataFrame的行列转换与数据预处理。
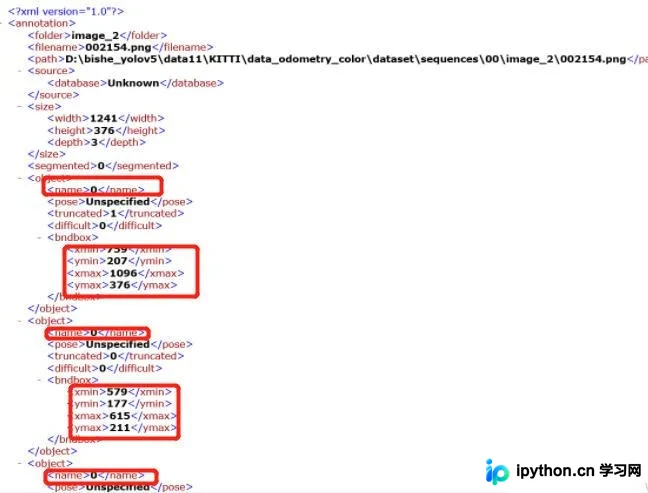
本文介绍如何利用Python将VOC数据集的XML标注文件转换为YOLO模型所需的TXT格式。通过解析XML树结构提取边界框坐标,应用归一化公式计算中心点与宽高,实现自动化批量转换,解决手动处理效率低的问题。
本文详细介绍Python中三种常用的数据归一化算法:Min-Max、Z-score及小数定标。通过公式解析、逻辑步骤与完整代码示例,阐述各方法的适用场景与局限性,帮助开发者在建模前有效消除量纲影响并提升模型精度。
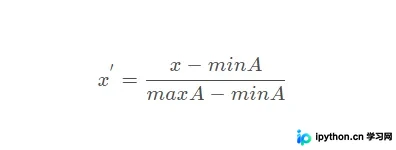
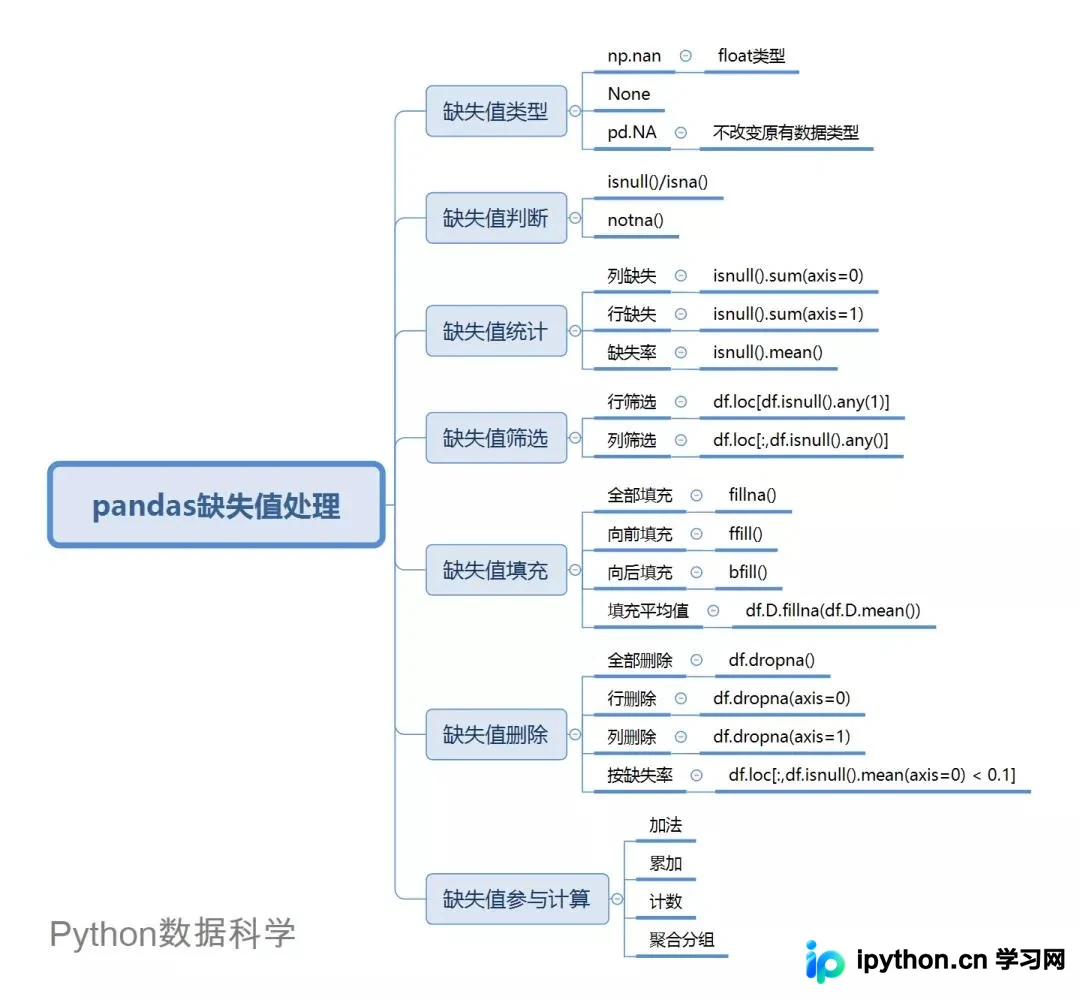
本文深入解析pandas中缺失值的三种表示形式(np.nan、None、pd.NA)及其对数据类型的影响。详细讲解isnull/isna判断、缺失率统计、基于loc的筛选方法,以及fillna填充(含ffill/bfill)、dropna删除和缺失值参与计算的逻辑,提供完整代码示例与参数说明。
本文详细介绍R语言中字符串与时间的处理技巧。涵盖format函数的digits、width等关键参数用法;区分print与cat在转义字符如换行、制表位中的显示差异;解析Sys.Date和Sys.time获取当前日期时间,并利用%Y、%m等符号自定义输出格式;最后梳理toupper、strsplit、substring等常用字符串操作函数,助力高效进行R语言数据预处理。
本文介绍在 Pandas 中快速筛选包含特定字符列的三种常用方法:利用 if 判断结合列表推导式、使用 str.contains 配合列表解析,以及调用 DataFrame 的 filter 函数。重点解析 filter 函数的 like、regex 和 item 参数,展示如何结合行与列条件进行精准数据提取,并提供完整代码示例供参考。
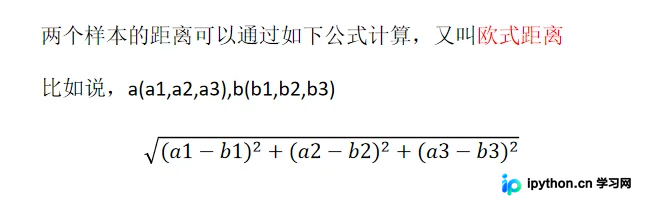
本文详解Python中K近邻算法(KNN)的核心原理、优缺点及API调用方法。通过预测酒店入住位置的完整案例,演示从数据清洗、时间特征工程、标准化到模型训练与评估的全流程,帮助开发者掌握KNN在小规模数据集上的实际应用。