Python实现英文语句单词逆序排列的简洁方案
本文介绍在Python中实现英文语句以单词为单位逆序排放的方法。通过将输入字符串按空格分割为列表,利用列表的reverse方法反转顺序,最后重新拼接为字符串。该方法仅处理英文字母与空格,适用于基础字符串逆序场景。
2026-10-13
21

本文介绍在Python中实现英文语句以单词为单位逆序排放的方法。通过将输入字符串按空格分割为列表,利用列表的reverse方法反转顺序,最后重新拼接为字符串。该方法仅处理英文字母与空格,适用于基础字符串逆序场景。
本文介绍如何在Python中从HTML的div标签中提取纯文本。通过结合使用re.compile编译正则表达式与re.sub进行替换,配合BeautifulSoup解析HTML结构,可有效去除标签符号。文中详细解析了正则编译标志及原生字符串的使用,并提供了完整的抓取与保存示例代码。
本文介绍一种使用Python实现句子倒序输出的方法。通过split分割句子,利用reverse反转单词列表,并对每个单词内部字符进行逆序拼接,最终实现单词顺序颠倒且每个单词字母也反转的效果。代码包含详细注释,适合Python初学者参考学习字符串操作技巧。
本文介绍如何使用Python将TXT文件中的多行内容合并为单行,并彻底去除中间及末尾的空格。通过readlines读取文件,利用strip()移除换行符,split()按空格分割字符串,最后使用join()重新连接。该方法适用于需要清洗文本数据格式的场景,代码简洁且高效。
本文介绍如何使用Python的urllib2库结合正则表达式,通过搜狗微信搜索接口爬取指定公众号的文章列表。教程涵盖从构建请求URL、解析HTML文本、提取JSON数据到拼接完整文章链接的完整流程,并提供可直接运行的代码示例,帮助开发者快速实现公众号文章抓取功能。
本文介绍如何使用Python读取TXT文件,并通过split()方法去除每行空格后计算实际字符长度。提供了完整的代码示例,展示如何打开文件、逐行读取、处理字符串及计算长度,最后关闭文件。适合需要处理文本数据的开发者参考。
本文介绍在 Python 中判断数字奇偶性的基本方法。通过取模运算符 % 计算除以 2 的余数,若余数为 0 则为偶数,否则为奇数。文章提供了标准实现及内嵌 if 语句的示例,并展示了具体的代码执行结果,帮助初学者快速掌握这一基础逻辑。
本文介绍如何在Python中处理包含多个不同分隔符的字符串。默认split()仅支持单一分隔符,通过引入re模块并使用正则表达式字符集,可一次性指定多个分隔符进行分割,适用于日志解析等场景。
本文详细总结了使用Python进行MySQL数据库操作的核心方法,涵盖连接建立、SQL执行、数据获取及更新删除等基础功能。通过银行转账实例演示了完整的事务控制流程,包括数据校验、金额扣减与追加,并重点展示了异常发生时的回滚机制,确保数据一致性。
本文详细介绍Django框架中基于正则表达式的URL分发机制。重点解析URL模式定义时省略前导斜杠的规范,以及使用Python原始字符串(raw string)处理反斜杠转义冲突的重要性。通过官方示例代码,展示如何正确配置年份、月份及文章详情的URL路由规则,帮助开发者避免常见的语法错误。
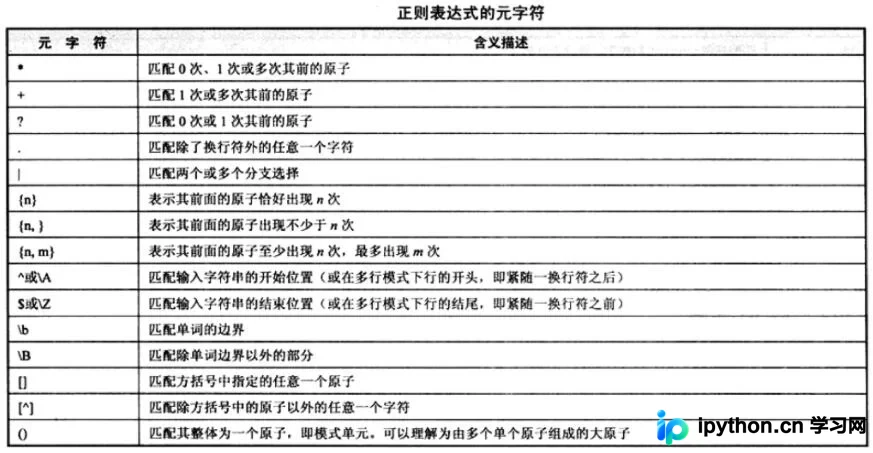
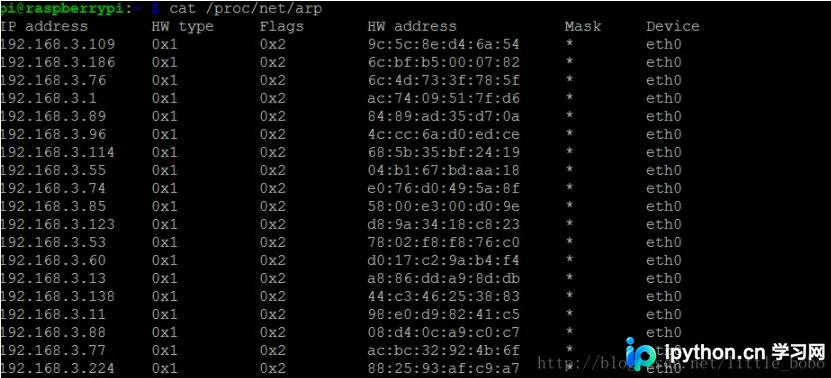
本文介绍在Python中利用正则表达式实现按多个空格分割字符串的方法。通过re.split函数配合特定模式,可有效处理包含连续空格的文本数据,并展示了从原始数据到处理结果的完整流程及代码示例。
本文详细介绍Python中BeautifulSoup库的安装方法及基础使用。通过PyCharm自动安装bs4库,并演示如何将HTML源码转换为BeautifulSoup对象。文章解析了HTML标签的层级结构,讲解如何提取title等节点信息,并对比多种属性访问方式,帮助初学者快速掌握网页数据抓取的核心技巧。