

Python基础爬虫构建教程:从urllib到BeautifulSoup实战

本文详细介绍如何使用Python构建基础爬虫架构。通过解析urllib库的网络请求功能与BeautifulSoup的HTML解析能力,演示从导入模块、打开网址到提取节点信息的完整流程。同时涵盖常见错误如HTTPError和None值的排查与处理,帮助开发者掌握基础爬虫的核心步骤与异常处理机制。
爬虫技术具备域名切换、信息收集以及数据存储的核心功能。
本节将详细讲解如何搭建基础爬虫的基本架构。
1、urllib库:该库提供了从网络请求数据、处理Cookie、修改请求头以及处理元数据的相关函数。其中,urlopen函数用于打开并读取从网络获取的远程对象,能够轻松读取HTML文件、图像文件及其他文件流。
2、beautifulsoup库:该库通过定位HTML标签来格式化和组织复杂的网络信息,并以Python对象的形式展现XML结构信息。它不属于Python标准库,需通过pip进行安装。其最常用的对象是BeautifulSoup对象。
1、基础爬虫实现
构建爬虫时,首先需要导入相关对象,然后打开目标网址,并使用BeautifulSoup对网页内容进行读取。
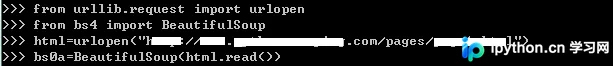
2、使用print语句输出已打开网址的内容。
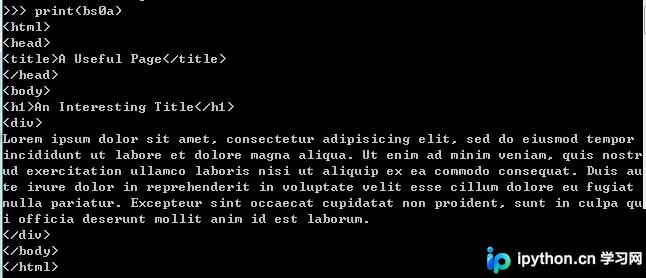
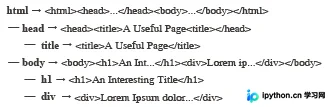
3、从输出结果中可以观察到内容的结构如下:
4、针对输出内容中html-body-h1部分的信息,可以使用四种不同的语句进行提取。
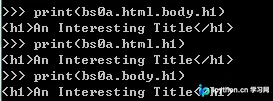
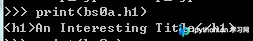
5、BeautifulSoup能够提取HTML或XML文件中任意节点的信息,只要目标信息旁边或附近存在相应的标记即可。
1、Error:在运行代码时,经常会出现错误,只有看懂错误出现的原因,才能解决存在的问题。
2、在html=urlopen('')中会发生两种错误:网页在服务器上不存在或服务器不存在。
3、当网页在服务器上不存在时,会出现HTTPError,可使用try语句进行处理。
当程序返回HTTPError错误代码时,会显示具体的错误内容。
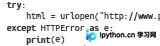
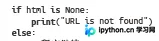
4、当服务器不存在时,urlopen会返回None。
可使用判断语句进行检测。
当调用的标签不存在时,会返回None;若调用不存在的标签下的子标签,则会出现AttributeError错误。
总结:以上就是关于Python构建基础爬虫的基础步骤内容,感谢大家的阅读和对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









